在多模态大语言模型(MLLM)飞速发展的今天,AI 已经能流畅地“看图说话”,但在像素级精准感知——即准确圈出画面中的特定物体——方面仍显笨拙。与此同时,像 SAM(Segment Anything Model)这样的基础分割模型虽能精准圈图,却听不懂复杂的自然语言指令,且往往局限于静态图像或单一模态。
- 项目主页:https://wanghao9610.github.io/X2SAM
- GitHub:https://github.com/wanghao9610/X2SAM
- 模型:https://huggingface.co/hao9610/X2SAM
中山大学、鹏城实验室和美团的研究团队联合推出了 X2SAM,一个统一的分割 MLLM 框架。它打破了图像与视频的界限,融合了语言理解与视觉分割能力,让用户只需通过文字指令或视觉点选,即可在图片或视频中精准锁定任意目标。
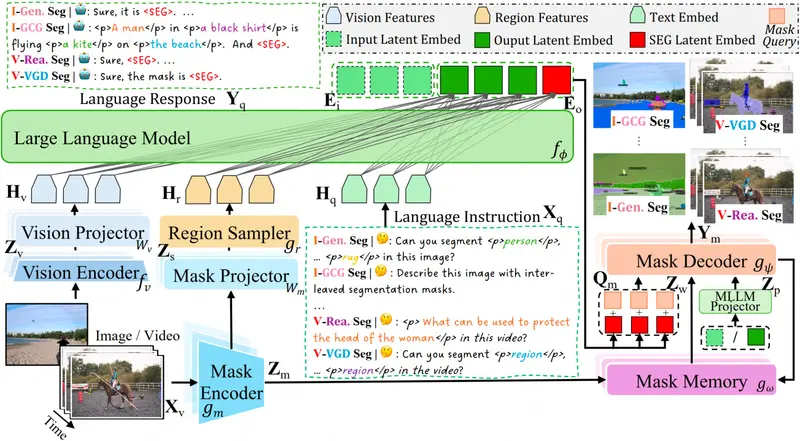
核心亮点:全能、统一、智能
1. 真正的“全能分割”全家桶
X2SAM 在一个模型中集成了七大核心分割能力,覆盖图像与视频全场景:
- 通用/开放词汇分割:无需预训练类别,圈出任何你提到的物体(如“那只奇怪的鸟”)。
- 指代分割:根据复杂描述定位目标(如“左边穿红衣服正在跑步的人”)。
- 推理分割:基于逻辑判断圈出物体(如“圈出能用来喝水的东西”)。
- 对话式分割:边聊天边圈图,AI 能理解上下文并生成对应蒙版。
- 交互式分割:支持手动点选、框选,AI 实时响应并优化分割结果。
- 视频追踪分割:在视频中持续锁定同一物体,生成时间一致的连贯掩码。
- 视觉引导分割:结合视觉提示(如参考图)进行分割。
2. 图像视频无缝统一
- 单一接口:无需切换工具,同一个模型、同一个界面处理所有视觉任务。
- 双路感知:同时提取画面整体语义信息与精细边缘细节,确保“看得清”且“认得准”。
- 聊天不降级:在强化分割能力的同时,保留了强大的图像/视频对话能力,性能甚至优于许多专用聊天模型。
3. 视频追踪更稳定:掩码记忆模块
针对视频分割中常见的“跟丢”或“闪烁”问题,X2SAM 引入了创新的 掩码记忆模块 (Mask Memory Module):
- 特征存储:将前几帧识别到的目标视觉特征存入记忆库。
- 时序引导:后续帧利用记忆中的特征进行引导,确保物体在运动、遮挡或光照变化下仍能被精准锁定。
- 结果:生成的视频掩码具有极高的时间一致性,大幅优于 SAM2 等在文字指令场景下的表现。
工作原理:四步实现精准圈选
- 双路编码:视觉编码器分别提取全局语义特征和局部细节特征。
- 指令融合:将用户的文字指令(如“圈出猫”)或视觉提示(如点击坐标)输入 LLM,理解用户意图。
- 记忆增强:对于视频任务,LLM 调用掩码记忆模块,获取历史帧的目标特征,形成时序关联。
- 掩码生成:解码器结合语言指令、视觉特征和记忆信息,生成精准的像素级掩码,并输出自然语言回复。
性能表现:全面领先
研究团队在多个权威基准测试中验证了 X2SAM 的卓越性能:
- 图像分割:在常规、指代、推理分割任务上,达到主流模型顶尖水平。
- 视频分割:在视频指代分割、视频推理分割等新设基准上,大幅超越现有视频专用模型。
- 泛化能力:对未见过的物体和新颖的描述方式具有极强的适应能力。
- 多模态对话:在保持高精度分割的同时,图像/视频问答能力依然强劲。
适用场景
- 智能视频编辑:一键移除视频背景、替换特定物体、自动追踪主角添加特效。
- 自动驾驶与机器人:精准识别并追踪道路上的行人、车辆或障碍物,理解复杂指令(如“避开那个穿黄衣服的人”)。
- 医疗影像分析:医生通过自然语言指示 AI 圈出病灶区域,辅助诊断。
- 电商与零售:用户上传商品图,AI 自动分割商品主体,生成透明背景图或推荐搭配。
- 内容创作与教育:交互式教学视频,学生点击屏幕任意物体,AI 即时讲解并高亮显示。
© 版权声明
文章版权归作者所有,未经允许请勿转载。