在文生图领域,传统模型往往依赖复杂的流水线:独立的文本编码器(如 CLIP/T5)、潜空间压缩器(VAE)以及扩散主干网络。北京智象未来发布了 HiDream-O1-Image,一款革命性的原生统一图像生成基础模型。它构建于像素级统一 Transformer 之上,彻底摒弃了外部 VAE 和独立文本编码器,在单个共享 Token 空间中原生编码原始像素、文本及任务条件。
- GitHub:https://github.com/HiDream-ai/HiDream-O1-Image
- HiDream-O1-Image-Dev:https://huggingface.co/HiDream-ai/HiDream-O1-Image-Dev
- HiDream-O1-Image:https://huggingface.co/HiDream-ai/HiDream-O1-Image
- Demo:https://huggingface.co/spaces/HiDream-ai/HiDream-O1-Image
尽管仅拥有 8B 参数,HiDream-O1-Image 在多项权威基准测试中不仅持平,更在关键指标上超越了参数量大数倍的 FLUX.2、Qwen-Image 甚至闭源的 GPT Image 系列,展现了极高的效率与多功能性。
核心亮点:极简架构,极致性能
1. 原生像素级统一 Transformer
- 端到端建模:无需 VAE 进行潜空间压缩,无需独立文本编码器处理提示词。所有输入(文本、像素、条件)均在同一 Transformer 架构中处理。
- 简化管线:大幅降低系统复杂度,减少模块间的信息损耗与对齐误差,提升训练与推理效率。
2. 推理驱动的提示代理 (Prompt Agent)
- 深度理解:内置基于 Gemma-4-31B-it 的“思考”代理,在生成前显式推理布局、主体属性、物理逻辑及文本渲染细节。
- 提示重写:将用户简短或模糊的指令重写为结构清晰、自包含的英文提示词,显著提升复杂场景下的出图质量。
- 输出结构化:生成包含
prompt、reasoning和resolved_knowledge的 JSON,让生成过程可解释、可控。
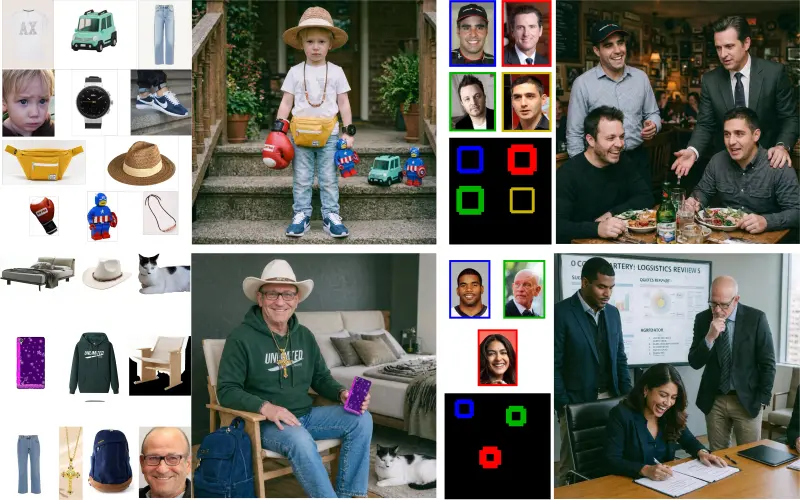
3. 原生高分辨率与多任务集成
- 2048×2048 直出:支持直接合成高达 2048×2048 分辨率的图像,保留清晰的细粒度细节,无需后期超分。
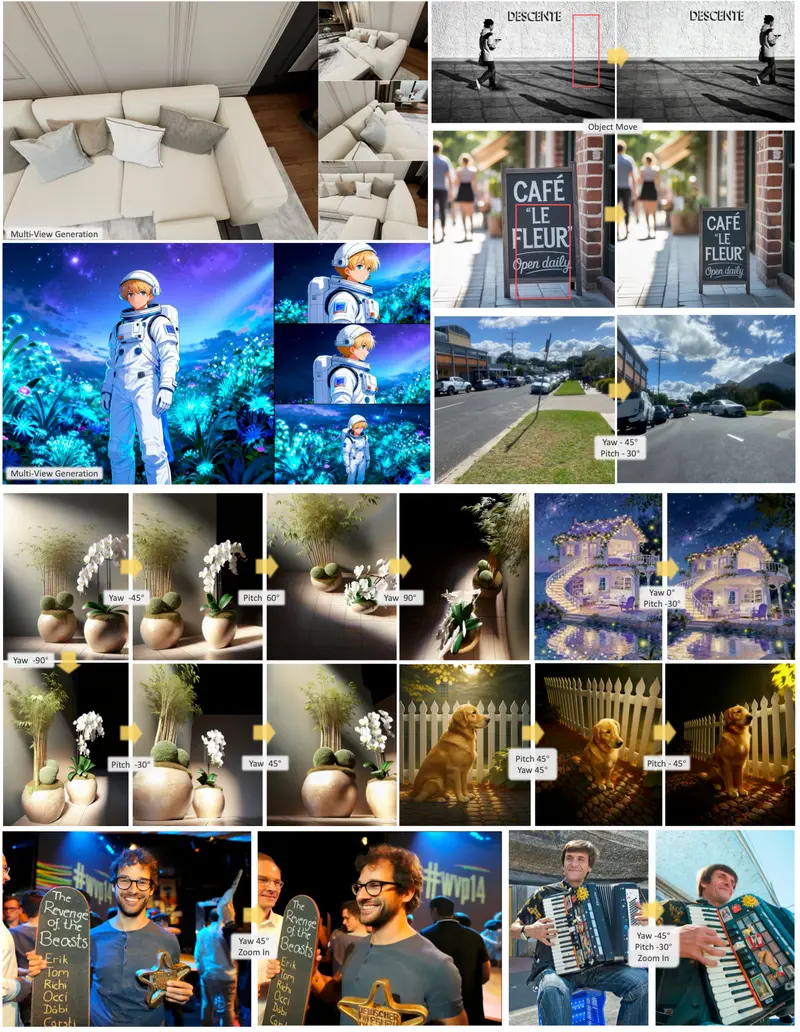
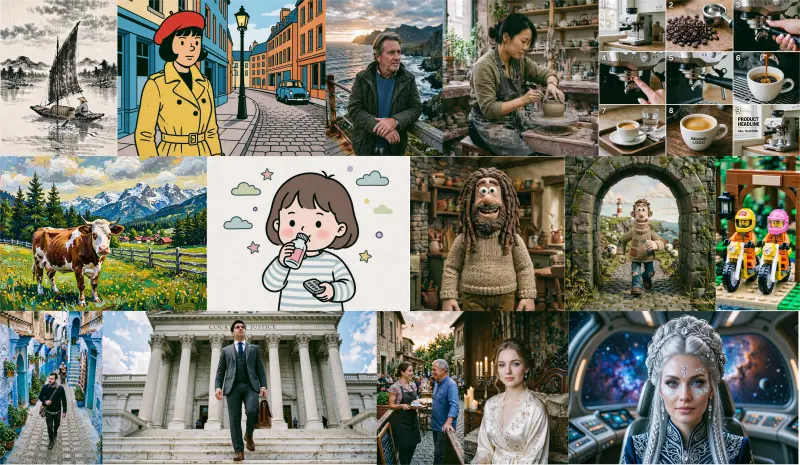
- 全能任务:单一模型支持文生图、长文本渲染、指令编辑、主体驱动个性化生成及故事板生成,无需切换模型。
4. 8B 参数的高效奇迹
- 轻量高效:仅 8B 参数,推理资源需求远低于 FLUX.2 (56B+) 或 Qwen-Image (27B+),更适合本地部署与快速迭代。
- 性能越级:在组合生成、密集提示对齐、人类偏好等维度,表现优于众多数十亿甚至百亿参数模型。
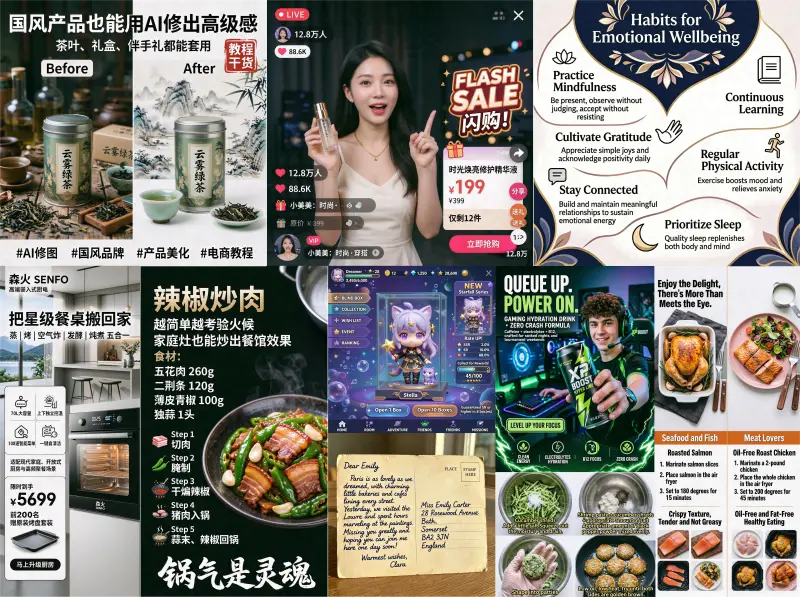
基准测试:全面领先的主流模型杀手
HiDream-O1-Image 在五大权威评测套件中与 SOTA 模型进行了激烈角逐,结果令人瞩目:
1. GenEval — 组合生成能力
| 模型 | 参数量 | Overall |
|---|---|---|
| FLUX.2 [Dev] | 56B+ | 0.87 |
| Qwen-Image | 27B+ | 0.87 |
| HiDream-O1-Image | 8B | 0.90 🏆 |
| HiDream-O1-Image-Pro | 200B+ | 0.92 |
解读:在对象计数、位置关系、属性绑定等复杂组合任务中,8B 的 HiDream-O1-Image 击败了参数量大 7 倍的 FLUX.2。
2. DPG-Bench — 密集提示对齐
| 模型 | 参数量 | Overall |
|---|---|---|
| FLUX.2 [Dev] | 56B+ | 87.57 |
| Qwen-Image | 27B+ | 88.32 |
| HiDream-O1-Image | 8B | 89.83 🏆 |
解读:面对包含大量实体、属性和关系的复杂长提示,HiDream-O1-Image 展现出极强的指令遵循能力。
3. CVTG-2K — 复杂视觉文本生成
| 模型 | 参数量 | Average Score |
|---|---|---|
| FLUX.2 [Dev] | 56B+ | 0.8926 |
| Z-Image-Turbo | 10B+ | 0.8585 |
| HiDream-O1-Image | 8B | 0.9128 🏆 |
解读:在图像中生成准确、可读的多区域文字方面,HiDream-O1-Image 表现卓越,NED 得分高达 0.9561。
4. LongText-Bench — 长文本渲染
| 模型 | 参数量 | EN Score | ZH Score |
|---|---|---|---|
| FLUX.2 [Dev] | 56B+ | 0.963 | 0.757 |
| Qwen-Image | 27B+ | 0.943 | 0.946 |
| HiDream-O1-Image | 8B | 0.979 | 0.978 🏆 |
解读:无论是英文还是中文长文本渲染,HiDream-O1-Image 均取得最高分,证明了其原生统一架构在处理多语言文本嵌入上的巨大优势。
5. HPSv3 — 人类偏好评分
| 模型 | 参数量 | All Categories |
|---|---|---|
| GPT Image 2 | – | 10.21 |
| Qwen-Image | 27B+ | 9.94 |
| HiDream-O1-Image | 8B | 10.37 🏆 |
解读:在涵盖人物、艺术、设计、自然等 12 个类别的人类偏好评估中,HiDream-O1-Image 获得了最高平均分,审美水平备受认可。
🛠️ 快速开始
1. 模型获取
HiDream-O1-Image 已在 HuggingFace 开放权重:
- HiDream-O1-Image: 🤗 HiDream-O1-Image (50 步推理,标准版)
- HiDream-O1-Image-Dev: 🤗 HiDream-O1-Image-Dev (28 步推理,加速版)
- Prompt Agent: 基于
google/gemma-4-31B-it
2. 本地推理
git clone https://github.com/HiDream-AI/HiDream-O1-Image.git
cd HiDream-O1-Image

# 安装依赖
pip install -r requirements.txt

# 运行文生图
python inference.py --prompt "A cyberpunk city at night, neon lights, rain" --steps 50

# 使用 Prompt Agent 优化复杂提示
python prompt_agent.py --prompt "Draw a cat wearing a hat, sitting on a mat, with a ball nearby" --backend gemma
3. Web Demo
python app.py
# 访问 http://127.0.0.1:7860
💡 适用场景
- 高精度图文设计:海报、Logo、名片等需要精准文字渲染的场景。
- 复杂指令创作:包含多个主体、复杂空间关系和属性描述的详细画面生成。
- 本地化部署:8B 参数量使得在消费级高端显卡(如 RTX 4090)上进行本地推理成为可能。
- 个性化角色生成:通过主体驱动功能,保持角色一致性进行多场景创作。
- 故事板制作:利用交错生成能力,快速构建连环画或分镜脚本。
© 版权声明
文章版权归作者所有,未经允许请勿转载。