微软正式推出 Lens,一款仅拥有 38 亿(3.8B)参数的基础文本到图像(T2I)生成模型。在主流大模型参数量动辄达到 6B 甚至 80B 的今天,Lens 证明了“小而美”的可能性:它通过极致的训练效率优化,以远低于竞品的算力成本,实现了匹敌甚至超越 SOTA 模型的生成质量,并支持高达 1440×1440 分辨率的快速推理。
- GitHub:https://github.com/microsoft/Lens
- 模型:https://huggingface.co/microsoft/Lens
- Demo:https://huggingface.co/spaces/multimodalart/lens
核心突破:为何 Lens 能“以小博大”?
Lens 的成功并非偶然,而是源于其在数据增效、架构选优、后训练对齐、推理加速四大模块的系统性创新。
1. 极致提升数据信息密度
- Lens-800M 密集字幕数据集:构建了包含 8 亿图像-文本对的高质量数据集。所有字幕均由 GPT-4.1 生成,平均长度达 109 词,涵盖物体、属性、空间关系、动作等丰富语义。消融实验证明,密集字幕显著提升了模型的学习效率和生成质量。
- 混合分辨率训练:采用 512²、768²、1024² 三级分辨率及 9 种宽高比(1:2 至 2:1)进行混合训练。这使得模型在推理时能零泛化适配任意宽高比,并支持最高 1440² 的高清输出,无需额外的高分辨率微调。
2. 精选架构加速收敛
- FLUX.2 语义 VAE:相比传统 VAE,FLUX.2 VAE 提供了更语义化的隐空间,显著加速了收敛过程并提升了生成细节。
- GPT-OSS 语言编码器:选用激活参数仅 3B 的 GPT-OSS(20B MoE)作为文本编码器。它不仅带来了更快的收敛速度和更强的 Prompt 遵循能力,还实现了仅用英文训练即可多语言泛化(中/法/日/西)的神奇效果。
- MMDiT 主干网络:采用流匹配(Flow Matching)目标训练,并通过拼接 GPT-OSS 的多层特征,增强了文本与图像的对齐能力。
3. RL 对齐提升画质与一致性
- Lens-RL-8K 数据集:基于分类学驱动构建的 8406 条高质量提示词,覆盖人物、场景、文本等 10 大类。
- 规则化奖励(Rubric Reward):利用 GPT-4.1-mini 作为奖励模型,基于 DiffusionNFT 进行强化学习(RL)优化。通过细粒度评估规则(如数量、颜色、位置、OCR 准确性),有效抑制了瑕疵,提升了物理合理性和文字渲染能力。
4. 推理加速:4 步极速生成
- Lens-Turbo 蒸馏版:基于 DMD2 + decoupled-DMD + SenseFlow 技术蒸馏而成。
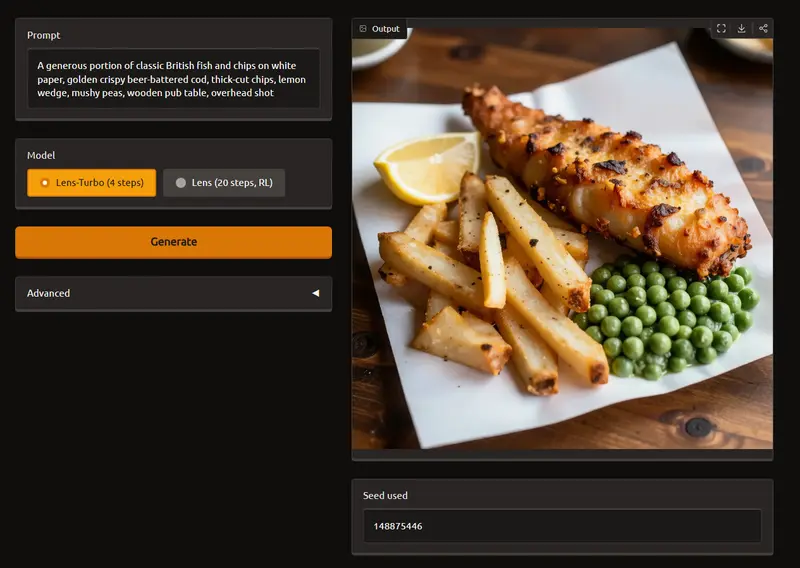
- 性能飞跃:在 H100 GPU 上,生成 1024² 图像仅需 4 步,耗时从原版的 3.15 秒降至 0.84 秒,速度提升近 4 倍,且画质几乎无损失。
性能实测:全面领先同级模型
在多个权威基准测试中,Lens 展现了卓越的性价比和竞争力:
| 基准测试 | Lens (3.8B) | Z-Image (6B) | Qwen-Image (20B) | 备注 |
|---|---|---|---|---|
| OneIG | 0.557 | 0.546 | 0.539 | 综合图像质量 |
| GenEval | 0.930 | – | 0.868 | 生成评估指标 |
| LongText | 0.937 | 0.935 | 0.943 | 长文本遵循能力 |
| CVTG (文字) | 0.869 | – | – | 开源模型第一 |
- 算力效率:相比 Z-Image (6B),Lens 仅使用了 19.3% 的训练算力,却取得了持平甚至更优的性能。
- 多语言能力:尽管仅使用英文数据训练,Lens 在中文、法语、日语等语言上的表现依然出色,证明了其强大的泛化能力。
模型版本与使用指南
微软提供了三个版本的检查点,满足不同场景需求:
| 模型仓库 ID | 描述 | 推荐步数 | CFG | 适用场景 |
|---|---|---|---|---|
microsoft/Lens | 默认版:经过 RL 调优,视觉质量最佳 | 20 | 5.0 | 追求最高画质的通用场景 |
microsoft/Lens-Turbo | 极速版:蒸馏模型,支持 4 步快速采样 | 4 | 1.0 | 实时交互、批量生成、视频帧生成 |
microsoft/Lens-Base | 基础版:监督预训练模型 | 50 | 5.0 | 学术研究、进一步微调基座 |
局限性
尽管表现优异,Lens 仍存在一些局限:
- 非英语文字渲染:虽然支持多语言泛化,但非英语文字(如中文汉字)的渲染精度仍略逊于英文。
- 复杂构图瑕疵:在极罕见物体或极度复杂的空间关系场景中,偶尔会出现逻辑错误。
- 依赖泛化而非专门训练:多语言能力主要源于模型泛化,未来可通过引入更多多语言数据进行专项优化。
© 版权声明
文章版权归作者所有,未经允许请勿转载。