BAR (Branch-Adapt-Route) 是由 Allen Institute for AI (Ai2) 提出的一种创新的后训练框架。它旨在解决大型语言模型在预训练后,难以低成本、低风险地添加新能力或更新特定领域知识的问题。
- 官方介绍:https://allenai.org/blog/bar
- GitHub:https://github.com/allenai/FlexOlmo/blob/jacobm-flex-post-train/scripts/BAR/bar_scripts.md
- 模型:https://huggingface.co/collections/allenai/branch-adapt-route
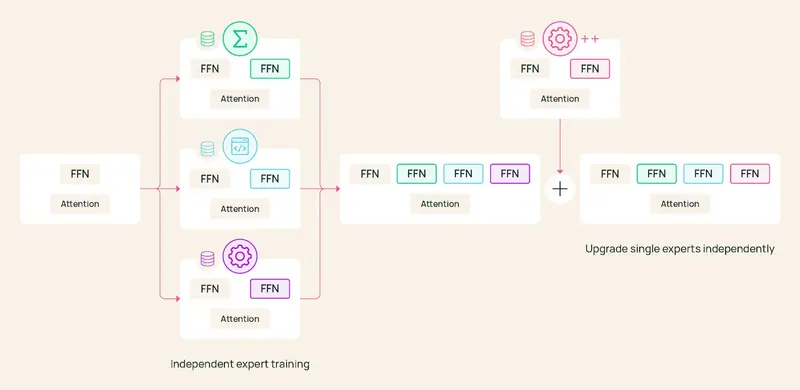
传统的后训练方法通常需要在所有数据上重新训练整个模型,或者在持续微调中面临“灾难性遗忘”的风险。BAR 通过分别训练独立的领域专家,然后将它们合并到一个统一的混合专家(MoE)架构中,实现了模块化的能力扩展与升级。
核心痛点与解决方案
传统方法的局限
- 从头重训成本高:需要访问原始训练数据和算力,成本极其高昂。
- 持续微调易遗忘:在新数据上直接训练容易导致模型丢失原有能力(如指令遵循、通用知识)。
- 多阶段调整复杂:后训练通常包含 SFT、RLVR 等多个阶段,添加新技能需重新调整整个流水线以平衡各阶段成果。
BAR 的模块化思路
BAR 将模型视为一组独立开发的领域专家(如数学、代码、工具使用、安全),每个专家经历完整的独立训练流程,最后通过 MoE 架构组合。这使得每个专家可以独立升级、替换或添加,而无需触动其他部分。
BAR 的工作原理:三阶段流程
阶段 1:独立专家训练 (Branch & Adapt)
每个领域专家被实例化为一个双专家 MoE 结构:
- 锚点专家 (Anchor):冻结的基础模型 FFN 权重,用于保留基础能力。
- 可训练专家:针对特定领域进行训练。
关键技术:渐进解冻调度 (Progressive Unfreezing)
由于后训练涉及行为转变(如新格式、推理模式),仅更新 FFN 是不够的。BAR 根据训练阶段动态解冻共享参数:
- 中间训练 (Intermediate Training):冻结所有共享层(类似预训练,主要更新知识表征)。
- 监督微调 (SFT):解冻嵌入层和语言建模头。这对于引入新特殊标记(如工具调用的函数格式)至关重要。实验显示,不解冻会导致工具使用得分从 46.4 跌至 20.3。
- 强化学习 (RLVR):解冻所有共享参数(包括注意力层)。因为 RL 引起的分布变化超出了 FFN 的容纳范围。
重要发现:专家必须在领域特定数据与通用 SFT 数据的混合集上训练。仅使用领域数据会严重损害通用指令遵循能力。
阶段 2:专家合并 (Merge)
训练完成后,将所有专家合并到一个统一的 MoE 模型中。
- 共享参数处理:对于在 SFT 或 RLVR 期间发生分歧的共享参数(如注意力权重),直接取平均值。
- 效果:这种简单的平均化在特定领域评估中引入的性能损失微乎其微,且远优于直接合并稠密模型(后者会导致模型几乎不可用)。
阶段 3:路由器训练 (Route)
最后,在冻结所有专家权重的前提下,训练 MoE 的路由器 (Router)。
- 低成本:仅需使用 SFT 数据的 5% 分层样本即可实现有效路由。
- 快速迭代:这一阶段计算成本极低,便于快速调整路由策略。
性能表现与对比
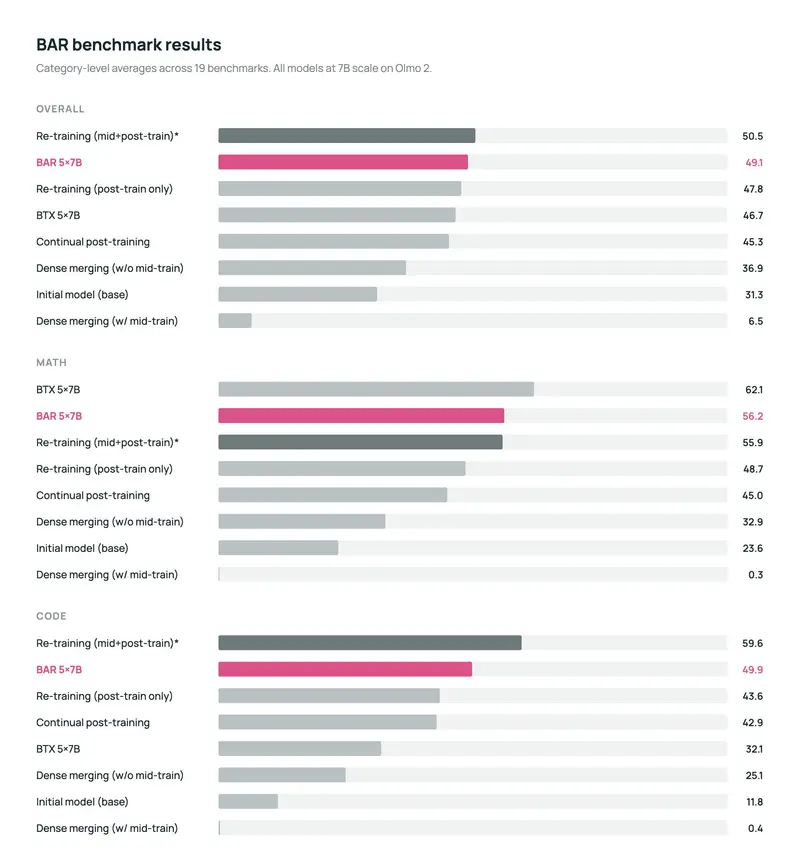
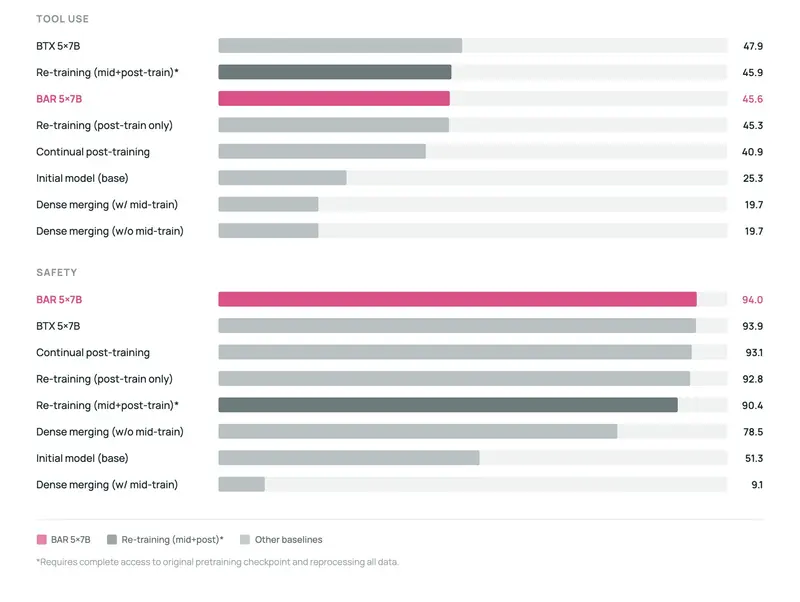
BAR 在 Olmo 2 (7B+) 基础模型上进行了验证,涵盖数学、代码、工具使用和安全四个领域专家。
| 方法 | 总体得分 (Avg) | 特点/局限 |
|---|---|---|
| 完整重训 (Upper Bound) | 50.5 | 性能上限,但成本极高,需原始数据。 |
| BAR (本文方法) | 49.1 | 优于所有非重训基线。模块化避免了对抗干扰。 |
| BTX (独立稠密模型) | 46.7 | 无共享参数训练导致分歧大,路由困难。 |
| 稠密模型合并 | 36.9 / 6.5* | *若含中间训练则灾难性失败 (6.5)。 |
关键优势:
- 数学 (+7.8) 和代码 (+4.7) 提升显著,因为模块化隔离了不同领域 RL 阶段的相互干扰。
- 避免灾难性遗忘:数学和代码的后期 RL 不会削弱早期 SFT 学到的安全能力。
模块化升级:BAR 的核心价值
BAR 最实用的特性在于支持低成本、独立的能力升级:
- 升级数据:替换为更高质量数据训练的代码专家 → 代码性能 +16.5,其他领域不变。
- 添加阶段:为现有数学专家增加 RL 阶段 → 数学性能 +13,其他领域影响最小。
成本对比:
- BAR:升级成本呈线性增长(仅重训受影响专家 + 轻量路由器)。
- 单体模型:升级成本呈二次方增长(任何领域更新都需重训全模型)。
经验总结与展望
- 后训练比预训练更需要灵活性:冻结所有共享层的预训练策略在后训练中失效,渐进解冻(特别是注意力和嵌入层)是关键。
- 通用数据混合不可或缺:纯领域训练会破坏通用能力,必须混合通用 SFT 数据。
- 权重平均 surprisingly effective:即使共享参数在训练中发散,简单平均仍能保持高性能。
- 路由冗余:推理时激活 5 个专家中的 4 个与激活全部 5 个性能相当,暗示存在更高效的路由优化空间。
未来方向:
目前 BAR 是基于稠密模型“回收”改造的。下一步自然是从原生稀疏架构开始设计,以进一步提升模块化方法的效率和可扩展性。
© 版权声明
文章版权归作者所有,未经允许请勿转载。