阿里云通义千问团队正式宣布开源 Qwen3.6-35B-A3B。这是一款基于混合专家(MoE)架构的高效大语言模型,总参数量为 350亿,但在推理时仅激活 30亿 参数。凭借极高的参数效率,它在智能体编程(Agentic Coding)、多模态推理及通用任务处理上实现了重大突破,不仅大幅超越前代 Qwen3.5-35B-A3B,更在多项基准测试中比肩甚至超越 Qwen3.5-27B、Gemma-31B 等更大规模的稠密模型。
- 官方介绍:https://qwen.ai/blog?id=qwen3.6-35b-a3b
- Hugging Face:https://huggingface.co/Qwen/Qwen3.6-35B-A3B
- ModelScope:https://modelscope.cn/models/Qwen/Qwen3.6-35B-A3B
核心亮点
1. 卓越的智能体编程能力
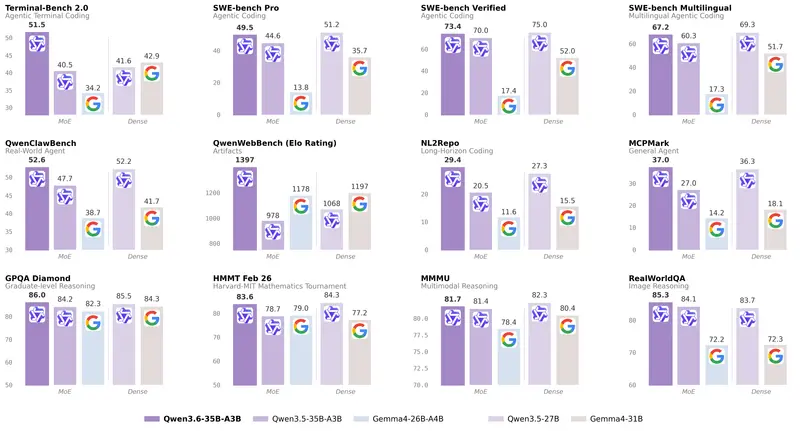
- 越级挑战:仅凭 30 亿激活参数,在 SWE-bench、LiveCodeBench 等关键编程基准上,性能超越 270 亿参数的稠密模型 Qwen3.5-27B。
- Agent 优化:针对代码生成、调试、多步任务规划进行了深度优化,能够无缝集成到 OpenClaw、Claude Code 和 Qwen Code 等主流 AI 编程助手中,提供具备上下文感知的高效编码体验。
- 思维链保留:支持
preserve_thinking功能,可在多轮对话中保留完整的思维过程,显著提升复杂逻辑推理和长程任务执行的稳定性。
2. 强大的多模态感知与推理
- 原生多模态:支持图像、文本混合输入,具备“思考”与“非思考”双模式切换能力。
- 空间智能优势:在视觉定位与理解任务中表现优异,RefCOCO 得分高达 92.0,ODInW13 得分 50.8,在多数视觉语言基准上与 Claude Sonnet 4.5 持平甚至反超。
- 通用性强:不仅是代码专家,更是通用的多模态助手,适用于文档分析、图表解读及复杂视觉推理场景。
3. 极致高效与低成本
- MoE 架构优势:35B 总参数 / 3B 激活参数的设计,使其在保持高性能的同时,推理速度极快,显存占用极低。
- 部署友好:可在消费级显卡(如 RTX 3090/4090)上流畅运行,大幅降低了企业和开发者部署高性能 Agent 模型的门槛。
模型表现对比
| 维度 | Qwen3.6-35B-A3B 表现 | 对比参考 |
|---|---|---|
| 编程能力 | 大幅超越 Qwen3.5-35B-A3B | 优于 Qwen3.5-27B (稠密) |
| 多模态推理 | RefCOCO: 92.0, ODInW13: 50.8 | 持平/超越 Claude Sonnet 4.5 |
| 推理效率 | 仅激活 3B 参数 | 速度远超同规模稠密模型 |
| 通用能力 | 支持多模态思考/非思考模式 | 当前最具通用性的开源 MoE 之一 |
如何开始使用?
1. 在线体验与 API 调用
- Qwen Studio:现已上线,可直接进行交互对话体验。
- 阿里云百炼:即将以
qwen3.6-flash的名称提供 API 服务。- 兼容 OpenAI 规范(Chat Completions & Responses API)。
- 兼容 Anthropic API 接口。
- 支持
preserve_thinking参数,推荐用于智能体任务。
2. 本地部署(开源权重)
模型权重已完全开源,支持本地私有化部署:
- Hugging Face: Qwen/Qwen3.6-35B-A3B
- ModelScope: Qwen/Qwen3.6-35B-A3B
3. 集成到 AI 编程助手
Qwen3.6-35B-A3B 已针对主流 Agent 框架进行适配:
OpenClaw (原 Moltbot/Clawdbot)
- 连接方式:将 OpenClaw 配置指向阿里云百炼 API。
- 体验:在终端中获得完整的智能体编码体验,支持文件操作、命令执行及多步任务自动规划。
Claude Code & Qwen Code
- 无缝集成:通过配置自定义模型端点,即可在 VS Code 或 Cursor 等编辑器中调用 Qwen3.6-35B-A3B,享受低延迟、高智能的代码补全与重构建议。
© 版权声明
文章版权归作者所有,未经允许请勿转载。