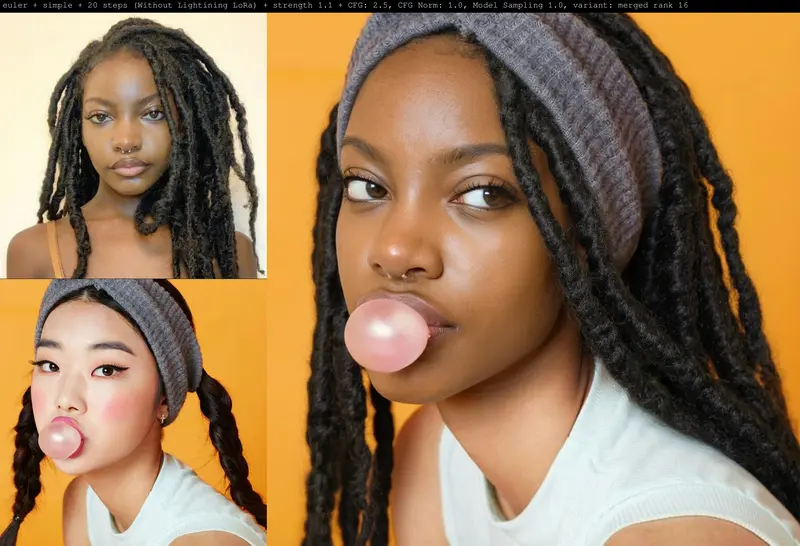ClipProj-MiniMax-H3 MiniMax H3 的视频生成能力很强,但它的文本编码器(Qwen3-VL-32B)是个“显存杀手”,光这一项就要吃掉 15.7 GB 显存。ClipProj 提供了一个巧妙的解决方案:通过一个学习到的线性投影矩阵,让只有 40 亿参数的 Qwen3-VL-4B 也能产出符合 H3 要求的条件控制张量。
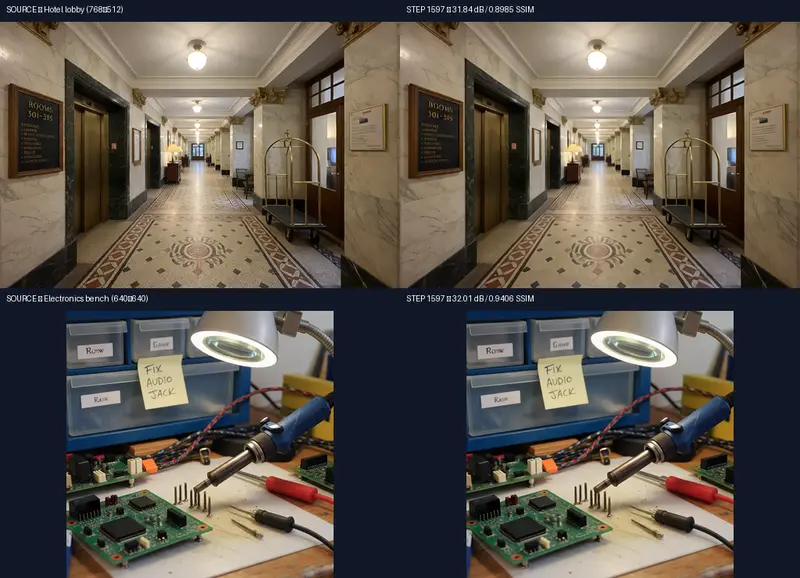
MiniMax-H3-Image-VAE MiniMax H3 的默认 VAE 是为视频设计的,处理单张图像时往往需要凑够时间维度,流程比较繁琐。MiniMax H3 single-image VAE 是一个实验性的专用检查点,它能直接把单个时间步(T=1)的 H3 隐空间解码成一张完整的图片。
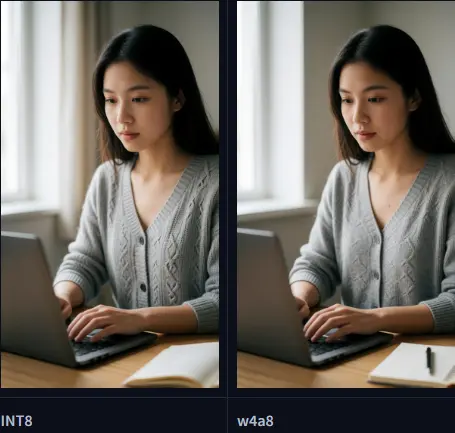
Rebels W4A8 Collection Rebels W4A8 是一套专为 ComfyUI 优化的扩散与视频模型量化合集,采用 W4A8(4-bit权重 + 8-bit运算) 格式,实现约 0.56字节/参数 的存储与计算密度。其核心优势在于利用 ComfyUI 原生 asym_w4a8_int8 路径,由 int8 张量核心直接执行矩阵乘法,无需反量化回fp16,区别于GGUF等仅压缩存储但运行时解压的方案。
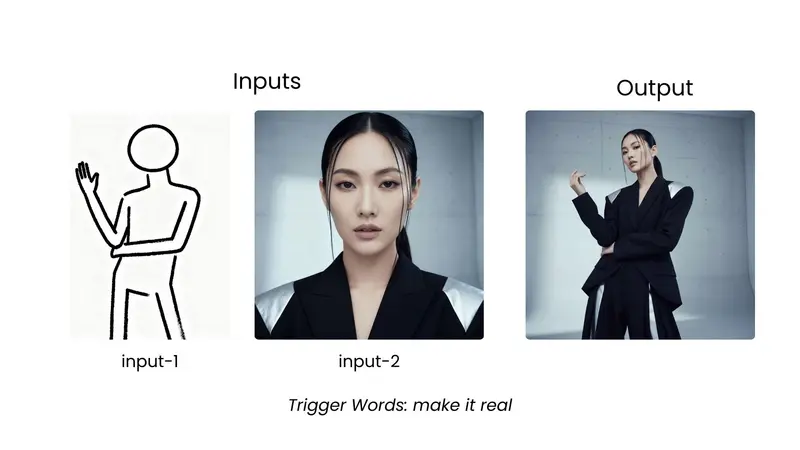
Draw2Photo Draw2Photo LoRA 是一款基于 Qwen-Image-Edit-2511 模型的Lora,这款 LoRA 能够将一张简单的儿童素描与一张真实的人脸照片结合,生成一张既保留画作创意结构、又拥有逼真质感和人物身份的高清照片。
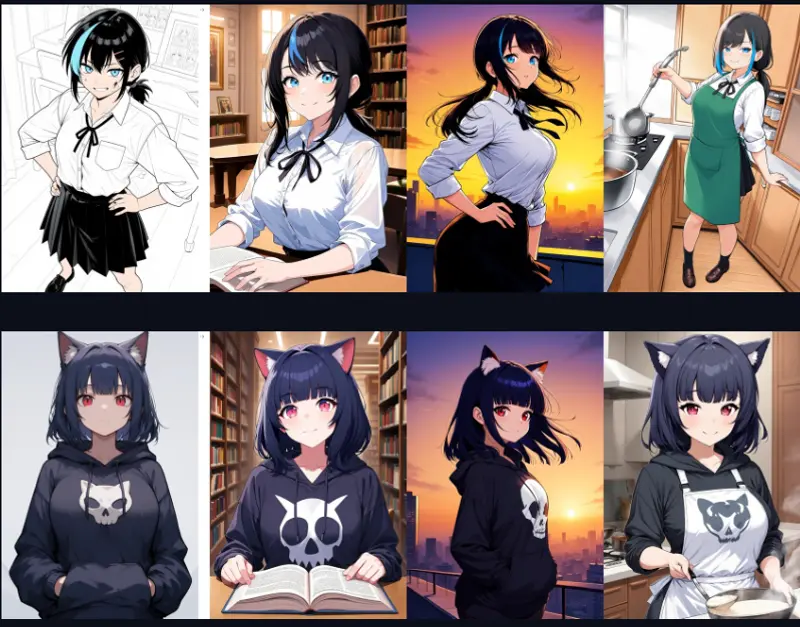
MOSS-Image CharRef CharRef v2 是MOSS-Image生态里实用性很强的角色固定方案,依托KV缓存参考编辑路线,省去逐个角色微调LoRA的成本,非常适合漫画、二次元角色跨场景生成;短板集中在写实人脸、精细发型、单参考限制。
Any Ball AnyBall LoRA 是一个小巧但富有表现力的风格化Lora,用一个简单触发词 an1ball,就能快速进入独特的视觉世界,兼具趣味性与实用性,适合内容创作者、设计师和 AI 艺术探索者。
H3-Latent-Upscaler-2x 在处理 MiniMax H3 视频时,传统的放大流程是“VAE 解码 → 像素缩放 → VAE 重编码”,这不仅耗时,还会引入额外的画质损失。H3-Latent-Upscaler-2x 提供了一种纯隐空间的解决方案,它能直接将干净的视频隐空间映射到 2 倍大的空间网格上,全程不触碰像素域。
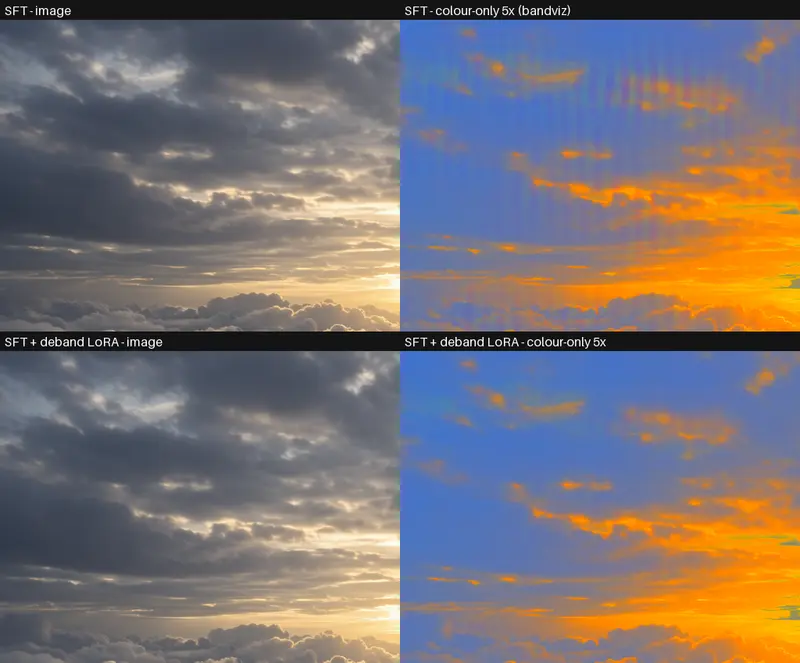
sft-destripe 1.9MB的SFT Destripe LoRA依靠权重方向提取而非训练制作,专门消除MOSS-Image SFT在平滑背景产生的垂直色带,几乎保留原有图像风格,在ComfyUI只需简单加载即可使用。
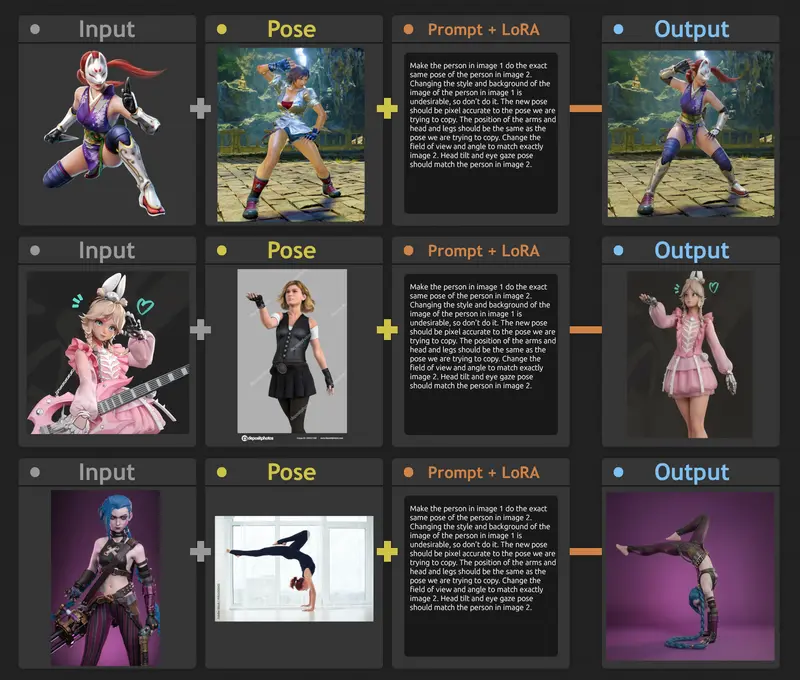
AnyPose AnyPose专为 Qwen Image Edit 2511 Lightning LoRA 设计,无需 ControlNet,无需骨骼图,仅凭一张参考图 + 简单提示词,即可让目标角色精准复刻任意姿势。
Qwen Image 2.1 Consistency LoRA Qwen Image 2.1 Consistency LoRA 是专为解决 Qwen Image 2.1 编辑时“内容漂移”和“非目标区域重绘”问题而训练的轻量级LoRA。
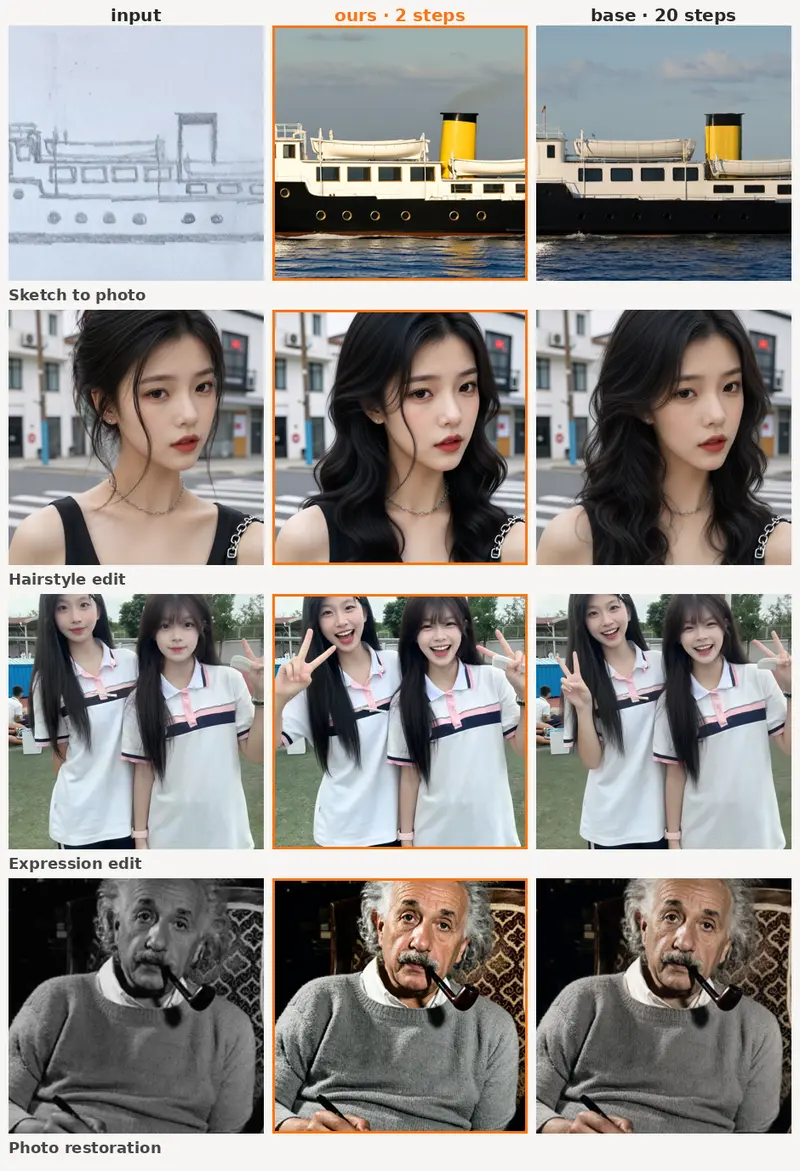
Qwen-Image-2.1-DMD2-2steps DMD2 蒸馏 LoRA 给 Qwen-Image-2.1 做两步加速,仅注意力层微调;在大幅减少采样步数的前提下,文生图和图像编辑效果贴近原版 20 步模型,主打交互式实时绘图。
Smartphone Snapshot Photo Reality Smartphone Snapshot Photo Reality 是一款专为 FLUX.2-klein-base-9B 模型设计的 LoRA,它旨在打破这种完美主义,生成看起来像是用 三星 Galaxy A52 智能手机随意拍摄的、充满真实感的日常快照。
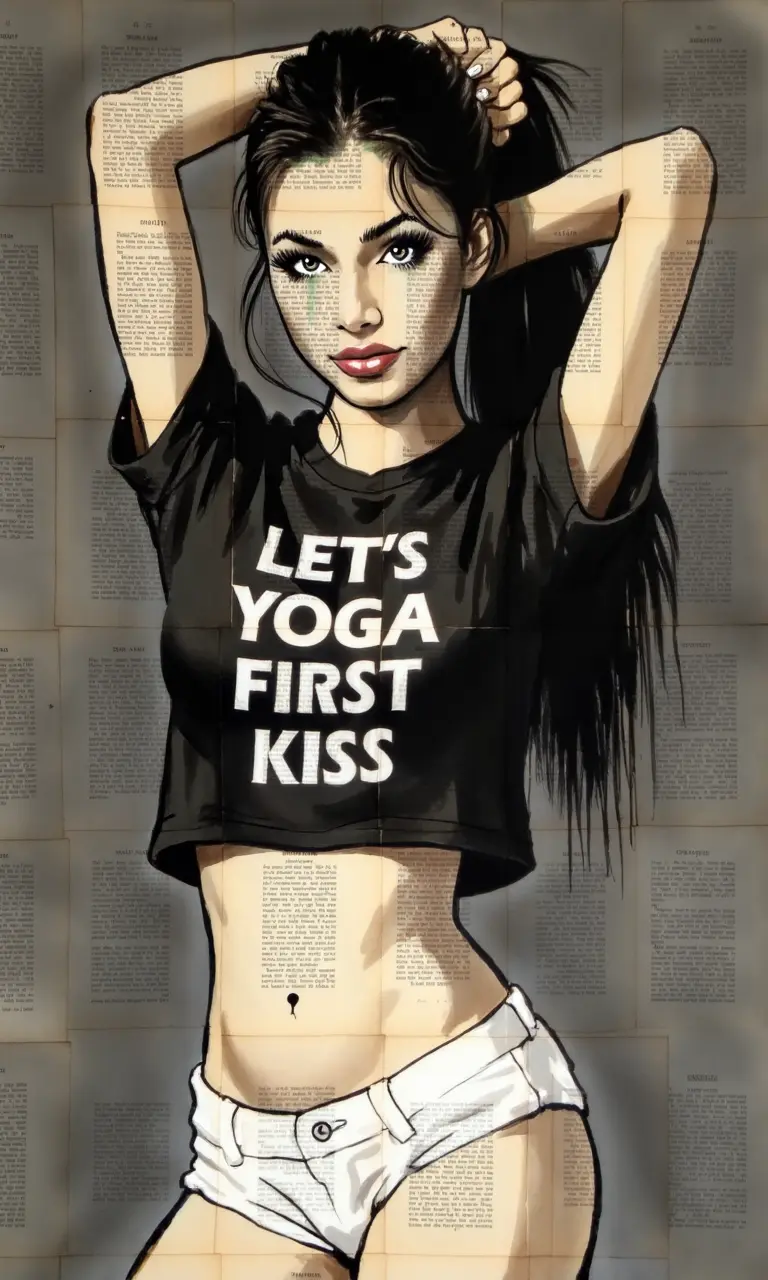
Paint & Print Paint & Print是一款墨水、纸张与表达的融合的Flux LoRA,其灵感来源于一种独特的艺术技法,该技法使用印刷媒体(如旧书、乐谱、报纸、地图)作为画布。这种艺术作品尊重并融合了底层的印刷内容,而不是完全覆盖它,使部分印刷材料隐约可见,将其融入作品中,而不仅仅是作为背景。
Edit Anything Edit Anything 是一组基于 LTX-2.3 模型构建的实验性 LoRA,旨在探索视频内容的精细化编辑能力。该套件包含三个独立的训练轨迹,分别针对运动迁移、无参考多任务编辑以及参考图像驱动的视频到视频转换。
Relighting Kontext Dev LoRA Relighting Kontext Dev LoRA v3 是一款功能强大且实用的图像重新照明模型,尤其适合需要快速调整光影效果的用户。无论是专业设计师、摄影师还是普通爱好者,都可以通过它轻松实现高质量的图像重新照明效果。
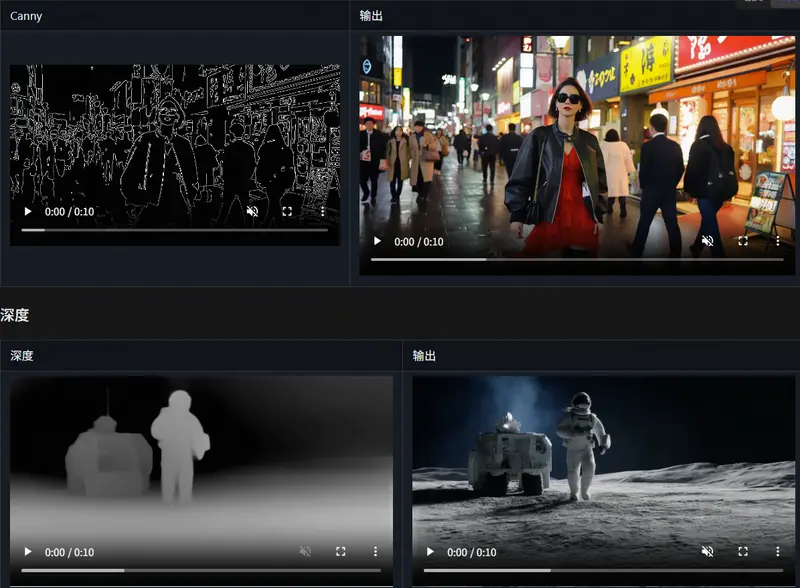
MiniMax-H3-Fun-Controlnet-Union MiniMax-H3-Fun-Controlnet-Union 是一个用于 MiniMax-H3 的 ControlNet-Union 模型,使用 VideoX-Fun 流水线训练而成。单个检查点可使 MiniMax-H3 视频生成器根据 Canny、Depth、HED、MLSD 或 Pose 控制视频进行条件生成,同时也支持视频修复(inpainting)。
BFS (Best Face Swap) BFS (Best Face Swap) 是一套专为 Qwen Image Edit (2509/2511) 和 Flux 2 Klein (4b/9b) 模型设计的 LoRA 集合。它旨在实现极高保真度的面部替换与完整的头部转移,同时确保肤色自然融合、光照一致以及解剖结构的合理性。
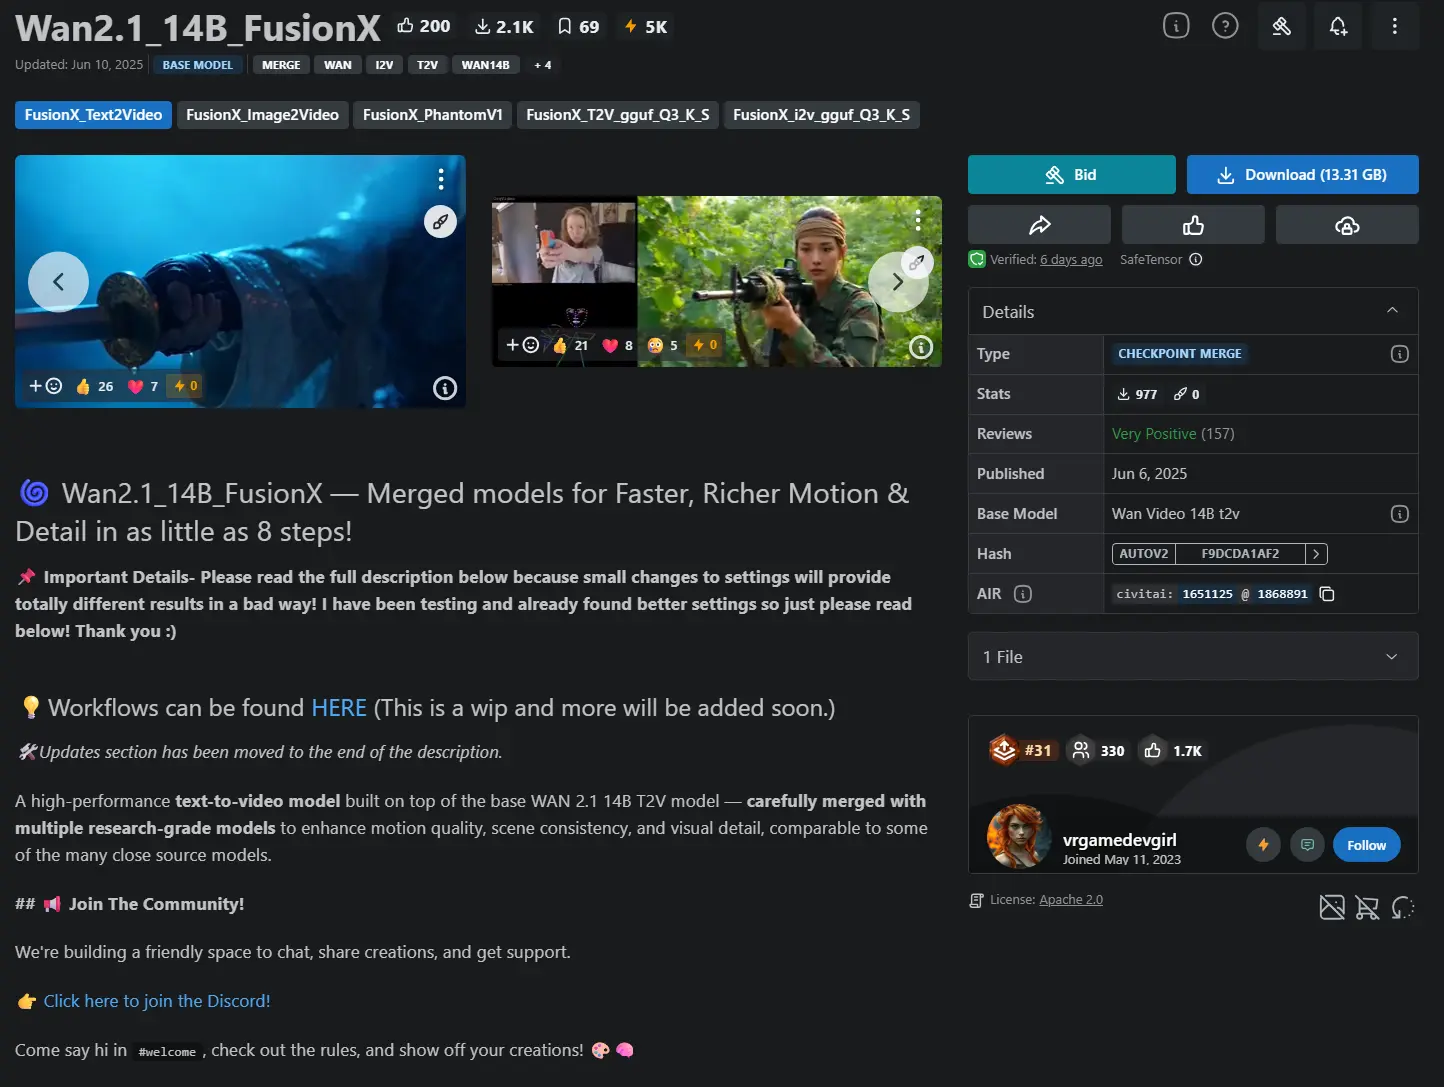
Wan2.1_14B_FusionX Wan2.1_14B_FusionX 是一款基于Wan2.1的融合模型,实现更快、更丰富的运动与细节,最少仅需8个步骤!它不仅提升了生成效率,还在细节表现、运动质量和风格多样性方面做了深度优化,是目前最接近“电影级 AI 视频”的开源模型之一。
TaoMate-H3 TaoMate-H3 是阿里巴巴 TaoLive AIGC 团队开发的低延迟流式音视频生成运行时,底层基于 MiniMax H3,以小块分片形式同步生成音频与视频,支持 480p、768p、1080p 横竖屏分辨率的长连续视频生成。
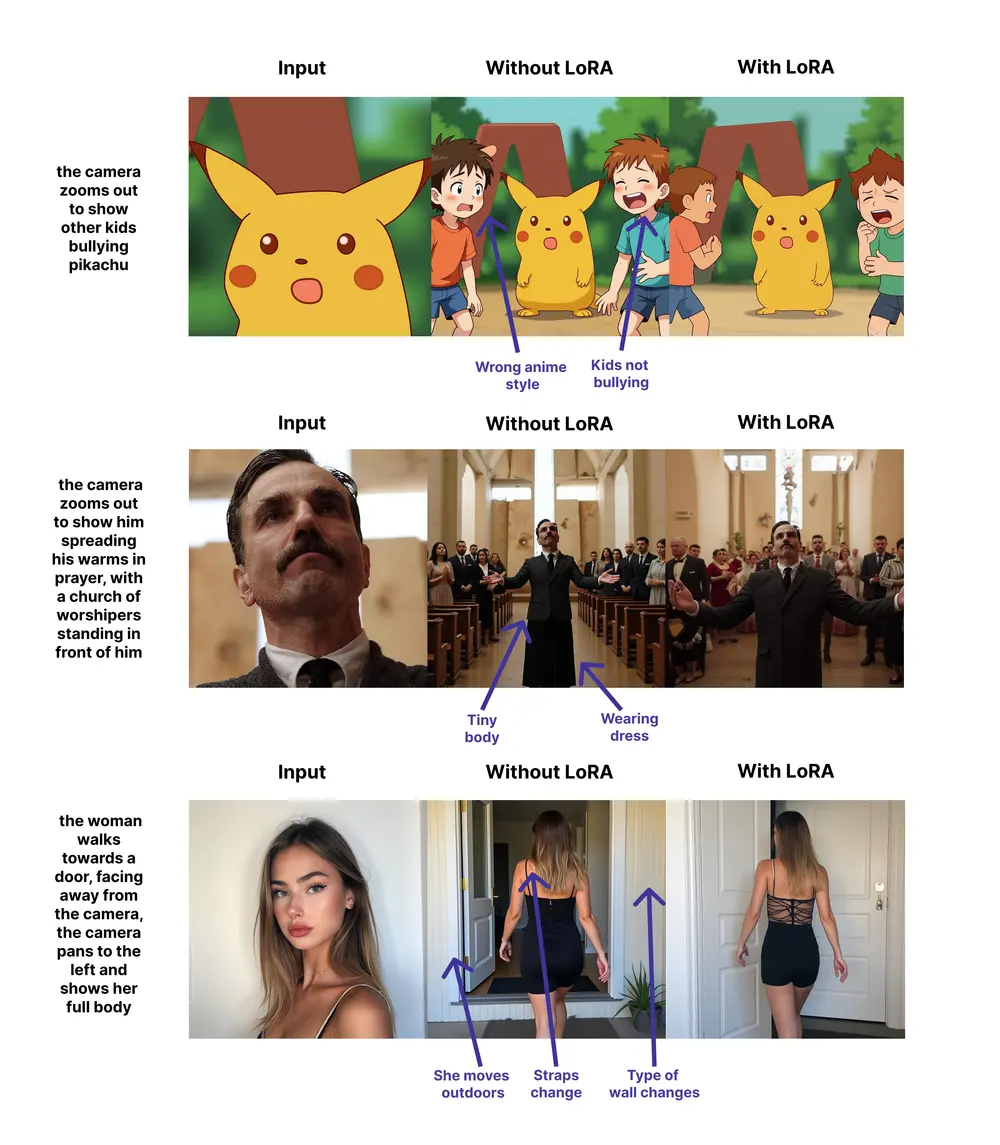
InScene InScene 是一个为 Flux.1-Kontext.dev 设计的 LoRA,旨在生成与源图像保持场景一致性的图像。它基于 Flux.1-Kontext.dev 进行训练。主要用途是生成镜头变体,同时保持背景、整体环境、角色和风格不变。