MOSS-Image-Edit-HQ
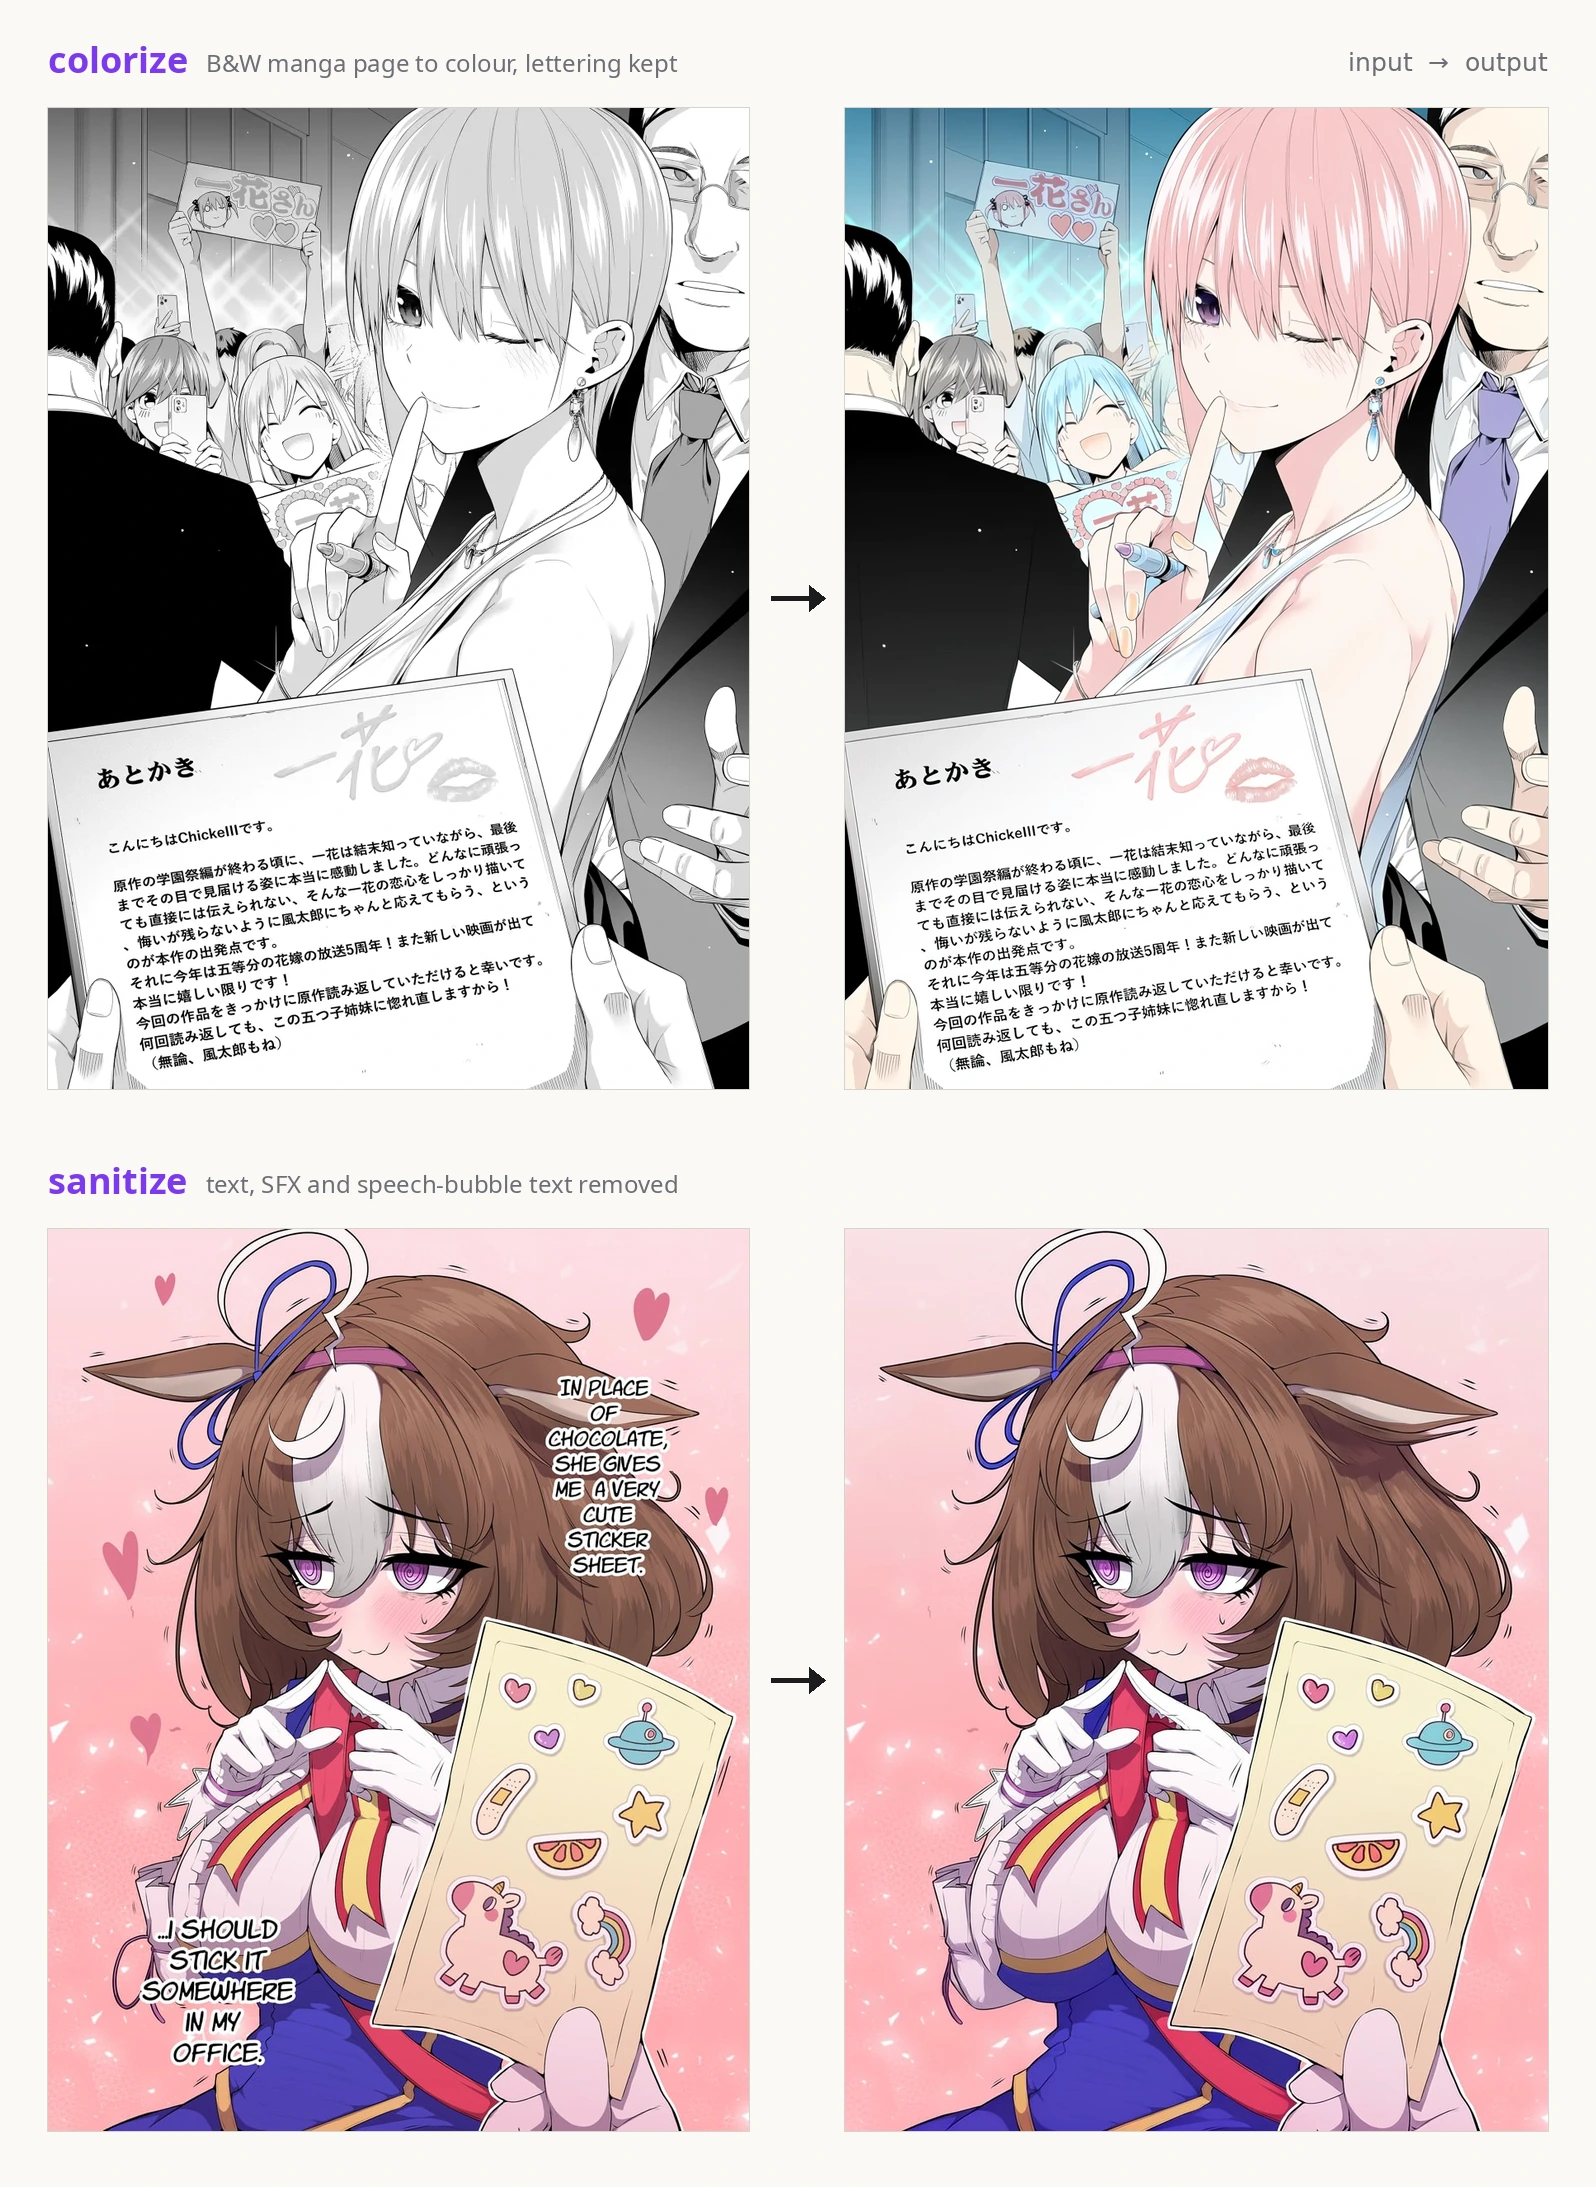
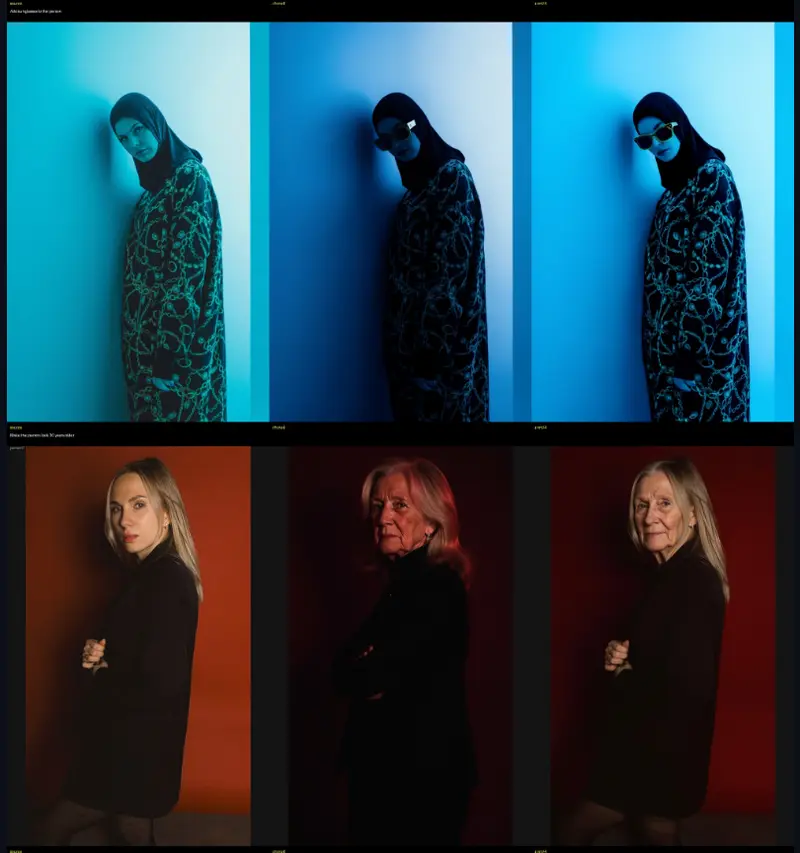
MOSS-Image-Edit-HQ armV4 是 MOSS-Image-SFT 社区图像编辑 LoRA,依靠掩码损失解决旧版全局色彩漂移问题,面部编辑明显变强;同时提供原生 ComfyUI 和插件两种接入格式,适合做局部改写、光影重绘,但显存开销较高,不兼容 Base 系列模型。
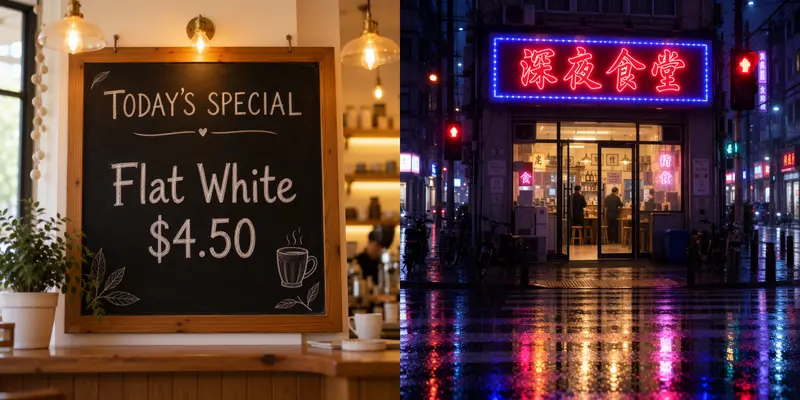
MOSS-Image-SFT-4-steps v2.0 完成重大改版,精简为单个 LoRA 文件,原生适配标准 Euler 采样器,无需额外自定义组件。它支持 4 步快速出图,中英文字、数字保真度在同类型少步模型中表现突出,最高支持 2048×2048 无平铺生成。
MOSS-Image-SFT-4-steps 是MOSS-Image 4 步加速lora,其最新的 v2.0 版本(2026年10月18日发布)进行了重大架构简化,目前已成为 Euler 原生模型。
这意味着用户只需加载单个 lora.safetensors 文件,即可在任何标准的 LoRA 加载器中,配合库存的流匹配 Euler 采样器运行。
该模型通过数据空间 DMD 蒸馏技术,从 8 步模型热启动,实现了在保持高画质的同时大幅降低推理步数。
要获得最佳体验,建议使用 2026 年 10 月 16 日之后更新的 ComfyUI 版本,以确保 Load CLIP 节点支持 moss_image 类型。
部署需下载以下 4 个文件并放入对应目录:
moss_image_sft_bf16.safetensors (10 GB) 放入 models/diffusion_models/qwen3.5_9b_int8_convrot.safetensors (10 GB) 放入 models/text_encoders/flux2-vae.safetensors (0.3 GB) 放入 models/vae/moss_image_sft_4step_v2.0.safetensors (1.2 GB) 放入 models/loras/加载官方提供的 moss-image-4step-turbo.json 工作流即可。其核心参数已预设妥当:LoraLoaderModelOnly 强度设为 1.0,采样器选择 euler 或 simple,步数设为 4,CFG 设为 1.0。
在使用该蒸馏模型时,参数设置至关重要。如果继续套用默认 MOSS-Image 模板(25–50 步,CFG 2.5–3),输出画面会出现严重的涂抹或过熟现象。必须严格遵循 4 步和 CFG 1.0 的设置;若生成 1024² 以上分辨率的图像,可适当调整为 6–8 步。
对于追求极致画质的用户,建议在 Load Diffusion Model 节点中直接加载合并后的 fp32 单文件 moss_image_sft_4step_v2.0_fp32.safetensors,并完全跳过 LoRA 加载。标准的 LoRA 修补过程会将 fp32 增量转换为 bf16 权重,这往往是导致精细文本细节丢失的原因。
此外,项目还提供了草稿模式选项。用户可将 LoRA 文件替换为 2 步版本,预览速度可提升约一倍,待构图满意后再切换回 4 步进行最终渲染。
在公开的 4 步生成竞赛中,该模型展现出明显的效率与准确性优势。在相同提示词和种子下,其生成耗时为 5.6 秒,而对比模型(如 lodestones lora_latest 8 步或 rapid-moss 4 步)耗时达 11.2 秒。同时,它是测试中唯一所有数字均正确渲染的面板,验证了其在复杂文本生成任务上的可靠性。