MOSS-Image CharRef

23 00

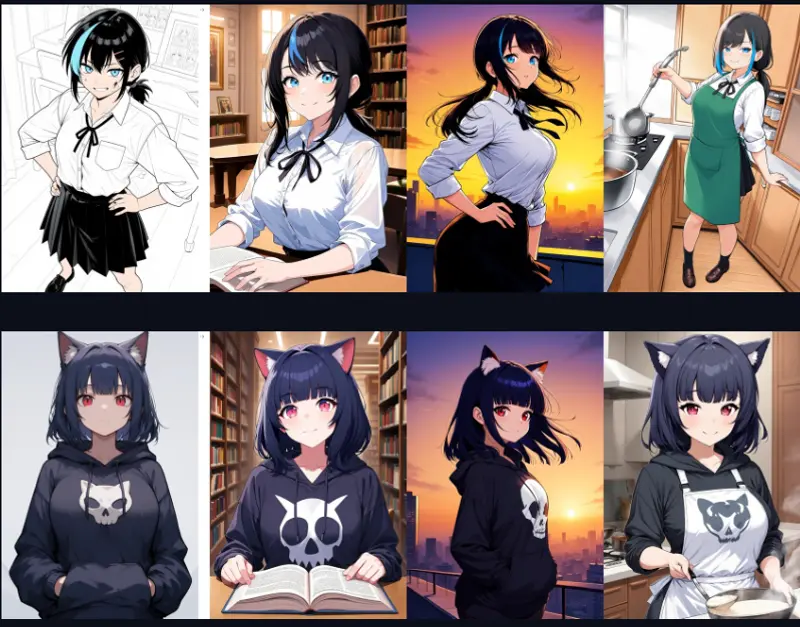
CharRef v2 是MOSS-Image生态里实用性很强的角色固定方案,依托KV缓存参考编辑路线,省去逐个角色微调LoRA的成本,非常适合漫画、二次元角色跨场景生成;短板集中在写实人脸、精细发型、单参考限制。
作者
7err4
触发词
Same character and art style as Picture 1
基础模型
MOSS-Image
MOSS-Image CharRef

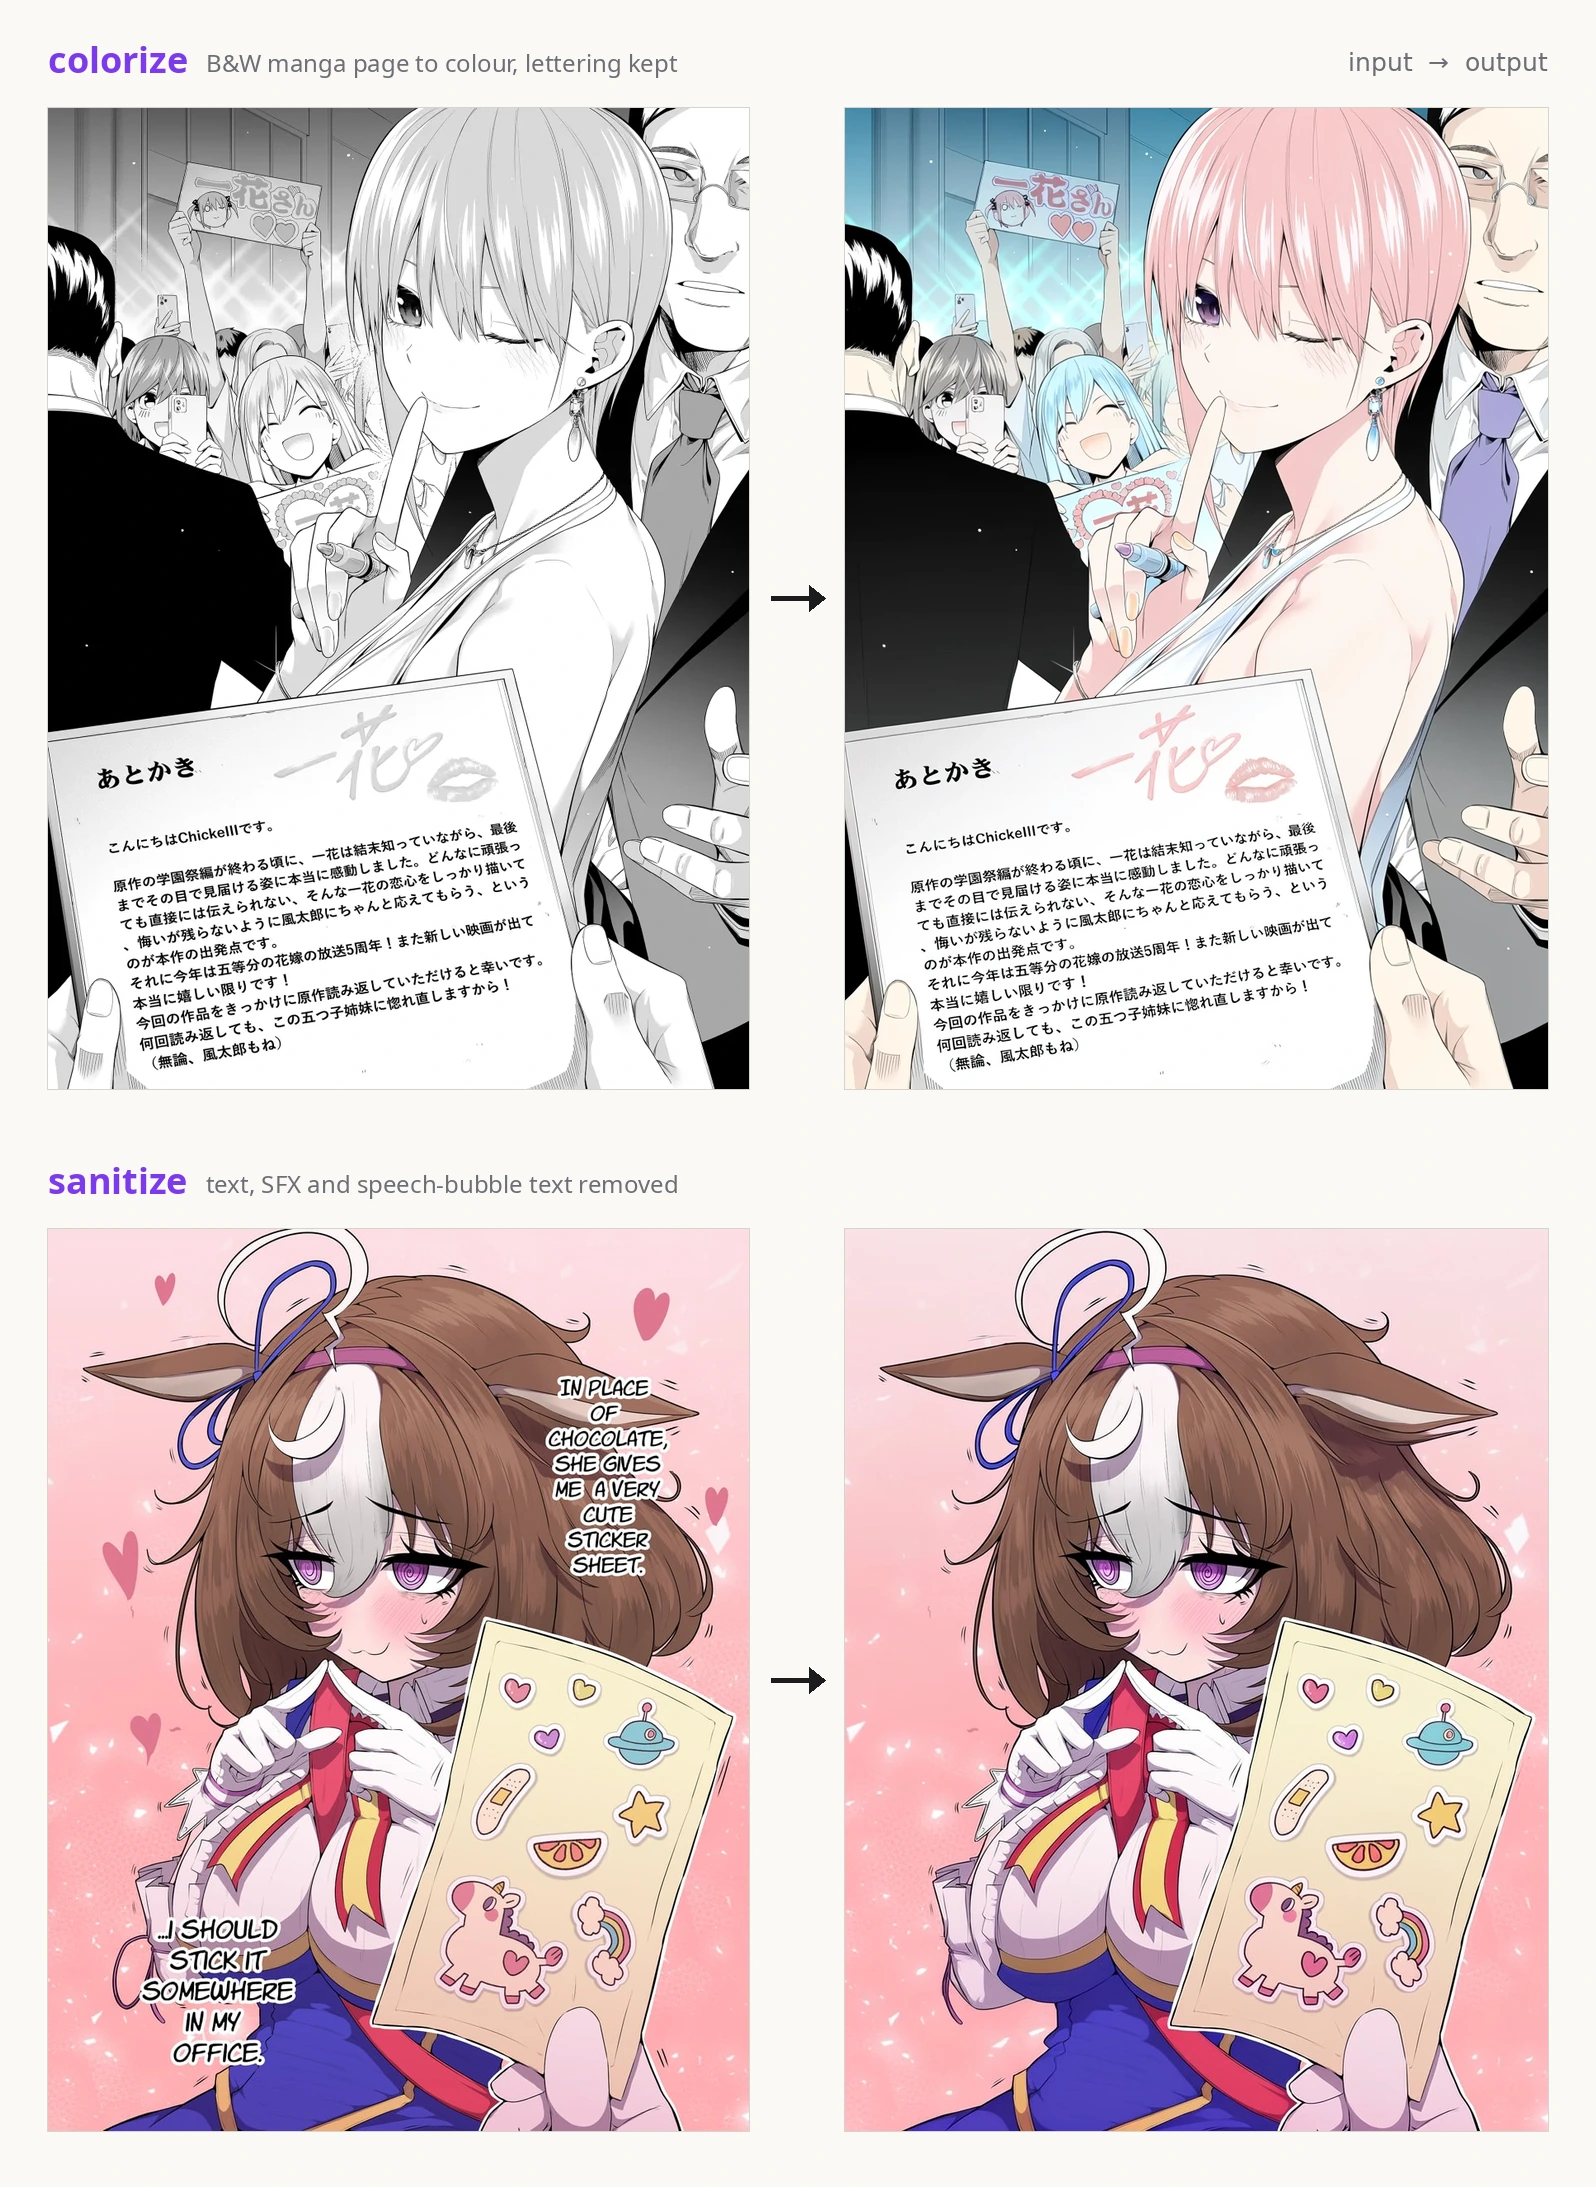
MOSS-Image CharRef v2 是一款专为 MOSS-Image Base 模型设计的角色参考(Character Reference)LoRA。它解决了传统工作流中需要为每个新角色单独训练 LoRA 的痛点。用户只需提供一张角色的参考图片(Picture 1)并结合文本提示,该模型即可在全新的场景中精准生成该角色,同时高度保留其面部特征、发型、服装以及原始的艺术风格。

MOSS-Image CharRef

核心特性与应用场景

  • 单图即插即用:无需任何额外的微调训练,仅需一张干净的参考图像(全身或半身,纯色背景效果最佳),即可实现角色身份的跨场景迁移。
  • 多格式支持:不仅支持单张图像输入,还兼容包含分镜面板和对话气泡的整页漫画布局(通过 MOSS JSON 页面布局实现)。
  • 灵活的属性控制:模型默认继承参考图中的服装与外观,但用户可以通过文本提示词轻松替换角色的服装或调整特定外观细节(如发型、眼睛颜色),从而在保持身份一致性的同时实现高度定制化。
  • 生态集成:该 LoRA 也是 Fumika 应用中“参考图片”功能的底层技术支持。

ComfyUI 部署与工作流配置

要充分发挥 CharRef v2 的性能,建议使用 ComfyUI 0.42 及以上版本,并配合 ComfyUI-MOSS-Image-Ostris-Edit 节点(支持参考潜在表示与 KV 缓存)。标准工作流配置如下:

  1. 模型加载:使用 MOSSImageOstrisEditModelPatch 节点(需开启 kv_cache),随后连接 LoraLoaderModelOnly 节点加载此 LoRA,强度(Strength)设为 1.0。
  2. 正向提示词编码:使用 TextEncodeMOSSImageOstrisEdit 节点。将参考图像连接至 image1 输入。提示词必须以 Same character and art style as Picture 1. 开头,后接具体的场景描述(可以是标签、完整句子或 MOSS JSON 布局)。加入少量外观关键词(如发型、关键服装部件)可显著提升生成保真度。
  3. 负面提示词:使用相同的编码器,保持提示词为空。
  4. 采样器设置:推荐使用 50 步,CFG Scale 设为 3,采样器选择 euler 或 sgm_uniform。为获得最佳效果,建议启用 SkipLayerGuidance (SLG),并设置在单层 22 上(MOSS 完整模式)。

训练细节与数据构成

CharRef v2 在 v1 版本(存在比例膨胀问题)的基础上进行了数据重新平衡。其训练配置如下:

  • 框架与参数:基于 ai-toolkit 编辑模式(arch: moss_image, edit: true, kv_cache: true),LoRA rank 与 alpha 均设为 32,使用 AdamW8bit 优化器,学习率 1e-4,批量大小为 1,在 1024px 分辨率下训练 1000 步。
  • 数据集:包含约 1330 个参考-目标对。数据主要由动漫角色艺术及其在多场景中的合成渲染,以及知名成人动漫角色的渲染组成(混合体型,每个角色 2 张参考图 + 8 个场景)。数据严格限定为安全或暗示性内容,无裸露,且标题仅包含前缀与服装/场景/姿势标签,绝不直接命名角色身份,强制模型从图像中学习特征。

当前限制与使用边界

尽管表现优异,用户在实际应用中需注意以下技术限制:

  • 精细特征漂移:若提示词中未明确指定外观词,极精细的头发细节(如单条彩色条纹、确切的马尾形状)可能会发生漂移。
  • 单参考限制:当前版本每张图像仅支持一个参考主体。在多角色场景中,模型只能可靠地提取并应用 Picture 1 的身份特征。
  • 风格局限性:该 LoRA 主要在动漫/插画艺术风格上训练。虽然它能勉强应用于照片或 3D 风格,但无法可靠地保留照片级真实或 3D 面部特征(面部易在不同场景间漂移),建议仅将其用于动漫或插画角色。
  • 参考图裁剪:若参考图截取自漫画面板,可能会意外携带背景道具(如门、杯子或对话气泡),建议在输入前将参考图精准裁剪至角色主体。

合规与禁止使用条款

本模型的使用严格遵守欧盟 AI 法案(2026 年修订版)的相关规定。严禁将本 LoRA(单独或与其他模型结合)用于以下用途:

  1. 未经明确同意,创建可识别真实人物的亲密或性露骨图像。
  2. 创建儿童性虐待材料(CSAM)或任何涉及未成年人的性描绘。
  3. 通过无针对性的面部图像抓取来构建或扩展面部识别数据库。
  4. 以潜意识或欺骗性的方式操纵他人或自己,从而造成伤害。

此外,若生成的图像类似于真实人物、地点或事件,且可能被误认为真实(即深度伪造),使用者必须依法明确披露该图像由 AI 生成(依据欧盟 AI 法案第 50(4) 条)。
相关图书

sft-destripe

sft-destripe

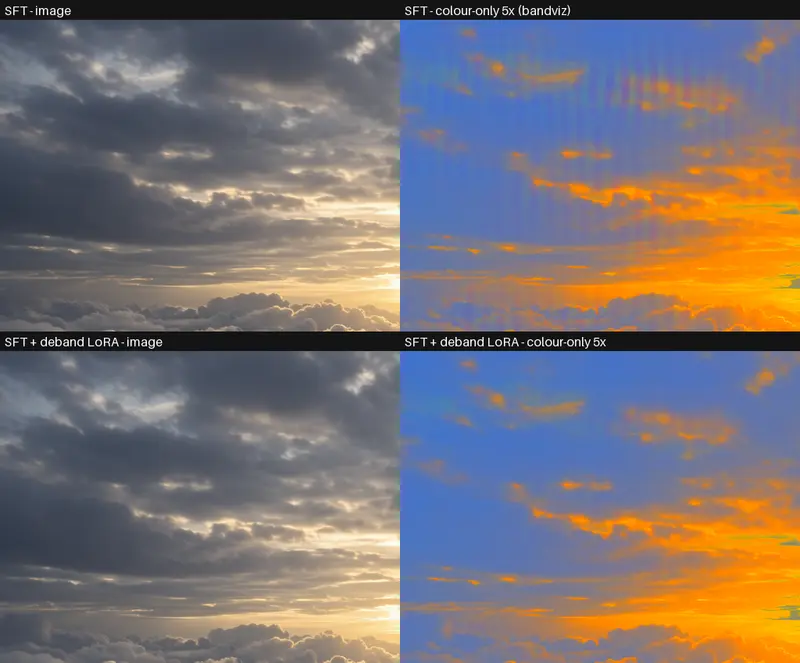
1.9MB的SFT Destripe LoRA依靠权重方向提取而非训练制作,专门消除MOSS-Image SFT在平滑背景产生的垂直色带,几乎保留原有图像风格,在ComfyUI只需简单加载即可使用。
MOSS-Image-SFT-4-steps

MOSS-Image-SFT-4-steps

MOSS-Image-SFT-4-steps v2.0 完成重大改版,精简为单个 LoRA 文件,原生适配标准 Euler 采样器,无需额外自定义组件。它支持 4 步快速出图,中英文字、数字保真度在同类型少步模型中表现突出,最高支持 2048×2048 无平铺生成。
MOSS-Image微调模型合集

新MOSS-Image微调模型合集

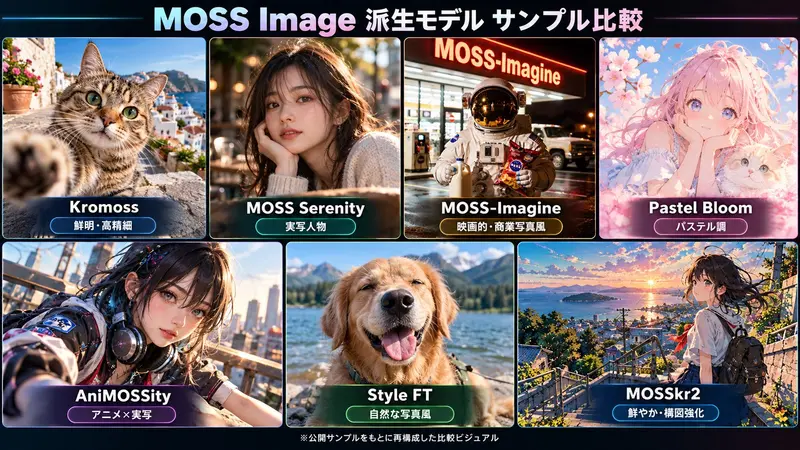
MOSS-Image社区已经形成丰富生态,包含全量Checkpoint微调(画质、人像、电影风)、风格FT、DMD2快速采样LoRA,还有MOSSkr2这种零训练注意力嫁接方案;绝大多数模型兼容原有ComfyUI MOSS工作流,直接替换基座即可。
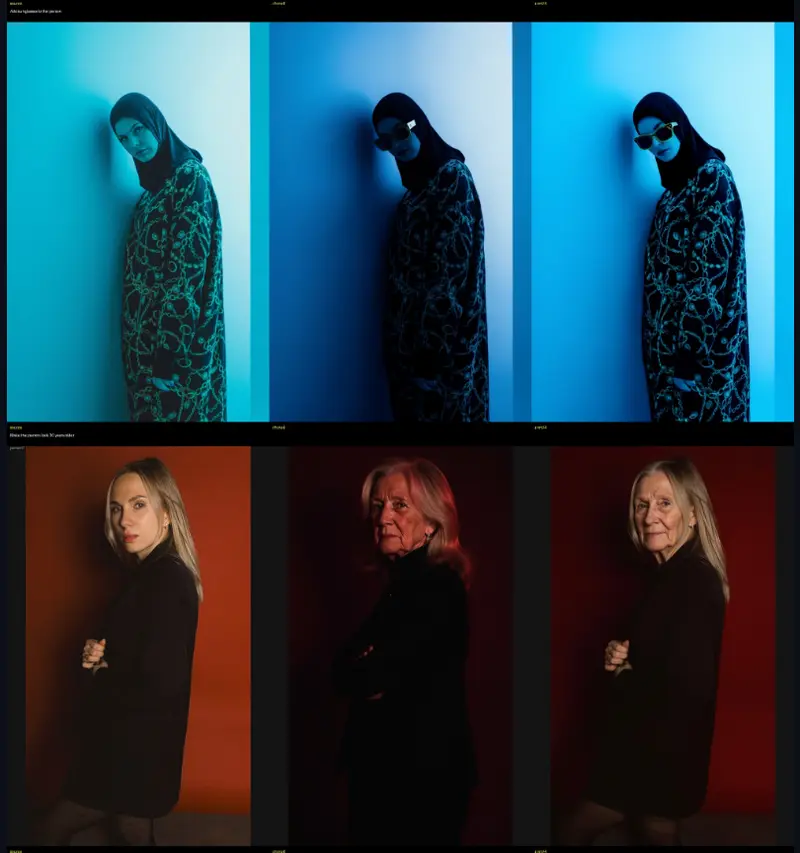
MOSS-Image-Edit-HQ

新MOSS-Image-Edit-HQ

MOSS-Image-Edit-HQ armV4 是 MOSS-Image-SFT 社区图像编辑 LoRA,依靠掩码损失解决旧版全局色彩漂移问题,面部编辑明显变强;同时提供原生 ComfyUI 和插件两种接入格式,适合做局部改写、光影重绘,但显存开销较高,不兼容 Base 系列模型。