Thinking Machines Lab今天正式推出了其第二代混合专家(MoE)模型 Inkling 2 Small。该模型总参数达 594B,激活参数仅为 17B,原生支持图像输入与可变努力(Variable Effort)控制,在智能体编码、长时程自动研究及视觉推理等复杂任务上实现了显著的性能跃升。
- 官方介绍:https://thinkingmachines.ai/news/inkling-2-small
核心能力突破
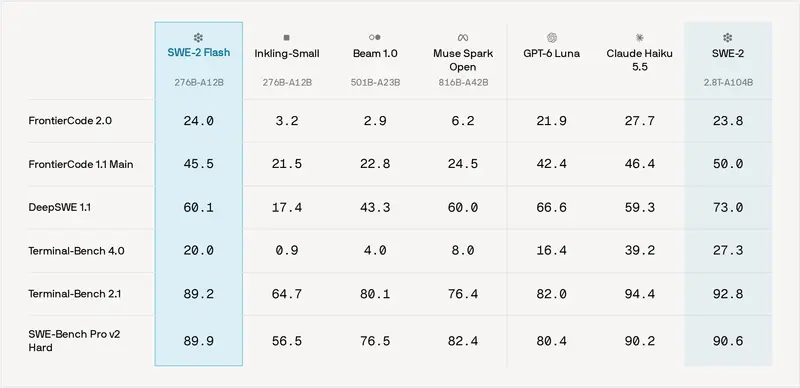
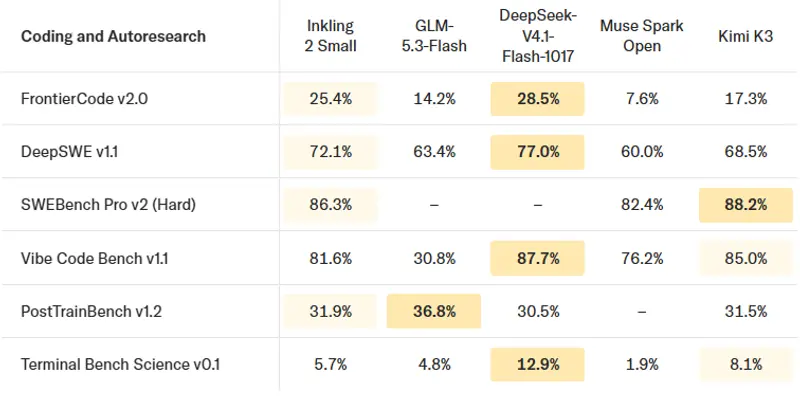
- 智能体编码与自动研究:在数十万个长时程编码任务上进行了强化学习(RL)训练,不仅超越了传统的单元测试奖励,还引入了智能体 RL 评分器以评估解题过程。模型在 FrontierCode、DeepSWE 等基准中表现优异,甚至能自主完成如“训练 Qwen3.5-4B 预测时间序列”等端到端自动研究任务。
- 视觉解释与创作:集成基于 Perception Encoder 的 292M 参数视觉编码器,支持 OCR、视觉接地、信息图解释与视觉推理。模型能在循环中利用视觉反馈来验证其生成的代码输出,展现出强大的多模态交互能力。
- 智能体知识工作:在金融分析、电子表格处理及文档定量推理方面表现突出。在 AA-Briefcase(端到端知识工作基准)中取得 1527 的 ELO 分数,成为开放权重模型中的佼佼者。
- 卓越的可定制性:对后训练和微调响应极佳,在特定领域(如金融文档摘要)仅需少量训练步骤即可快速适应并大幅超越基线性能。
训练架构与系统工程创新
Inkling 2 Small 的训练过程代表了大规模 MoE 模型工程化的新高度:
- 四阶段渐进式预训练:从 H1 阶段 8.4T token 的广泛混合数据,到 H4 阶段聚焦于 34B token 的高质量智能体轨迹,上下文长度逐步扩展至 1M token。
- NVFP4 原生训练与采样:全面采用 NVIDIA Blackwell 架构引入的 4 位浮点格式(NVFP4),在 GB300 NVL72 机架上实现了极高的专家并行效率。
- 大规模联合 RL 运行:摒弃了以往分离的推理与智能体 RL 运行,采用单一联合运行(1,075 步,超 1700 万次 rollout)。结合异步 RL(StableReinforce 目标)、粘性路由与 DRAM KV 缓存卸载,在长上下文训练下维持了 93%+ 的前缀缓存命中率与 5:3 的采样器/训练器比率。
安全对齐与发布路线图
- 纵深防御安全机制:针对长时程自主工作带来的潜在风险,系统部署了两层监控:同步层(工具调用前的确定性规则与 LLM 评判器检查)与异步层(对训练和评估 rollout 进行事后审查与警报升级)。
- 可控的风险表现:在 CBRN(化学、生物、放射和核)及对抗性提示测试中,其有害帮助风险分数低于开放权重前沿模型,尽管这也导致了较高的“过度拒绝”率。
- 开源计划:目前 Inkling 2 Small 已可通过 Tinker 平台进行推理与微调(封闭权重)。官方计划在完成全面的外部安全测试与红队演练后,于下周以 Apache 2.0 许可正式开源完整模型权重。
© 版权声明
文章版权归作者所有,未经允许请勿转载。