Liquid AI 推出开放权重多模态决策模型家族 Open d1,包含两款模型:d1-3B,支持文本+图像输入;d1-omni-600M,支持文本搭配图像或者文本搭配音频。这两个模型和常规生成式大模型最大的区别:不会输出任何文本Token,一次前向推理,直接返回经过校准的分类概率结果,专为英伟达全栈硬件做实时决策场景优化,覆盖DGX服务器、RTX工作站、Jetson边缘开发板。
- d1-3B:https://huggingface.co/LiquidAI/d1-3B
- d1-omni-600M:https://huggingface.co/LiquidAI/d1-omni-600M
模型均可在Hugging Face获取权重,Transformers库可直接加载,上线首日就支持llama.cpp。许可证采用LFM Open License v1.0,年收入低于1000万美元的企业可以免费商用。d1-omni-600M属于早期研究版本,官方暂未公布延迟指标。
什么是决策模型
普通生成LLM是逐Token输出文本,业务代码再去解析回答;决策模型接收环境状态与一组结构化问题,单次推理直接返回各候选答案的概率分布。Liquid AI定义三类问题:
- noul:是非类问题,输出“是”的概率P(yes)
- choice:从预设标签里选择,返回完整概率分布
- score:2~10级有序打分,输出概率加权评分
一次请求可以在同一个输入状态上并行处理多条问题,返回参数固定标注output_tokens:0。
Open d1不是对话聊天模型,推荐场景:流量路由、内容审核、意图分类、检索重排、LLM裁判打分、AI代理安全护栏、视觉质检。
两款模型架构
d1-3B(3.12B参数)
基于LFM2.5-VL-3B视觉语言模型改造,融合LFM2.5-2.6B文本主干权重,经过多种子、多数据混合微调再合并权重;搭载400M SigLIP2 NaFlex视觉编码器,上下文窗口32768 Token。训练层面,长文本输入、打乱候选答案、消除数据捷径比复杂高级技术带来更大收益。
d1-omni-600M(587M参数)
基于双向编码器LFM2.5-Encoder-350M搭建,381M共享主干+决策头,搭配94M视觉编码器与112M音频编码器;音频编码器为17层FastConformer,上下文长度16384 Token,音频片段最长支持30秒。单次输入只能选择图像或者音频,不能图文音频同时传入;音频训练数据仅覆盖英文用户向助手提问场景。
适用场景
- 工单与客服分流:单次调用可同时完成退款资格判定、分派负责部门、评估紧急等级,省去解析生成文本的开销
- 边缘端实时视觉质检与内容审核:d1-3B在Jetson AGX Thor处理384px图像仅35ms;Open d1 Arcade可读取摄像头画面逐帧推理,用于内容审核、手势识别
- 小型设备语音指令路由:d1-omni-600M接收最长30秒语音+文本,直接识别用户意图,适合本地语音指令、代理安全护栏
基准性能
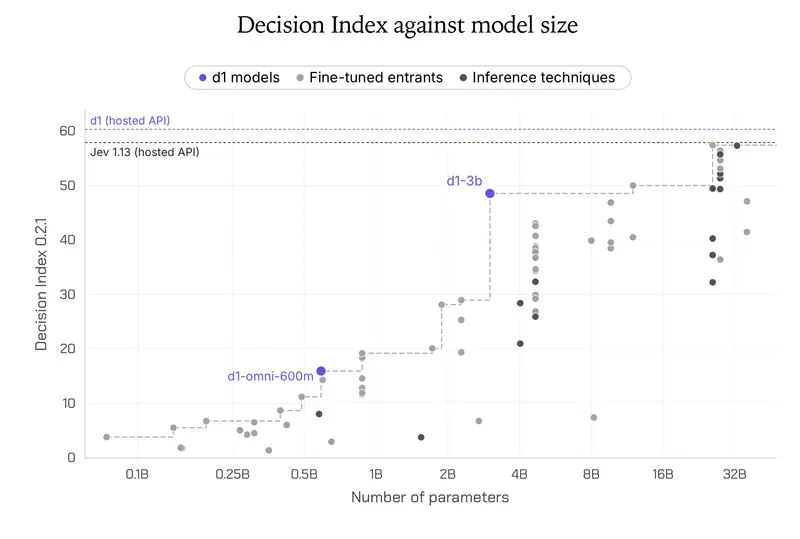
Decision Index v0.2.1榜单中,d1-3B得分48.57,10B参数以内模型第一名,超过Decider 35B-A3B(47.11),仅低于Winnow-12B(50.02)。分项上Tools类别74.5分领先,知识类任务偏弱仅23.8。
- 7个公开文本基准:d1-3B平均分82.9,高于Decider 4B的81.1;d1-omni-600M平均分78.4,Civil Comments达到95.8,PAWS-X为79.5
- 11项图像基准:d1-3B平均74.1,略高于其基础模型73.9;音频类决策基准目前行业尚无统一标准
硬件延迟表现(单热请求,端到端)
- RTX4090:单问题仅8ms(开启model.compile优化;关闭优化为16ms)
- AMD MI325X:9ms
- Jetson AGX Thor:单问题16ms;同一状态并行3个问题20ms
- Jetson AGX Orin:26ms
- Jetson Orin Nano:50ms
NVIDIA Jetson AI Lab同步上线d1-3B部署教程。
和其他开源决策模型横向对比
| 特性 | d1-3B | d1-omni-600M | Decider 4B | Decider 35B-A3B | Winnow-12B |
|---|---|---|---|---|---|
| 厂商 | Liquid AI | Liquid AI | Mapika | Mapika | EldanRing |
| 参数 | 3.12B | 587M | 4.2B | 总34.7B,活跃3B | 12B |
| 输入 | 文本、图像 | 文本+图像 / 文本+音频 | 文本 | 文本 | 文本、图像 |
| Decision Index | 48.57 | 15.95 | 40.70 | 47.11 | 50.02 |
| 许可证 | LFM Open v1.0 | LFM Open v1.0 | Apache 2.0 | Apache 2.0 | Apache 2.0 |
提示:各模型延迟测试硬件、负载不一样,分数不能直接对等比较。
本地运行要点
- d1-3B:transformers >=5.14,启用trust_remote_code=True
- d1-omni-600M:transformers >=5.15;GPU推荐float16,bfloat16会改变部分模型偏好答案
- API接口:
system_one处理单条状态,system_one_batch批量打包请求 - 线上Demo:Open d1 Arcade可体验摄像头驱动的d1-3B演示;联合英伟达展示Jetson驱动Isaac Sim仿真导航案例
要点小结
- 核心创新:零Token输出决策模型,一次前向推理直接输出概率,不需要解析生成文本,适合低延迟判定场景
- 两款模型定位:d1-3B(3.12B,图文,云端/边缘视觉判定);d1-omni-600M(587M,图文或音文,轻量设备语音意图识别)
- 性能:d1-3B是10B以内Decision Index最高分;RTX4090单问题仅8ms,Jetson系列可跑实时视觉推理
- 许可规则:LFM Open v1.0,年收入低于1000万美元可免费商用
- 局限:d1-omni-600M无公开延迟;音频仅支持英文;不能同时输入图像+音频;并非聊天生成模型
© 版权声明
文章版权归作者所有,未经允许请勿转载。