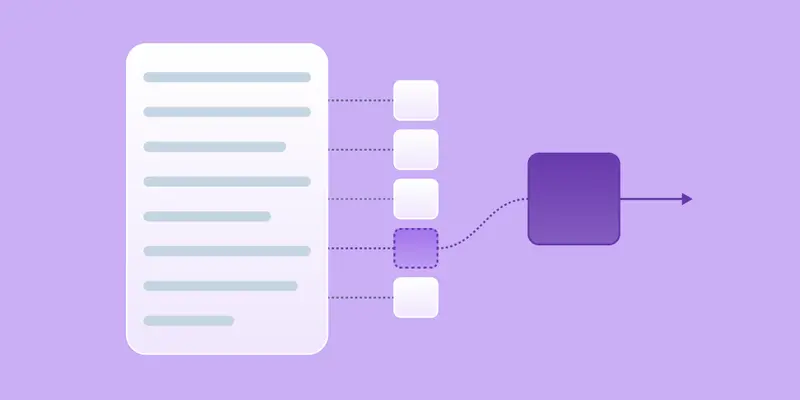
Kev 是一个基于 Qwen3.5 构建的开源小型决策模型家族(0.8B/4B/9B),遵循 Jev‘s Architecture Unmasked 描述的架构设计。它支持在同一请求中处理是/否(noul)、多选(choice)和评分(score)三类问题,各问题共享输入文本但彼此隔离。
- GitHub:https://github.com/jaredpalmer/kev
- 模型:https://huggingface.co/collections/jaredpalmer/kev
此项目提供完整训练代码、评估数据集及 Web 游乐场,可在 CUDA、ROCm 和 Apple Silicon(MLX)上运行。API 与 TypeSafe System One 完全兼容,允许将官方 Python SDK 指向本地服务器,实现零成本私有化部署。4B 和 9B 模型可在 32GB Mac 上流畅运行,bf16 模式下五问题请求延迟低至百毫秒级。
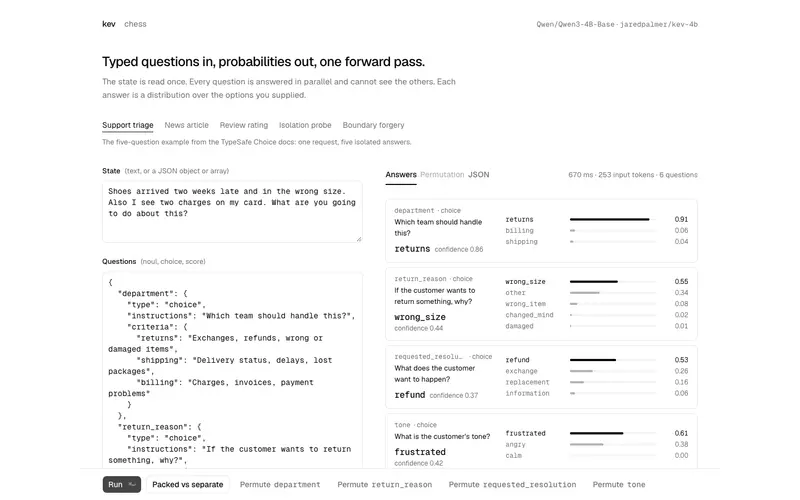
核心能力与技术亮点
多类型问题统一处理
- Noul:返回“是”的概率(如
escalate: 0.93) - Choice:返回最可能选项 + 全选项概率分布 + 置信度(如
department: returns @ 47%) - Score:返回加权平均级别索引 + 图例映射 + 概率分布(如
frustration: 1.44 → Frustrated/Very angry) - 问题隔离:注意力掩码或独立行机制确保问题间不交叉污染;fp32 测试中合并/分离提问概率差异 <4e-6
模型性能基准
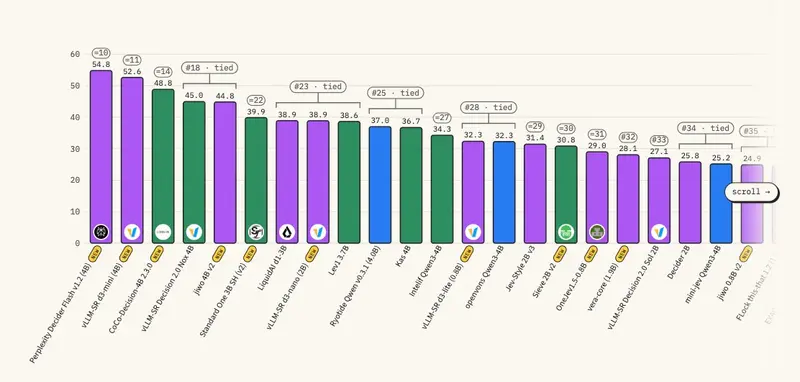
| 模型 | 基础 | 新来源准确率 (dev/test) | Brier 分数 (test) | 备注 |
|---|---|---|---|---|
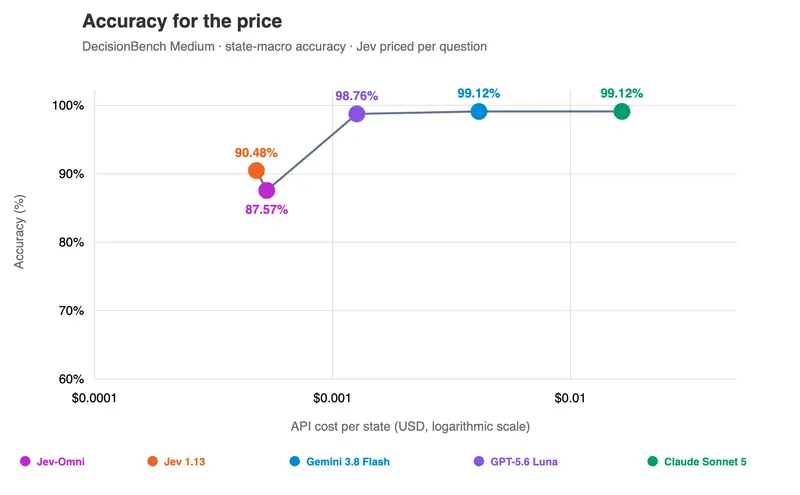
| Kev-9B | Qwen3.5-9B | 0.822 / 0.852 | 0.237 | 接近 Jev (0.857),校准误差 0.042 |
| Kev-4B | Qwen3.5-4B | 0.797 / 0.837 | 0.255 | 性价比最优,Mac M5 五问题 721ms |
| Kev-0.8B | Qwen3.5-0.8B | 0.652 / 0.684 | 0.460 | 极致轻量,适合边缘场景 |
| Jev | 托管 | 0.857 / – | 0.211 | 闭源参照,未公开训练数据 |
💡 关键发现:
- 概率默认已校准(温度 ~2.1–2.4),自信错误率从 8.7% 降至 4.0%
KEV_DATE_FACTS=1可将截止日期策略准确率从 0.80 提升至 0.90- Qwen3.5 相比 Qwen3 在测试集上显著提升(9B +7.3 点,CI +2.8~+11.7)
跨平台推理优化
- Apple Silicon:通过 MLX 运行 DeltaNet 层,概率与 fp32 PyTorch 匹配至 bf16 精度;前缀缓存使重复状态延迟降低 5×
- CUDA/ROCm:推荐安装 flash-linear-attention;H100/MI300X 上五问题请求仅需数十毫秒
- 精度选择:bf16 为默认(延迟优先);
KEV_DTYPE=fp32用于评估精确路径
快速上手指南
本地服务启动
git clone https://github.com/jaredpalmer/kev.git && cd kev
uv sync --extra serve
uv run --extra serve python -m kev.serve --run jaredpalmer/kev-4b --port 8009
首次运行自动下载适配器与基础模型。支持本地检查点或 Hub 修订版(如 @qwen3)。
API 调用示例
curl -s localhost:8009/v1/systemone -H 'content-type: application/json' -d '{
  "state": "Shoes arrived late and wrong size. Two charges on card.",
  "model": "kev-latest",
  "questions": {
    "department": {"type": "choice", "instructions": "Which team?",
                   "criteria": {"returns": "...", "shipping": "...", "billing": "..."}},
    "escalate":   {"type": "noul", "instructions": "Urgent human attention?"},
    "frustration":{"type": "score", "instructions": "Customer frustration level?",
                   "criteria": ["Calm", "Frustrated", "Very angry"]}
  }
}'
Python SDK 集成
from typesafe_sdk import TypeSafeClient, Noul, Choice, Score

client = TypeSafeClient(api_key="local", base_url="http://127.0.0.1:8009")
response = client.system_one(
    state="Charged twice. Fix ASAP.",
    questions={
        "billing": Noul(instructions="About billing?"),
        "tone": Choice(instructions="Customer tone?", criteria={"calm": None, "angry": None}),
        "urgency": Score(instructions="Urgency?", criteria=["can wait", "today"])
    }
)
print(response.nouls["billing"].noul)      # 0.93
print(response.choices["tone"].choice)     # "angry"
print(response.scores["urgency"].score)    # 1.8
高级功能与调试
- Web 游乐场:
cd playground && npm run dev -- -p 3001,支持选项顺序排列测试、问题隔离验证、国际象棋对弈演示 - 选项顺序影响:
POST /v1/systemone/permute用不同顺序运行 Choice 问题(n_perm 1–64) - 问题分离执行:
POST /v1/systemone/separate为每个问题独立前向传播 - API 安全:设置
KEV_API_KEY启用 Bearer Token 认证 - 性能调优:
KEV_MERGE=0/KEV_ATTN=eager/KEV_PREFIX_CACHE=0禁用优化以排查问题
适用场景与边界
✅ 推荐使用:
- 客服工单自动分类与优先级排序
- 内容审核中的多维度风险评分
- 本地化 AI 决策系统(隐私敏感/离线环境)
- 研究小模型决策能力与校准方法
- TypeSafe 生态的私有化替代方案
⚠️ 注意事项:
- 非通用 LLM:仅适用于结构化决策任务,不支持开放生成或对话
- 领域适配必要:新来源准确率显著低于训练源,生产部署需用自有数据微调
- 选项顺序敏感:Choice 问题内选项排列可能影响结果,建议用 permute 端点验证鲁棒性
- 日期推理弱:需启用
KEV_DATE_FACTS=1显式注入天数事实 - Qwen3 模型停更:上一代权重保留但不再维护,新项目请用 Qwen3.5
负责任使用提醒
- 校准≠准确:置信度反映分布集中度,非实测准确率;高风险场景需独立验证
- 训练数据透明:所有评估数据集开源,但 Jev 训练数据未知,对比需谨慎
- API 兼容性:虽匹配 TypeSafe 接口,但输出 token 计算方式不同(序列化答案 vs 生成 token)
- 硬件依赖:DeltaNet 层在 Apple Silicon 需 MLX;CUDA 推荐 flash-linear-attention
- 版本锁定:torch 尚无 3.14 wheel,请使用 Python 3.12/3.13
Kev 的价值在于将原本闭源的“System One”决策范式彻底开放——不仅提供权重,更交付完整的训练、评估与服务化基础设施。它证明小型专用模型在结构化决策上可逼近甚至超越大型通用模型,且成本与延迟低数个数量级。
对于需要将 AI 判断嵌入生产流水线又受限于预算或隐私的团队,这可能是目前最务实的选择。但请记住:再精准的决策模型也只是工具,真正的责任永远在人。用它加速判断,但别让概率取代你的审慎——因为每一个被自动分类的工单背后,都是一个等待被认真对待的人。
© 版权声明
文章版权归作者所有,未经允许请勿转载。