MJev-Spatial 是一款面向空间理解的多模态决策模型,核心思路是把空间问题转化为有限候选集上的选择任务,抛弃传统VLM自回归生成文本再解析结果的路线。模型基于Qwen3.5-4B构建,复用主干原有Query、Key投影做候选打分,不新增独立预测头,一次前向计算直接输出决策,全程不生成答案Token,大幅降低推理延迟。
- GitHub:https://github.com/Fr0zenCrane/MJev-Spatial
- 模型:https://huggingface.co/mindlab-research/MJev-Spatial-4B
解决的痛点
传统视觉语言模型处理空间任务(定位、测距、角度判断):图像+问题→逐Token生成文字描述→程序解析文本坐标/数值。
两大短板:自回归逐Token生成速度慢;文本解析环节容易引入格式错误、解析偏差。
研究人员提出:大量空间任务的答案空间是有限集合,完全可以转为候选分类问题。
核心技术方案
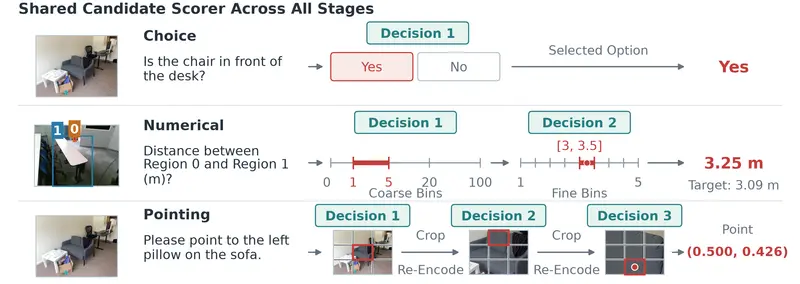
依托Qwen3.5-4B原生注意力机制,分别构建「图像+问题」的决策表征、「候选答案」候选表征,计算匹配分数,softmax选出最高分候选项。
统一三类空间任务:
- 选择题:直接在给定候选项分类打分;
- 数值预测:先选粗粒度区间,再细分细粒度区间,解码得到数值;
- 点定位:连续三轮3×3网格区域选择,每一步裁剪局部图像并重新编码,逐步缩小定位范围。实验证明该裁剪重编码是性能关键,去掉后RefSpatial指标从51%暴跌至9%。
训练方案
- 数据集:将各类空间数据集转换为约1230万条问答样本,覆盖选择、点定位、长度/角度估算、计数;
- 多步任务采用teacher forcing,一次性监督全部粗到细决策;
- 训练策略:序列长度分组、跨GPU负载均衡;全参数微调语言主干,冻结视觉编码器与视觉merger;
- 优化收益:批处理策略让训练吞吐提升30.8%。
实验指标
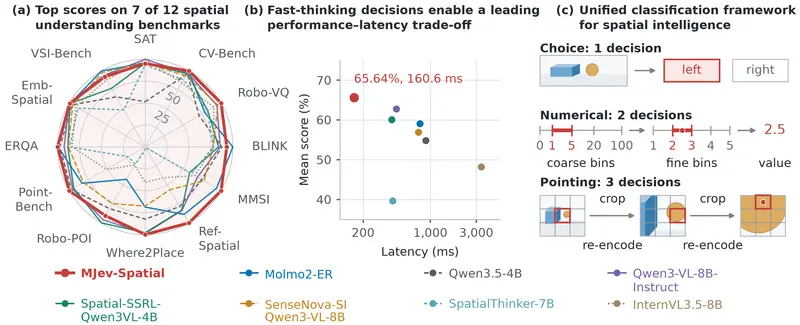
- 12项空间理解基准平均得分65.64%,7项基准取得第一,全部12项均优于原生Qwen3.5-4B;
- NVIDIA B200环境平均单请求延迟160.6ms;
- 对比最快自回归基线提速约2.5倍,对比原生Qwen3.5-4B自回归版本提速约5.6倍。
提示:该结果为论文固定评测环境下测得,更换数据集与部署环境需要重新评测。
© 版权声明
文章版权归作者所有,未经允许请勿转载。