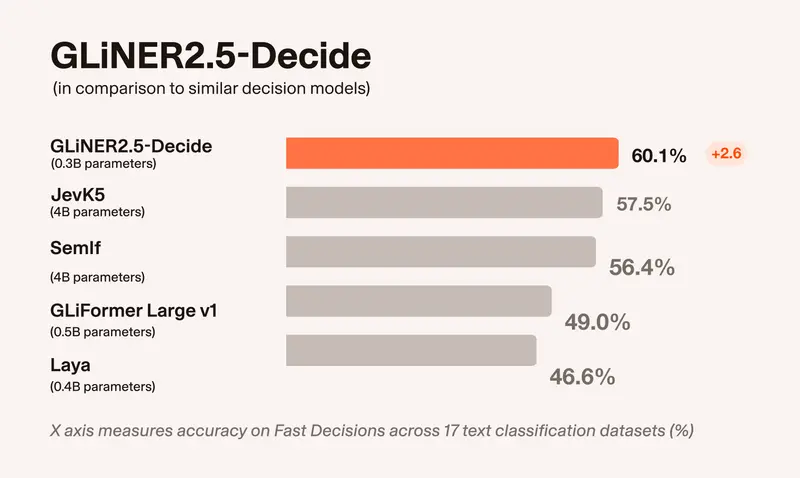
随着决策模型在AI领域快速兴起,Musubi推出专为实时内容审核打造的轻量级决策模型PolicyLM-1.7B,采用开放权重Apache 2.0协议发布。它可以直接读取自然语言撰写的平台内容规范,单条消息判定耗时低于50毫秒,兼顾传统分类器的速度成本与大模型的规则灵活度。
- 模型:https://huggingface.co/musubilabs/policylm-1.7b
传统内容审核方案存在明显短板:固定机器学习分类器速度快,但规则一旦调整,就要重新标注数据、训练模型,只能使用预设类别;通用大语言模型可以读懂自定义政策,却推理延迟高、成本昂贵,很难支撑聊天室、游戏大厅等高并发实时场景。
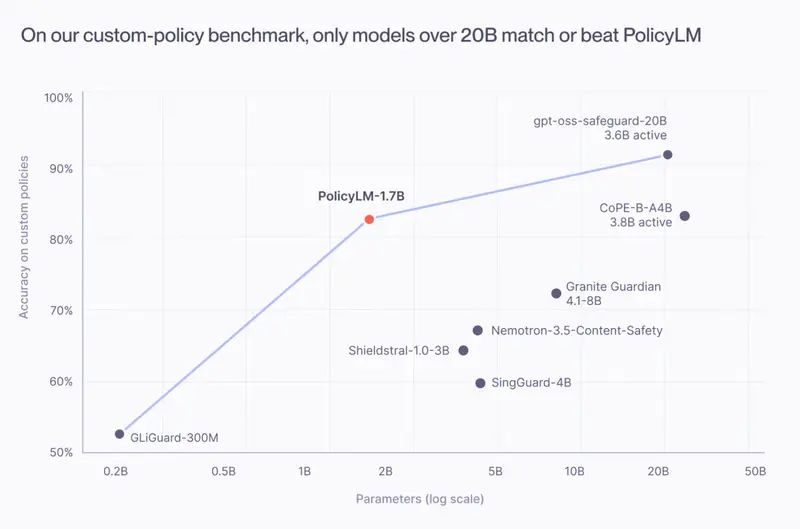
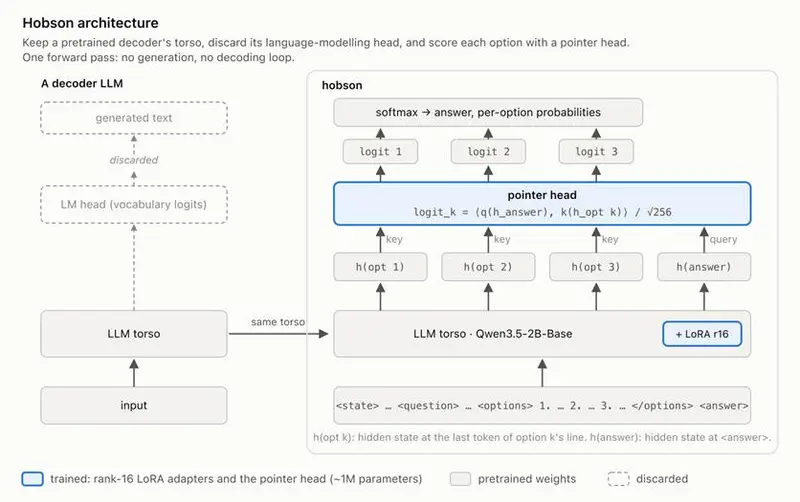
PolicyLM-1.7B作为决策模型,不生成文本,单次前向推理直接输出各个违规类别0-1置信分数。平台安全团队用通俗文字描述审核规则、新增标签,修改政策可以立刻生效,不需要重新训练模型,适合政策频繁迭代的社区。
该模型已经落地生产,定制版本每日处理超百万条消息。硬件门槛不高,单张24GB L4显卡就能跑,短聊天消息中位数仅35毫秒,最高不超过100毫秒,保障对话不卡顿;支持多标签同时输出,内置两套分数截断预设:「精确」适合违规少见的实时私聊场景,「均衡」模式提升召回,适合漏报代价更高的内容队列。模型仅支持文本,在19种语言完成评估,英语表现最优。
从底层来看,PolicyLM-1.7B源自Qwen3-1.7B-Base改造的BidirLM-1.7B-Embedding编码器,训练素材融合了Nemotron Safety Guard、XGuard-Train等多个公开安全数据集,搭配合成数据。官方也提供了代码样例,开发者可以直接在Hugging Face下载权重,本地部署、微调。
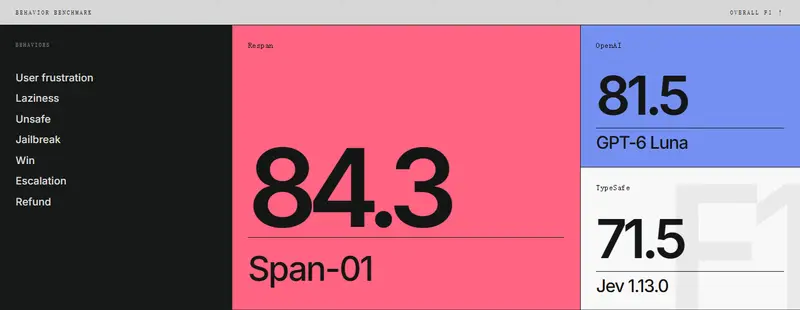
Musubi把PolicyLM-1.7B对标TypeSafe AI的Jev。二者同属决策模型,跳过文本生成直接输出判定结果;区别在于PolicyLM-1.7B专门针对内容安全场景优化,权重开源,企业可以完全部署在自有服务器。官方设想的落地架构是大小模型搭配:PolicyLM这类小决策模型做海量内容的大规模初筛,复杂申诉、边界疑难案例交给更大LLM处理。
局限性
- 仅处理单条文本消息,默认不携带完整对话上下文
- 多语言能力不均衡,泰米尔语效果偏弱,官方测试政策均以英文编写
- 容易对字面像有害、实际正常的内容产生误报;大量无关类别、超长文本会拉高误判概率
- 只输出分数,不会给出判定理由
要点小结
- 产品:Musubi PolicyLM-1.7B,Apache2.0开放权重,面向信任安全团队的文本决策模型
- 核心优势:自然语言写审核规则,改政策不用重训;几十毫秒延迟,本地可部署,支持多标签打分
- 适用场景:实时聊天、游戏大厅、私信、用户名等需要即时判定的内容审核
- 定位:和Jev属于同类决策模型;作为大规模初筛工具,疑难案件交由大模型复核
- 限制:单消息无对话上下文,无推理理由,多语言能力存在短板
© 版权声明
文章版权归作者所有,未经允许请勿转载。