Jev-Omni 是一款多模态决策分类器,覆盖文本、图像、音频、视频四种模态。它的工作模式和普通对话大模型不一样:输入问题 + 候选选项,直接返回各个选项的概率,不会生成解释性的长文本,专门面向决策类任务。模型基座采用 Gemma 4 12B IT,在 30000 条问题样本上完成微调。
- 模型:https://huggingface.co/akhilaaa3/Jev-Omni
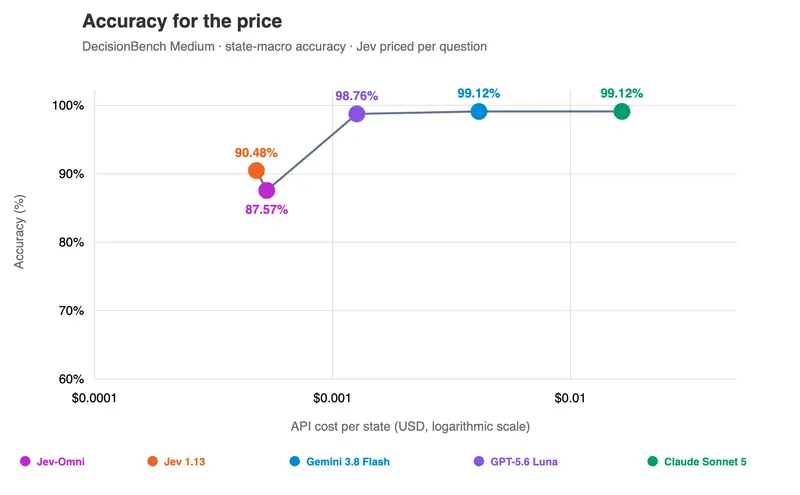
核心性能基准
| 基准 | 场景/问题数 | 准确率 | 微观准确率 |
|---|---|---|---|
| DecisionBench Medium | 80 / 293 | 87.57% | 86.01% |
| JevBench (匹配集) | 195组 / 231 | 86.15% | 87.45% |
| MMAU | 1,000 | — | 63.10% |
| MVBench | 14任务 / 2,786 | 53.10% | 53.09% |
开放权重模型对比
| 模型 | 参数规模 | MMAU | MVBench | 支持模态 |
|---|---|---|---|---|
| Jev-Omni | 12B | 63.10% | 53.10% | 文本+图像+音频+视频 |
| Inkling | 975B总/41B活跃 | 77.20% | — | 文本+图像+音频 |
| Qwen3.5-397B-A17B | 397B总/17B活跃 | — | 77.60% | 文本+图像+视频 |
⚠️ 注意:参考分数来自各开发者官方报告,评估协议可能不同;Jev-Omni 是唯一覆盖四模态的 ≤12B 开放模型。
技术特性与定位
- 非生成式架构:仅输出概率分布,无自回归解码,零幻觉风险
- 四模态原生支持:统一编码器处理文本/图像/音频/视频,无需模态路由
- 决策专用微调:30k 问题聚焦分类/选择/评分任务,非通用对话
- 成本结构独特:
- 仅计费输入 tokens($0.05/M @ OpenRouter Gemma 3 12B 费率)
- 无输出 token 消耗(分类器不生成文本)
- 每问题独立调用,状态不缓存,批量无折扣
- 与聊天模型成本差异:若将聊天模型拆分为每问题调用,输入 tokens 增加 2.82×;Jev-Omni 天然适配高频单问题决策场景
适用场景
- 多模态内容审核(图文音视频合规判断)
- 智能路由(根据用户消息类型分发至对应 Agent)
- 实时媒体理解(直播流事件检测、播客话题分类)
- 边缘部署(12B 参数可在消费级 GPU 运行)
- 高吞吐决策管线(无生成开销,延迟可控)
© 版权声明
文章版权归作者所有,未经允许请勿转载。