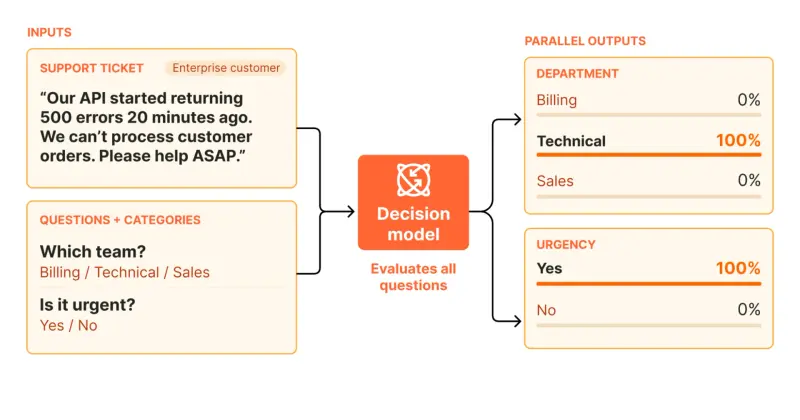
Nace.AI正式开源Drex 1.5,一款面向AI智能体与后端工作流的9B决策模型。Drex 1.5的核心设计区别于常规大语言模型:不输出文本内容,接收状态信息与带类型的问题,直接为预设的候选选项输出概率评分。模型权重已上传Hugging Face,托管API版本同步上线OpenRouter。
- 项目主页:https://www.nace.ai/drex
- GitHub:https://github.com/nace-ai/drex-decision-models
- 模型:https://huggingface.co/nace-ai/drex-v1.5
核心速览
- 模型规模:8.95B稠密参数,bf16权重约18GB;默认上下文窗口16384 token,最大支持131072 token
- 硬件门槛:bf16精度可在单块CUDA GPU运行,官方在24GB A10G完成测试;Q8_0 GGUF量化版本体积约9.5GB,支持Apple Silicon与CPU推理
- 基准成绩:Decision Index 0.3.1公开基准得分58.08,是10B参数以内模型最高分;32K~128K超长文档场景准确率可达93.4%
- 短板:在宽泛通识知识、细粒度情感识别表现偏弱,ACOS情感审查F1仅7.4%,对比Jev的29.5%差距明显
- 定位亮点:开放权重方案,单卡就能取得接近闭源竞品的决策能力;局限在于不适合通用问答、文本生成场景
什么是Drex 1.5?
Drex 1.5属于专用决策模型,仅通过单次前向推理对固定候选选项打分。输入由状态信息(文本/JSON格式)和标准化问题构成,支持三类问题类型:多选项选择、是非判断(noul)、序数评分。
由于模型不会采样生成token,温度、top_p这类文本生成参数完全不生效。模型只能基于用户预先提供的候选选项给出结果。
它兼容 /v1/systemone API接口,和TypeSafe闭源决策模型Jev使用同一套请求格式,现有Jev客户端仅修改少量环境变量即可直接对接Drex 1.5。
技术原理
Drex 1.5的主干基座为MiMo-V2.6-Distill-Qwen-9B,属于蒸馏后的Qwen 3.5 9B模型,共32层,采用混合注意力架构,每3个线性注意力层搭配1层全注意力层。额外增加独立指针头head.pt,读取主干网络隐藏状态,完成各个选项的概率打分。
推理逻辑上,针对同一个状态,搭配不同问题仅需要单独执行一次前向计算。在llama.cpp部署方案中,状态只需编码一次,可在多个问题间复用,减少重复计算开销。模型在Decision Index基准的训练集划分上完成训练,评估仅使用预留测试集。
基准性能表现
在包含37项校正测试集的公开基准Decision Index 0.3.1中:
- Drex 1.5:58.08
- Jev 1.13.0:57.96
- Bespoke Nimble 9B v3:57.19
- Cloudflare clef-flash:56.15
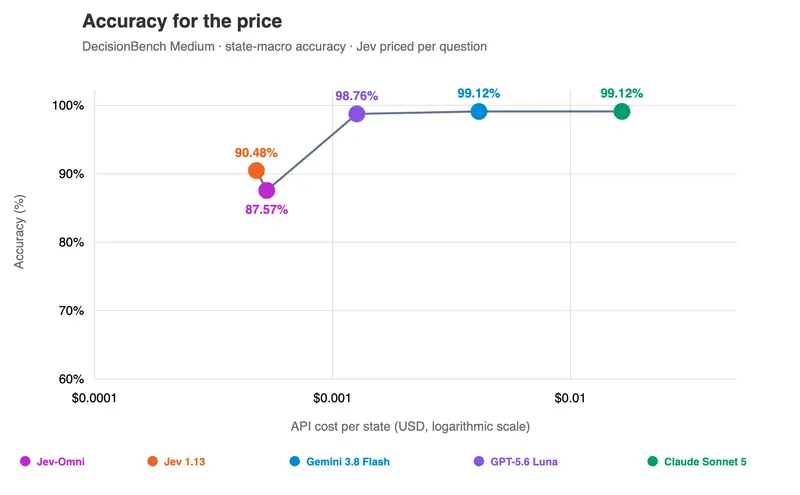
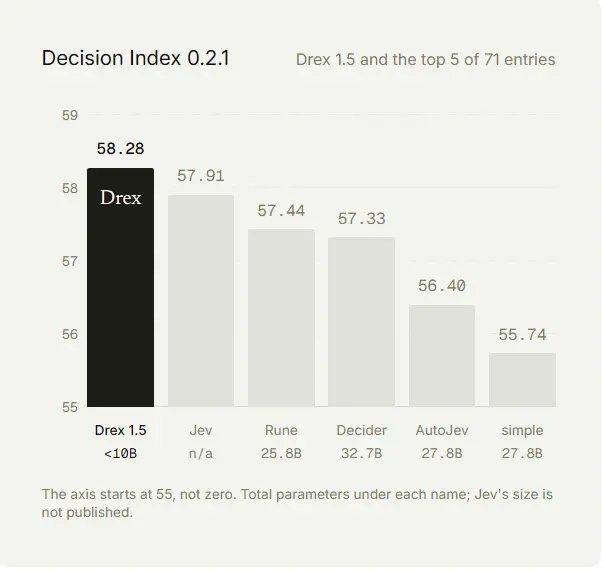
Drex 1.5、Jev、Nimble三者分数处于同一区间,Drex在37项子任务里的20项超过Jev。模型能力分布不均衡:工具类任务得分最高75.0,知识与推理类最弱仅44.6。旧版Decision Index 0.2.1中Drex得分为58.28,Jev为57.91。
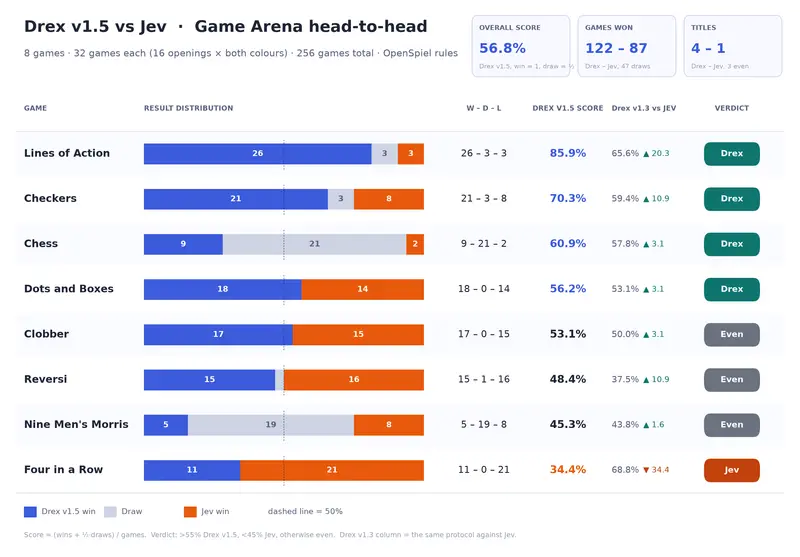
JevBench(231个公开测试用例)下,Drex准确率86.2%,Jev为87.0%;二者高难度样本的准确率同为73.9%。在8个OpenSpiel博弈游戏的对抗测试中,Drex取得122胜47平87负,胜率56.8%。
长文档是Drex的突出优势:
- 8K~32K上下文:89.5%准确率,中位数推理耗时0.65秒
- 32K~128K上下文:93.4%准确率,中位数推理耗时2.0秒
如果把相同文档截断至8K token,准确率会下降至76.5%~78%,足以体现长上下文原生支持对该模型决策效果的提升。
四种部署方案,统一API协议
所有部署方式都使用相同API,开发者可按需切换本地/托管方案:
- Python Kev运行时:CUDA显卡运行inference.py与serve.py,原生部署
- llama.cpp定制分支:提供bf16、Q8_0 GGUF,支持CUDA、Metal、CPU
- Ollama定制分支:在原版Ollama基础扩展决策能力
- 托管API:OpenRouter托管,每百万输入token定价0.04美元,输出token免费,由DeepInfra提供算力;Nace自身也提供Console API
官方在AWS g5.2xlarge(A10G 24GB)验证bf16与Q8_0输出结果一致,Q8_0量化包在Apple M5 Pro的Metal/CPU环境推理结果同样对齐。
配套Drex代理插件,可接入Claude Code、Codex、Cursor、OpenCode、Hermes Agent、Gemini CLI、GitHub Copilot等主流开发智能体。云平台新用户注册可领取25美元额度。
竞品横向对比
| 特性 | Drex 1.5 | Jev 1.13.0 | Bespoke Nimble 9B v3 |
|---|---|---|---|
| 开发方 | Nace.AI | TypeSafe AI | Bespoke Labs |
| 参数规模 | 8.95B | 未公开 | Qwen3.5-9B + LoRA适配器 |
| 权重 | 开源 | 闭源仅API | 开放适配器权重 |
| 许可证 | Nace.AI Open RAIL-M | 专有协议 | CC BY-NC 4.0 |
| 上下文 | 默认16384,最大131072 | 单次请求64K(32K状态+问题) | 未披露 |
| Decision Index 0.3.1 | 58.08 | 57.96 | 57.19 |
| JevBench | 86.2% | 87.0% | 未披露 |
| 本地部署 | 单卡CUDA / Apple芯片 / CPU | 不支持本地 | 基座Qwen3.5-9B+适配器 |
| API价格(百万输入/输出token) | $0.04 / $0 | $0.042 / $0 | 未披露 |
模型局限
Drex 1.5属于专用决策层,并非通用大模型,不能生成文本、代码,也无法输出解释性文字。知识类任务短板明显:GPQA Diamond测试集仅45.4%(Jev为78.6%),MMLU-Pro 58.7%(Jev 82.7%)。
模型在Decision Index基准数据集上训练,在熟悉类型的决策任务效果优秀,但全新领域场景效果无法保证。llama.cpp、Ollama本地部署需要使用Nace的定制分支,主线版本暂不支持。权重采用RAIL-M开源协议,存在使用限制,商业落地前务必仔细审阅许可条款。
© 版权声明
文章版权归作者所有,未经允许请勿转载。