Baseten 内部研究实验室 Base Labs 正式发布了 joey-1,这是一款参数量为 20 亿的决策模型。与传统的文本生成模型不同,joey-1 专注于在单次前向传播中回答类型化问题,直接返回标签及校准概率。
- 模型:https://huggingface.co/baselabs/joey-1
该模型主要面向高容量路由、内容分类以及安全护栏检查等场景。其核心优势在于极低的延迟与成本,Baseten 为其 API 定价为每 100 万输入 token 0.01 美元,同时模型权重已在 Hugging Face 上以 MIT 许可协议开源。
核心工作机制与问题类型
joey-1 的设计逻辑是避免生成需要应用层再次解析的自由形式文本。用户向模型发送状态(文本或图像)以及一个或多个问题,模型会为每个问题的选项输出概率分布。
目前,该模型支持三种标准化的问题类型:
- Choice(选择):从多个命名选项中选出唯一答案,例如判定工单归属的团队。
- Yes/No(API 中标记为 noul):直接返回事件发生或成立的概率。
- Score(评分):输出有序级别的评估,例如对任务紧急程度的优先级排序。
在架构层面,joey-1 基于 Qwen3.5-2B 进行了全量微调后训练,同时保持视觉编码器冻结。其全注意力层采用了块双向掩码技术。所有问题均从同一个共享前缀预填充中生成答案,这意味着增加额外问题时,计算成本的增幅极小。
训练配方与校准机制
为了确保模型输出的可靠性,Base Labs 在训练阶段引入了严格的校准机制。训练目标结合了交叉熵损失与 Brier 校准项,并专门训练了一个“我不知道”的选项,以处理模型置信度不足的情况。
具体的训练配置如下:
- 数据规模:包含 621 万个决策示例。
- 数据分布:58.3% 为核心决策技能,16.1% 为安全相关,16.1% 为评判与专家领域数据,9.5% 为公共数据。
- 训练参数:1 个 epoch,43,390 步,峰值学习率 1e-5,采用 bf16 精度。
- 硬件资源:2 个计算节点,每个节点配备 8 块 NVIDIA H100 GPU。
这种校准机制允许开发者设置置信度阈值。当 joey-1 对某个判断不够确定时,系统可以自动将任务升级路由至参数量更大的 elephant-1(9B)、mammoth-1(27B)或转交人工处理。
性能基准与成本优势
在性能表现上,joey-1 展现了小参数模型在特定任务上的效率优势。Baseten 官方数据显示,处理平均 2,000 token 的请求时,其 P50 端到端延迟仅为 20 毫秒。
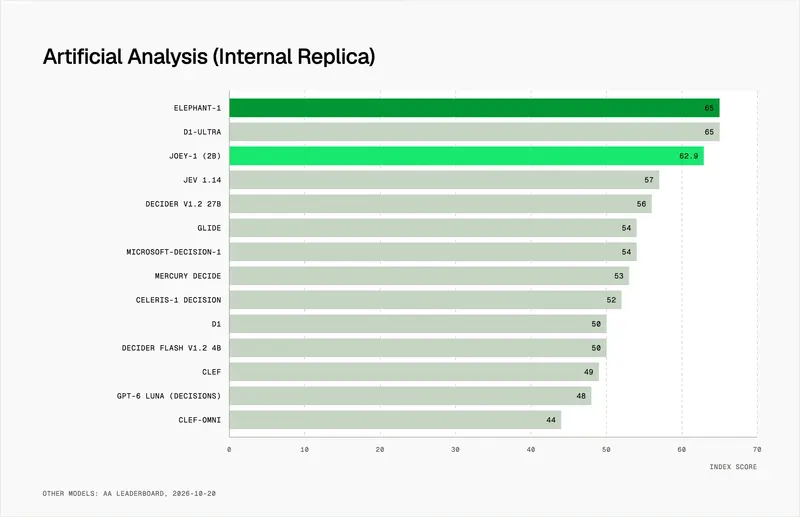
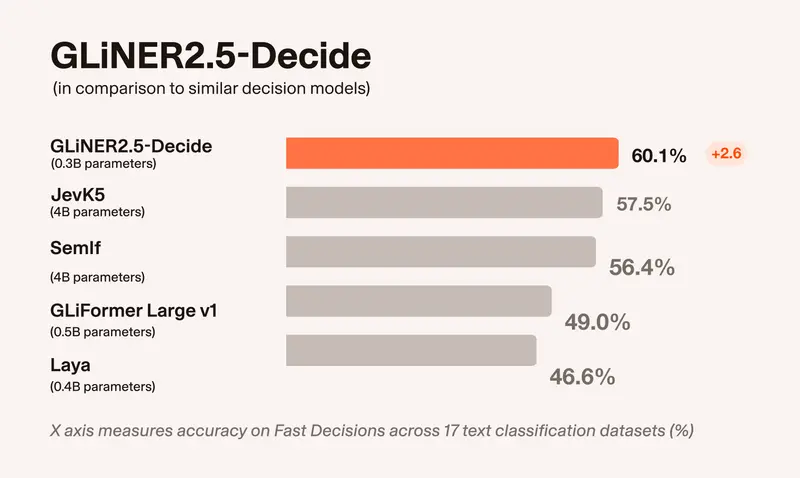
在 Jev Decision Index 0.4 公开拆分测试中,joey-1 取得了 63.30 的得分。在参与测试的 230 个模型中排名第 37 位,是参数量在 40 亿以下模型中的最高分。
尽管在绝对准确率上落后于其 90 亿参数的兄弟模型 elephant-1(得分 72.24,相差 8.94 分),但 joey-1 在成本控制上表现突出。其 API 计费标准为每 100 万输入 token 0.01 美元,输出和缓存输入均计为 0.00 美元。
以一个实际场景为例:若每月处理 1,000 万条支持工单,每条平均 500 token(总计 50 亿 token),使用 joey-1 的成本约为 50 美元,而使用 mammoth-1 则需约 500 美元。
部署选项与生态支持
joey-1 提供了灵活的部署方案,以适应不同规模的开发需求:
- Model APIs:通过
/v1/systemone接口调用decision-models/baseten-joey-2b-latest,默认开启零数据保留策略,保障隐私安全。 - 专用部署:面向企业级用户,解锁高达 262k 的上下文窗口,支持微调权重加载,并允许与现有的 LLM 工作负载共置部署。
- 自托管:开发者可从 Hugging Face 下载模型并运行
setup.sh。本地运行仅需 1 块 CUDA GPU,官方推荐使用 PyTorch 2.8 与 CUDA 12.8 镜像。
此外,joey-1 与 Baseten 近期发布的 mammoth-1 和 elephant-1 共享相同的训练数据与 API 接口规范。这意味着开发者在需要切换模型规模时,仅需修改一行代码即可完成平滑过渡。模型也支持通过 Baseten Training Jobs 进行定制化微调,并已在 OpenRouter 平台上架,维持每百万输入 token 0.01 美元的定价。
© 版权声明
文章版权归作者所有,未经允许请勿转载。