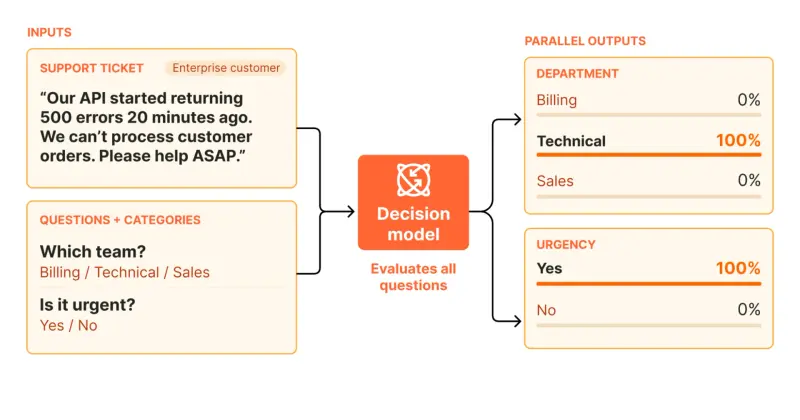
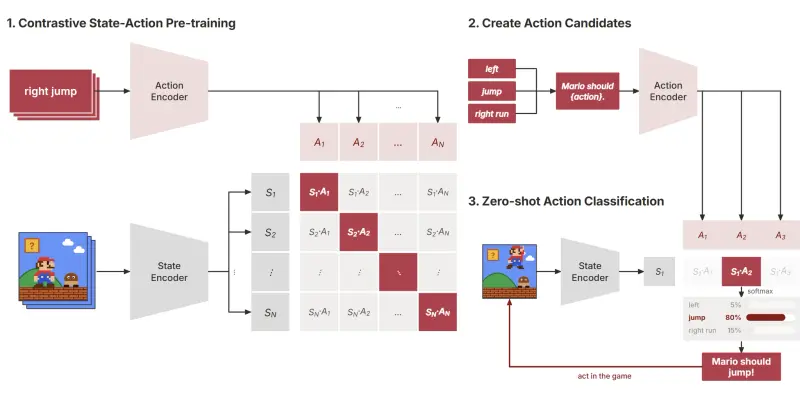
Contrastive-LM 推出 CLM-8B,是对比语言模型(Contrastive-LM,CLM)系列首款开源模型。它属于System One决策模型,不做文本生成,核心能力是针对当前环境状态,对一批候选动作打分并输出概率分布,对标TypeSafe AI的专有模型Jev,并且完全兼容Jev的API接口。
- 项目主页:https://contrastive-lm.notion.site/
- GitHub:https://github.com/Contrastive-LM/CLM
- 模型:https://huggingface.co/Contrastive-LM
可本地部署,投影头权重75MB,采用Apache-2.0协议;依托vLLM部署Qwen3-8B编码器,单张NVIDIA GPU即可在Linux环境运行。
核心技术原理
对比学习架构
- 双编码器解耦:状态编码器 + 动作编码器,各自为冻结 Qwen3-8B + 20M 可训练投影头
- InfoNCE 损失:将真实动作拉近当前状态嵌入,推远负例动作
- 推理即评分:softmax(状态·动作ᵀ) → 概率分布,无需自回归生成
- 缓存复用:
clm-serve类似 vLLM KV cache,重复状态访问延迟从 1.7ms → 0.6ms(RTX 4090, 3 动作)
三阶段训练配方
| 阶段 | 数据规模 | 来源 | Top-1 准确率 |
|---|---|---|---|
| 预训练 | ~60M QA 对 | Nemotron DQA | 52.1% |
| 中期训练 | ~30M 硬负例 | Gemini 2.5 Flash-Lite 合成 | 69.2% |
| 后训练 | ~1M 智能体轨迹 | Agent Data Protocol / Endless-Terminals / LiteCoder | — |
💡 关键发现:硬负例必须在中后期引入;从头训练会导致过拟合(峰值仅 62.4%)。
性能实测:vs Jev 全面对比
零样本决策任务
| 任务 | CLM-8B 延迟 | Jev 延迟 | 加速比 | CLM 成功率 | Jev 成功率 |
|---|---|---|---|---|---|
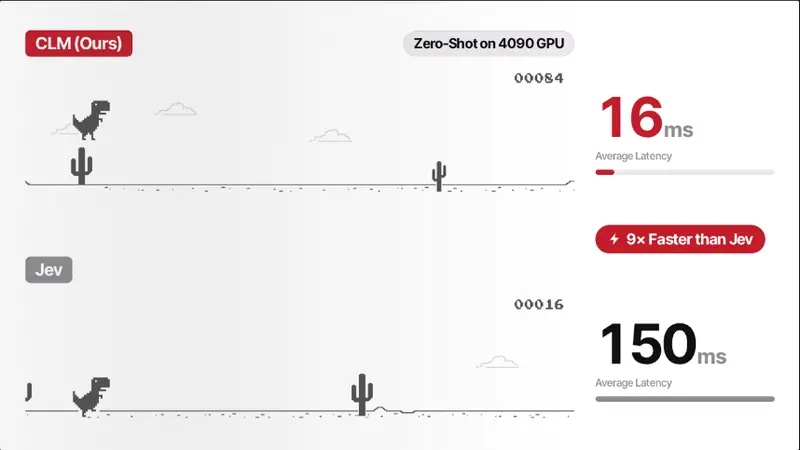
| T-Rex 游戏 | 16.5 ms | 149.8 ms | 9.1× | 5/5 | 5/5 |
| Super Mario | 33.5 ms | 132.6 ms | 4.0× | 5/5 | 5/5 |
| 工具调用 (BFCL v4) | 76.8 ms | 125.5 ms | 1.6× | 95.2% | 99.2% |
| WikiRacing | 79.8 ms | 225 ms | 2.8× | 26/30 | 30/30 |
编码验证器(微调 head)
| 基准 | Pass@1 | CLM-8B | Jev | CLM 延迟 | Jev 延迟 | 加速比 |
|---|---|---|---|---|---|---|
| DeepSWE | 73.7% | 81.6% | 71.1% | 79 ms | 449 ms | 5.7× |
| Terminal-Bench 2.1 | 84.0% | 87.6% | 83.1% | 32 ms | 131 ms | 4.1× |
⚠️ 注意:验证器结果为留出子集(38/30 任务),非完整排行榜提交;Jev 在两基准均低于 pass@1,表明其不适合做代码验证器。
部署与集成指南
- 硬件要求:单块 NVIDIA GPU(RTX 4090 / H100 等)
- 软件栈:Linux + vLLM(服务 Qwen3-8B 编码器)+
clm-serve - API 兼容:TypeSafe SDK 请求可直接重放;支持 Noul / Choice / Score 三类问题
- 许可:head 权重 Apache-2.0 ✅ 商用友好;Qwen3-8B 遵循原许可
- 缓存优化:智能体循环中状态频繁变化但动作集固定,缓存命中率极高
适用场景与边界
✅ 强烈推荐:
- 高频智能体决策循环(游戏、机器人控制、实时路由)
- 代码生成 best-of-N 验证器(替代 LLM-as-judge)
- 工具选择与意图分类(低延迟要求)
- TypeSafe 生态的开源替代方案
- 边缘/本地部署的 System One 组件
⚠️ 注意事项:
- 非生成模型:不能回答问题、写代码或聊天,仅用于评分/选择
- 零样本 vs 微调:零样本在复杂任务落后 Jev;生产环境建议针对领域微调 head
- 动作集需预定义:Choice/Noul 要求候选集显式声明,不支持开放式生成
- 验证器结果局限:DeepSWE/TB2.1 分数基于小样本留出集,泛化性待更大规模验证
- Qwen3-8B 依赖:编码器不可替换,模型总占用仍受基座大小约束
但请记住:再快的评分也只是概率,不是真理。用它加速循环,但别让速度取代审慎——因为有些决策值得慢下来思考,有些错误无法靠高频试错弥补。真正的智能,永远生长在快与慢的平衡点上。
© 版权声明
文章版权归作者所有,未经允许请勿转载。