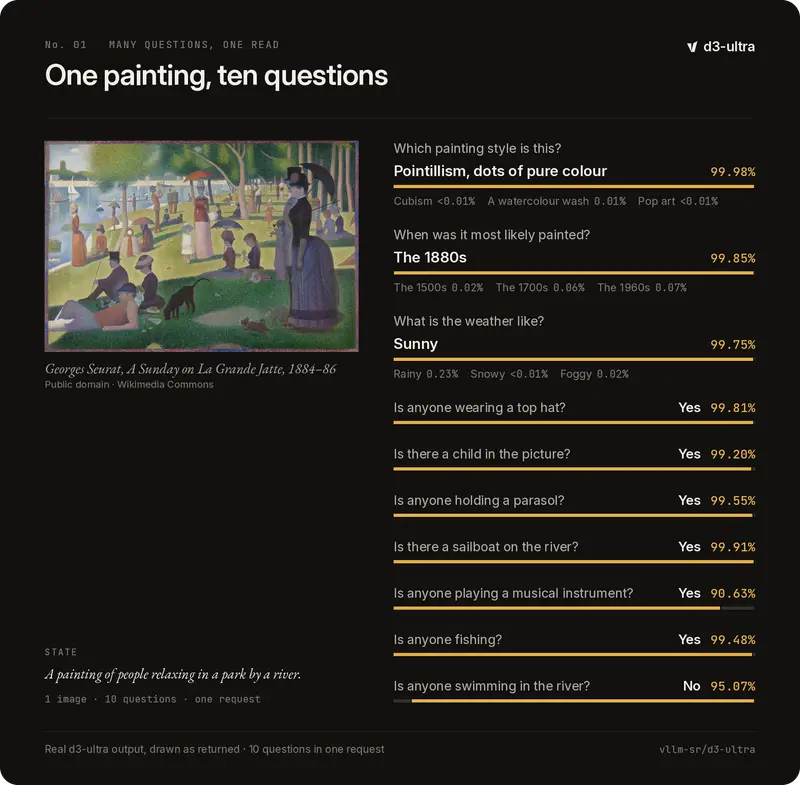
vLLM Semantic Router 推出 d3-ultra,属于 Decision 3.0 系列,260.9亿稠密参数(含4.6亿视觉编码器),Apache-2.0开源许可。它是一类特殊的决策模型,不生成自然语言文本:只读取一遍输入(文本/JSON+图像/视频),对一批问题分别输出概率,一站式完成路由、分类、视觉框选、视频目标跟踪。
- GitHub:https://github.com/vllm-project/semantic-router
- 模型:https://huggingface.co/collections/vllm-sr/decision-30
核心机制:单次读取,批量判题
骨干基于Qwen3.5架构,64层(48层线性注意力+16层全注意力),上下文上限 131072 token,超长直接报错、不会静默截断。
支持五类问题范式:单选、是/否概率、打分、图像Box定位、视频目标Track。
关键性能特点:输入只编码一次,之后批量回答大量关联问题。实测单张图片1个问题304ms;同一张图255个问题仅2.16秒,新增单题增量开销约7.3ms,非常适合Agent里批量校验、多维度打分场景。
测试硬件:单张AMD MI325X、BF16精度,暂无官方量化版本。
基准对比(团队私有测试集SR-Text / SR-Box)
- SR-Text(文本路由、工单、SQL校验等任务,机会校正得分):d3-ultra 87.2,高于GLiDE V1.2(85.1)、d3-turbo(83.1);仅艺术品味类子项略低于d1-ultra。
- SR-Box(图像目标框选,IoU≥0.5算正确):10领域综合58.2%,弱于同门d3-turbo的60.0%;团队说明,d3-turbo更擅长自然图像,d3-ultra图表识别更强。
四种部署方式
- Transformers:
transformers>=5.17.0加载,可搭配flash-linear-attention加速 - vLLM-SR引擎服务:
vllm-sr serve,10月25日并入主仓库 - 官方免费托管API:decision.vllm-sr.ai
- Hugging Face Space 在线Demo
和同类决策模型横向对比小结
d3-ultra、d3-turbo是少数开源、同时支持Box+视频Track的方案;GLiDE V1.2、d1-ultra、Jev 1.14要么不支持跟踪、要么不开权重。
取舍很清晰:文本决策、长上下文批量推理是强项;自然图像目标检测弱于d3-turbo。
提示:所有分数为项目私有测试集自报,还未在公开排行榜固化。
© 版权声明
文章版权归作者所有,未经允许请勿转载。