阿里AgentScope正式发布Piccolo决策模型系列,包含4B、9B和27B三个参数量级。该系列专为智能体(Agent)工作流设计,旨在给定当前状态、问题与候选项时,输出程序可直接调用的结构化判断与候选概率,适用于工具审核、上下文筛选、数据工作流及交互环境等场景。
- 项目主页:https://decisionplayground.agentscope.io/
- GitHub:https://github.com/agentscope-ai/Piccolo
- Hugging Face:https://huggingface.co/collections/agentscope-ai/piccolo
- 魔搭:https://modelscope.cn/collections/AgentScope/Piccolo
核心架构与评测表现
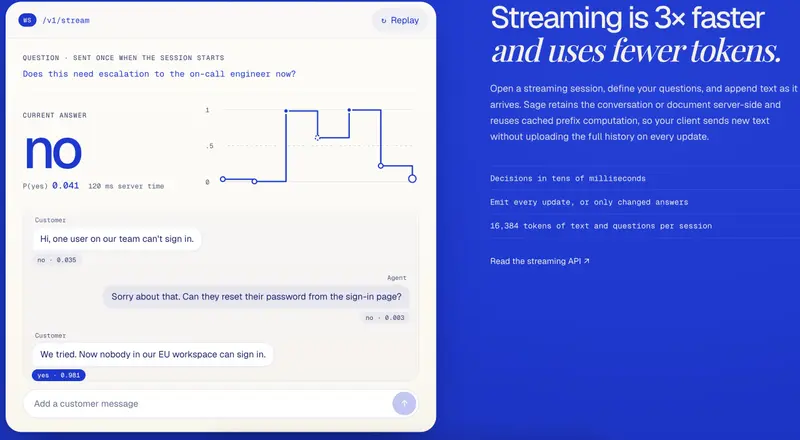
Piccolo 的设计目标是提供快速且结构化的决策支持。模型在全注意力层使用双向 prompt attention,保留线性注意力层计算,直接读取候选 token 的 logits 并进行归一化。通过原生接口返回结果,不生成冗余的回答文本,从而显著降低推理延迟。
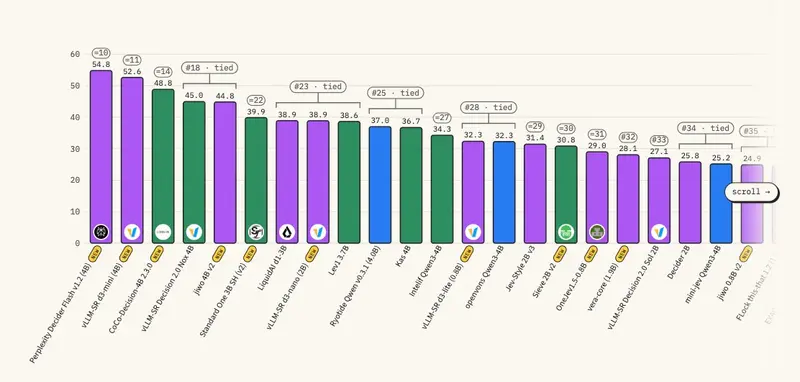
在基准评测方面,该系列模型展现出明确的性能梯度。在11月4日更新的11模型对比中,Piccolo-27B 在 JevBench Public 上取得 92.21% 的准确率,在文本 Decision Index Public 上取得 68.59 分,在多模态 Decision Index Public 上取得 77.75 分,多项指标位居前列。同时,Piccolo-9B 和 4B 版本在 JevBench Public 上分别取得 89.61% 和 87.01% 的准确率,为显存和计算预算受限的边缘部署场景提供了可行的替代方案。
基于递归自改进(RSI)的数据工程
Piccolo 的迭代依赖于一套基于递归自改进(Research Agent-driven Self-Improvement, RSI)的研发框架。该框架将模型优化转化为数据配方的循环迭代问题,具体流程为:诊断 → 数据选择与构造 → 训练评测 → 更新配方。
为了精准定位模型的能力缺口,研究团队使用 Qwen3.8-Max 对训练样本进行细粒度语义标注,建立了包含13个维度、551个预定义取值的标签体系。通过将软标签交叉熵分解为目标分布的熵与模型分布相对目标的偏差(KL散度),系统能够分离出模型对目标判断的拟合情况。
基于这种学习动态观测,Agent 会针对高偏差切片执行四类数据动作:
- 删除与降采样:清理错误与重复材料,降低已充分学习的同质样本权重,将计算预算分配给更有学习空间的内容。
- 筛选与配比:按标签、语义相似度和学习状态选题,组合定向数据与背景回放,在加强目标能力的同时维持已有能力。
- 题目校验与修订:补齐作答条件、校正目标标签,改写干扰选项并调整候选位置,以减少因缺条件或位置偏置造成的误学。
- 定向合成:引入自研 CuES 框架(种子 → 构造 → 核验 → 模型试答),围绕目标能力、任务机制和难度构造新题,扩展任务覆盖范围。
模型演进与多模态扩展
Piccolo 的演进过程强调数据覆盖、选题配比和监督方式的逐步优化。在多模态场景中,图文任务将数据选择细化到视觉信息与判断条件的组合。通过强化学习(如候选 GRPO 分支)调整所选图文数据的学习力度,并结合权重空间探索(Weight-Space Exploration),模型的多模态 Decision-Index Public 成绩从 77.03 逐步推进至 77.75。
此外,模型演进采用了“模型合版”策略。不同训练分支分别加强知识、偏好或工具使用能力,随后依据分项表现选择互补模型进行合版。例如,图文与文本分支的合版在同一模型上取得了文本 68.19 分、多模态 73.03 分的成绩。这一套数据工程与合版经验也被平滑延伸至 9B 和 4B 模型的训练中,确保小尺寸模型也能通过调整题目难度和数据配比获得显著的能力提升。
本地化部署与实际应用场景
在工程落地方面,Piccolo 已集成至 QwenPaw 主分支,支持本地化部署。用户可通过配置兼容的 llama.cpp 运行时,下载适合设备的 BF16 或 Q8_0 GGUF 格式模型。系统支持在会话模型中启用决策模型模式,并结合上下文压缩功能,在原生审批阈值和人工确认回退机制下独立运行,对话模型仍可使用其他提供商的服务。
目前,该模型已在两类典型场景中验证了其有效性:
- Harness(工作流控制):根据任务要求、权限、预算和运行状态,选择工具或模型,并判断任务是否完成。覆盖工具调用、模型路由、上下文管理、权限检查及失败恢复等决策。
- Data Processing(数据处理):根据原始材料、质量要求和校验结果,判断记录是否保留、采用何种清洗方案,以及处理结果是否满足使用或分享条件,涵盖数据过滤、产物质量评估与工作流控制。
© 版权声明
文章版权归作者所有,未经允许请勿转载。