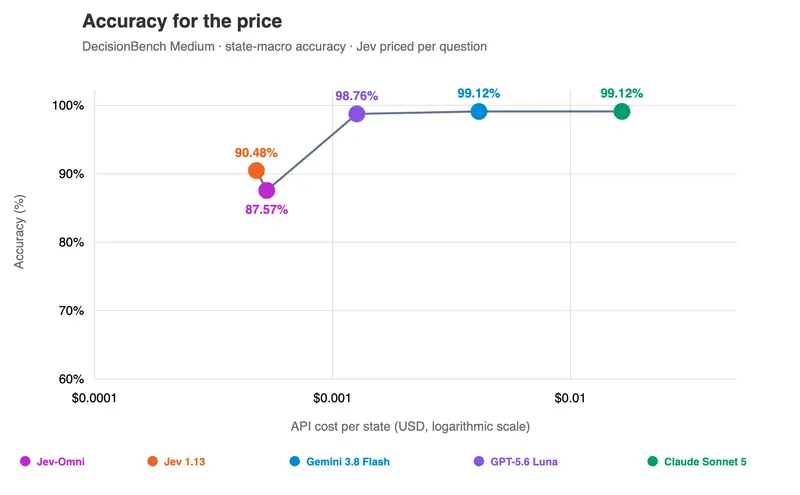
Interfaze AI正式开源 Lev,这是一款开放的System One决策模型,对标TypeSafe的Jev,采用相同API规范,可在你自己的单块GPU本地部署,全程不生成输出Token,直接读取logits输出校准后的概率,专门面向业务分类、工单路由、内容审核、意图识别这类确定性决策场景。
- GitHub:https://github.com/Abhinavexists/lev
- 模型:https://huggingface.co/interfaze-ai/lev
System One模型核心思路
传统LLM做分类任务需要逐Token生成文本,容易输出预设选项以外的内容、置信度不可靠,还要增加校验重试逻辑。
而System One模型接收一段状态文本(邮件、工单、JSON、评论)+ 一组带类型问题(二选一、单选、分级打分),单次前向传播并行完成全部问题推理,直接读取模型logits得到每个候选选项的概率,不存在编造标签的风险,并且概率经过校准。
过往分类方案对比
| 方法 | 原理 | 短板 |
|---|---|---|
| 关键词规则 | 关键词匹配触发路由 | 句式一变就失效 |
| 传统机器学习 | 单任务独立标注训练 | 缺少语言理解,一个任务一个模型 |
| 微调BERT | 编码器+分类头 | 标签固定,新增标签需要重训 |
| 零样本NLI | 每个标签构造一条假设 | N个标签就要跑N次前向,成本高 |
| LLM提示词 | 描述标签,输出JSON | 生成Token,容易出现非法标签,置信度不可靠 |
Jev 与 RLCD 训练范式
Jev是TypeSafe推出的首个System One模型,底层使用RLCD(校准决策强化学习),和RLHF、RLVR目标完全不同:
- RLHF:优化人类偏好,容易造成模型过度自信
- RLVR:优化可程序验证的输出,适合推理、代码
- RLCD:奖励诚实的概率,模型给出0.8置信度,就应该大约80%的情况正确
TypeSafe并未公开RLCD完整实现,Lev是社区侧的开源复现方案。
Lev 与 Jev 对比
| 项目 | Lev | Jev(TypeSafe) |
|---|---|---|
| 权重协议 | Apache-2.0开源 | 闭源API |
| 基座 | Qwen3.5-4B + LoRA适配器 | 参数规模未披露 |
| S1Bench总得分 | 68.9% | 76.1% |
| ECE校准误差(越低越好) | 0.115 | 0.091 |
| 输出Token | 0 | 0 |
| 候选选项上限 | 支持数百标签,无硬限制 | 最多255个 |
| 部署环境 | 本地GPU,H100验证,也可Mac/CPU运行 | 仅TypeSafe云端API |
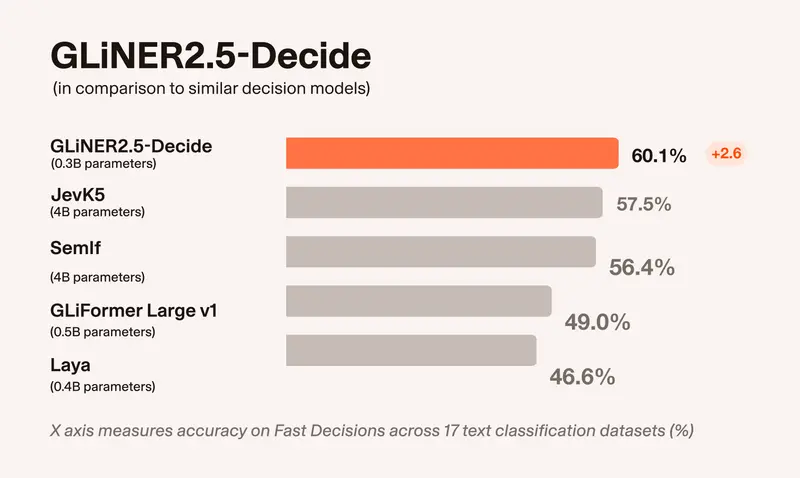
Lev在4B及更小的开源模型里属于S1Bench榜单顶尖水平,虽然整体精度略低于闭源Jev,但可以完全私有化部署,数据不用出本地服务器。
工作原理
- 标签Token读出:每个候选标签分配独立单Token编码,直接读取对应logits得到概率;
- 候选路径头:标签过多、Token编码用尽时,启用小头做文本匹配,突破标签数量限制;
- 概率校准:温度缩放把原始模型分数转为贴合真实准确率的可信概率;
两种机制自动路由,兼顾速度与标签容量。
关键工程优化
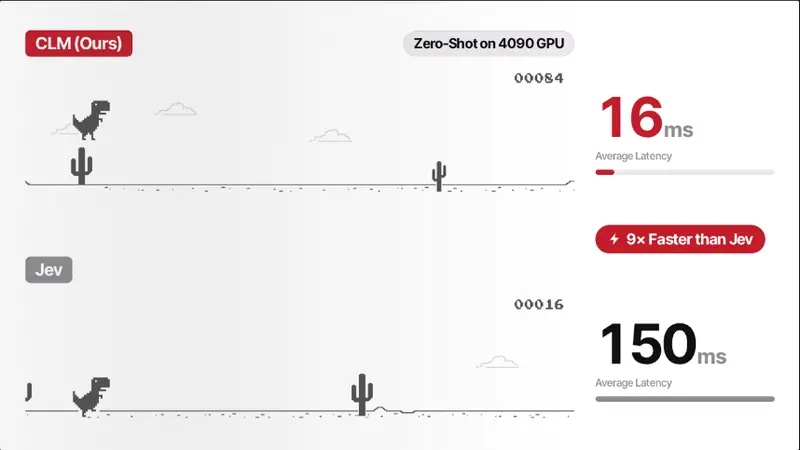
- 批处理单轮前向,去掉多问题分支缓存:推理从169ms降至69ms
- 大标签集优先标签编码:60类意图任务准确率提升51个点
- 跳过双Token标签编码:banking77数据集从0.818提升至0.980
- 沿用基座原生对话格式,训练前基线提升5.7个百分点
快速上手
环境:Python3.12+,CUDA GPU推荐;CPU可运行,但延迟会上升至数秒。
首次下载基座模型约8GB + LoRA适配器约200MB。
pip install "lev[serve] @ git+[https://github.com/InterfazeAI/lev#subdirectory=packages/lev](https://github.com/InterfazeAI/lev#subdirectory=packages/lev)"
支持两种调用方式:Python SDK,或者lev serve拉起HTTP服务,接口/v1/systemone和Jev完全兼容,原有Jev客户端仅更换base_url即可接入。
代码示例
import lev
model = lev.load("interfaze-ai/lev")
# 用户工单文本
state = "Hi, I was charged twice for my order #4471 and I want a refund."
# 一次性定义多个不同类型问题
questions = {
    "intent": {
        "type": "choice",
        "instructions": "What does the customer want?",
        "criteria": {
            "refund": "wants money back",
            "cancel": "wants to cancel an order",
            "track": "wants to know where an order is",
            "other": "anything else",
        },
    },
    "urgent": {"type": "noul", "instructions": "Does this need a human within the hour?"},
    "frustration": {
        "type": "score",
        "instructions": "How frustrated is the customer?",
        "criteria": ["calm", "mildly annoyed", "annoyed", "angry"],
    },
}
result = model.system_one(state, questions)
print(result.answers["intent"].choice)
print(result.answers["intent"].probabilities)
print(result.answers["urgent"].noul)
print(result.answers["frustration"].score)
print(result.usage.output_tokens) # 输出0,无生成token
Lev vs Interfaze
Interfaze是同团队的混合方案,Lev是其衍生的纯决策模型:
| Lev | Interfaze | |
|---|---|---|
| 输出形式 | 纯概率,0输出token | 生成token,返回结构化JSON |
| 问题类型 | 仅三类带类型任务:是/否、单选、打分 | 完整JSON Schema,支持更多任务 |
| 单次请求能力 | 仅分类决策 | 可同时OCR、网页检索、文本提取+分类 |
| 部署 | 本地GPU | 云端API |
基准测试信息
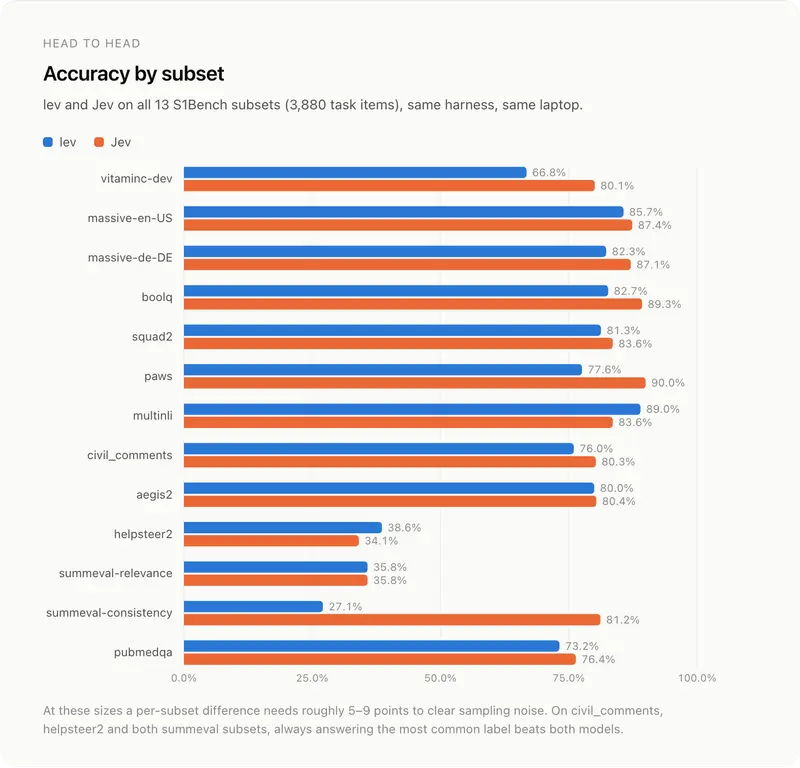
整套评测在S1Bench全部3880条样本完成,使用统一harness,Jev复现结果与官方公布分数误差仅0.8个点,排除评测框架带来的差距。
- 准确率:Jev在Paws、Vitaminc、摘要忠实类任务优势明显;Lev在mnli、helpsteer2子集小幅领先(处于噪声区间)
- 校准表现:13个子集中有5项Lev的校准误差优于Jev
- 在4B及以下公开模型的横向对比,Lev位列榜首梯队
适用场景
客服工单意图路由、评论内容审核、用户情绪分级、事件优先级判定、B端表单自动归类。适合低延迟、高稳定、需要可信置信度的自动化业务判断,不再依赖LLM生成+校验重试链路。
© 版权声明
文章版权归作者所有,未经允许请勿转载。