AWS正式发布 Strands Decider 2B,一款可本地运行的轻量级决策模型,对标TypeSafe Jev决策模型,专门放在AI智能体执行动作前做快速校验,避免产生无效、虚构输出。不同于OpenAI刚推出的托管Decisions API,AWS本次直接开放可下载权重、训练数据集与训练脚本。
- GitHub:https://github.com/strands-labs/strands-decider
- 模型:https://huggingface.co/StrandsAgents/strands-decider-2B-hobson-v19
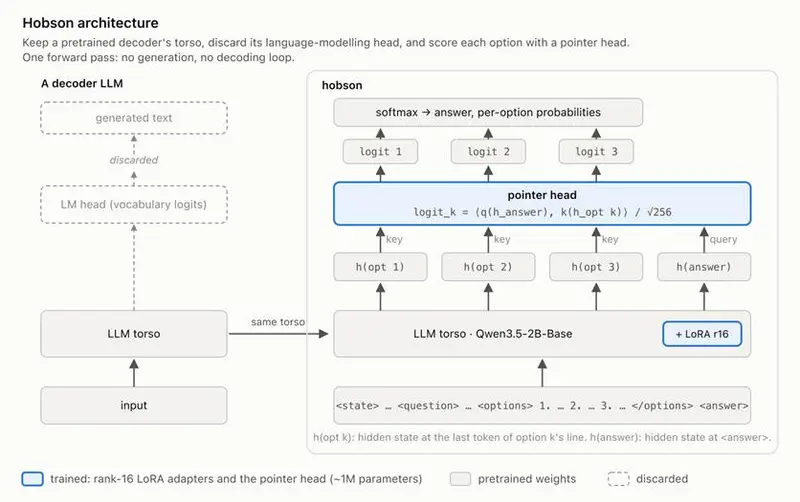
工作原理
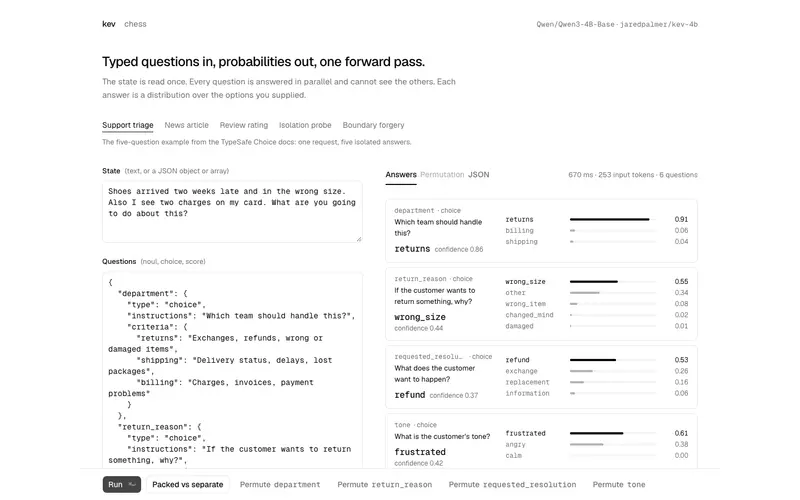
决策模型不再自由生成文本,而是在给定候选选项里做选择、输出置信分数。适合请求路由、工具选择、结果评估、动作校验;复杂对话与内容生成任务依旧交给主大模型。
- 基座主干:Qwen3.5-2B,移除原生文本生成头,替换成选项评分指针头(仅一百多万参数)
- 微调方案:主干采用rank-16 LoRA低秩适配
- 核心优势:输出被限定在预设选项集合,不会凭空编造不存在的答案;同时返回置信分数,决策延迟更低。模型依然存在判断错误的可能性,属于取舍设计。
智能体前置校验场景
搭配AWS开源Strands智能体框架演示:用户查询天气但未指定城市,智能体擅自猜测地点并准备调用天气工具。
在工具调用执行前,Strands Decider本地运行,校验参数是否有对话上下文支撑、信息是否充足。校验发现信息缺失,拦截本次工具调用,让智能体回头向用户询问城市。
开发者可自定义干预策略:放行调用、拒绝执行、人工复核、反馈修正指令。
架构混合部署示例:Decider本地运行,生成大模型通过Amazon Bedrock云端调用;AWS同步开发决策模型集成库。
评测与性能
在JevBench公开测试集:
- 在2B参数量级公开模型里排名第二;在附带完整训练配方的公开模型中位列第一
- JevBench简单任务集全部答对,刚好匹配智能体日常例行判断场景
实测延迟:
- RTX3090:决策耗时100ms以内
- M3 Mac:轻量任务中位数约150ms
任务复杂度提升时,响应时间会随之增加。
模型为第二代迭代版本,初代头结构效果较差;所有历史迭代版本全部存入仓库,方便开发者追溯演进过程。
项目孵化自Strands Labs,延续此前发布的Strands Harness持久智能体工具栈。
和Kev一样,Strands Decider依托开源Qwen基座,也体现当前决策模型赛道大量依赖开源权重的现状。
待确定规划
目前仅发布本地部署版本,AWS尚未官宣是否会在云端提供该模型的托管服务。本地运行适合原型实验,生产落地场景开发者期待托管版本上线。
© 版权声明
文章版权归作者所有,未经允许请勿转载。