Respan 推出 Span-01,一款面向AI模型监测评估的专用决策分类模型,也被称作质检专用版Jev。它用来核验其他AI输出,识别越狱攻击、隐私泄露、幻觉胡编、工具调用错误等异常行为,兼顾判断精度、推理速度与调用成本。
- 申请地址:https://www.respan.ai/blog/introducing-span-1
传统AI质检方案痛点
目前团队评估、监控AI输出主要两种路线:
- 传统固定分类脚本:速度快,但泛化弱,遇到从未见过的新规则、新场景极易失效;
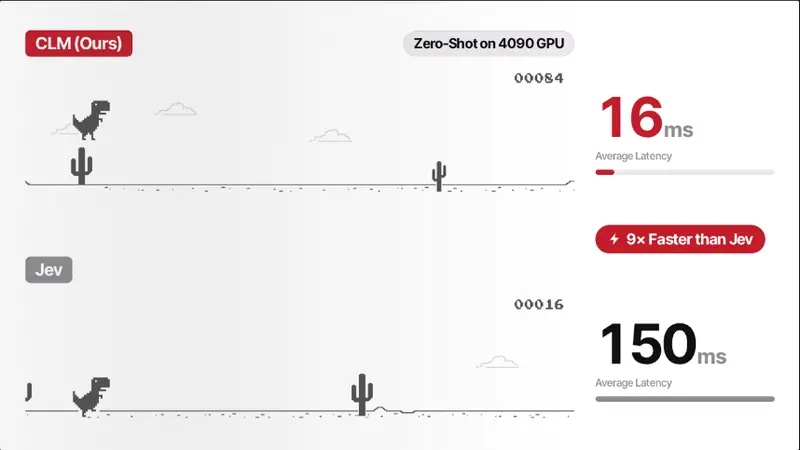
- 通用大模型打分:判断能力强,但需要逐token生成文本,速度慢、token开销高昂,大批量生产监控成本压力大。
Span-01 的核心创新:一次前向传播完成推理+判定,不需要逐Token生成,并行评估多条自定义规则,直接输出概率。
模型可以读取完整长对话轨迹,同时核对多组临时新增的判定规则,适配业务随时新增的检测标准。
核心原理:超级并行推理分类
Span-01 先通过RLAIF完成通用分类推理训练,不是死记固定标签与分类体系,重点学习把全新自然语言规则应用在陌生上下文。
推理阶段会开启多并行定义分支,在同一条完整会话trace上,一次性并行评估多条待检测行为;依靠混合注意力机制,在长复杂对话轨迹中维持推理能力。
输出结果为三类概率:present(存在该问题)、absent(不存在)、not_observable(信息不足无法判断)。
核心理念概括:先推理,一次分类。分类难点不在于输出标签,而是将从未见过的规则,套用到陌生的对话上下文。
基准测试表现
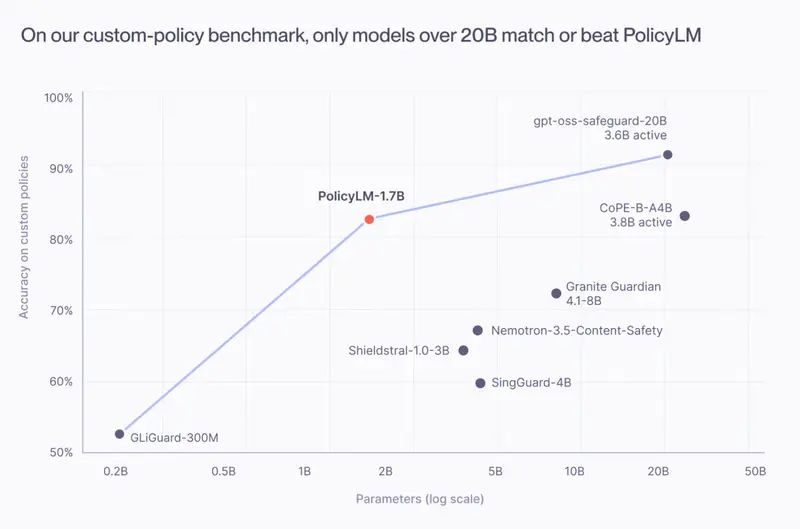
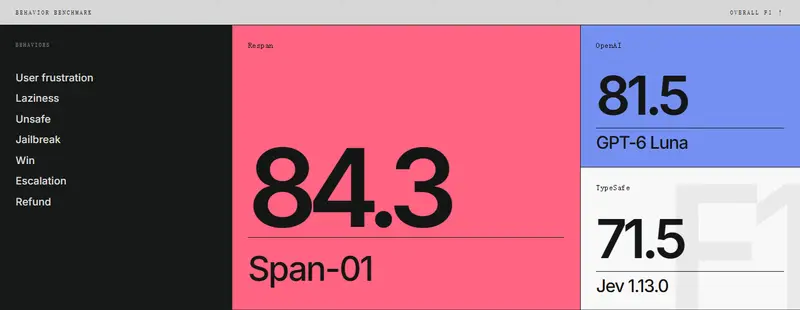
- 跨9个模型、英文+多语言的AI行为检测基准,Span-01综合排名第一;免费版本Span-01 Lite的表现,超越Jev以及Sonnet 5。
- 评估维度拆分为安全、可靠性、事实接地、Agent行为、响应质量,避免单一聚合总分掩盖局部故障信号。
- 反向基准实验:把Span-01当作评测层,评估11款新兴决策模型,检测它们的准确率、一致性、注入抵抗、概率校准能力。Span-01本身不参与榜单排名,仅作为评判工具。
官方同时注明:顶级前沿大模型依旧是判断能力的上限。
版本与定价
- Span-01 Lite:完全免费,满足基础AI行为监控需求
- 完整版 Span-01:每百万输入词元 0.02 美元
适用场景
- 生产环境大模型实时监控:识别越狱提示注入、隐私信息泄露、幻觉输出
- Agent链路检测:捕获工具调用参数错误、循环调用、任务异常终止
- 模型评测流水线:批量评估候选模型、决策模型(如Jev/Tev1)的稳定性与校准度
- 自定义规则质检:随时用自然语言新增检测标准,不用重新训练分类器
© 版权声明
文章版权归作者所有,未经允许请勿转载。