极创工作室 (EM-GeekLab)正式推出 KnowLine 决策模型系列。该系列专为检索增强生成(RAG)、智能体(Agent)框架及企业级工作流设计,提供从 0.8B 到 31B 的稠密模型以及混合专家(MoE)选项。该系列模型的核心设计目标是将结构化状态与类型化问题直接映射为候选选项的概率分布,从而为自动化系统提供低延迟、高可靠性的结构化判断。
- Hugging Face:https://huggingface.co/PelaAI/models
- 魔搭:https://modelscope.cn/collections/EMLab/KnowLine-Decision
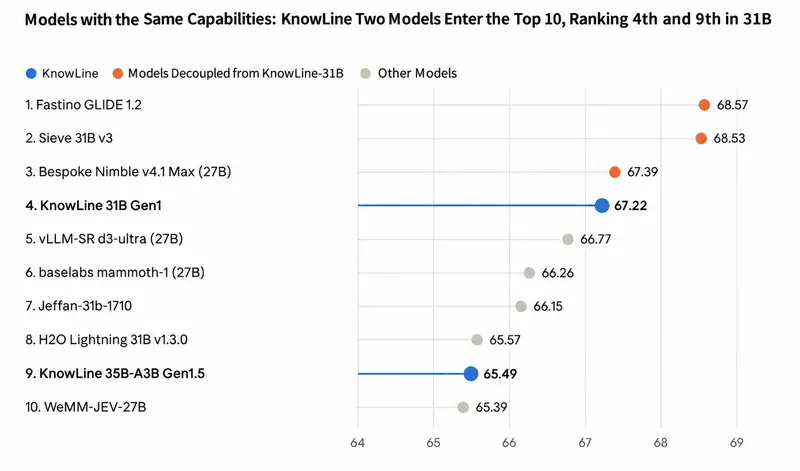
核心架构与工作机制
KnowLine 系列在架构设计与训练流程上采取了明确的工程优化策略,以适配程序化调用需求:
- 结构化概率输出:模型在决策过程中不生成自由格式的文本,而是针对每个问题执行一次前向传播,直接读取并输出每个选项标签 token 的概率。读出温度(Readout Temperature)已预先折叠进语言模型的最终归一化层权重中,前端可直接以温度 1.0 进行读取,确保概率校准的稳定性。
- 智能体驱动的数据迭代:模型的训练与优化由 AI 智能体端到端闭环管理。在每一轮迭代中,智能体负责识别模型薄弱环节、提出针对性数据组、执行数据构建与去污染、进行训练与评估,并最终根据实证结果决定保留或回滚更改。
- “读取两次”推理优化:针对部分版本(如 Gen2.5、Gen5.5、Gen1.5),在模型权重保持不变的前提下,前端服务层引入了针对短请求(不超过 3,000 token)的“双重读取”机制。即在模型生成回答前,将完整输入再次写入。实测表明,该机制在不增加额外训练成本的情况下,有效提升了长输入场景下的推理与推断能力。
关键性能指标与工程特性
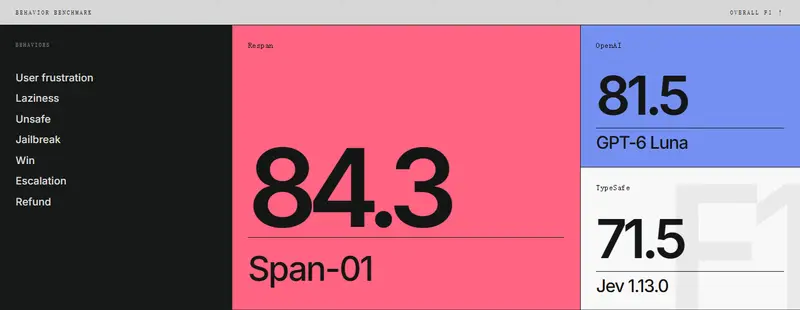
在多项基准测试中,KnowLine 系列展现了明确的性能梯度与工程效率:
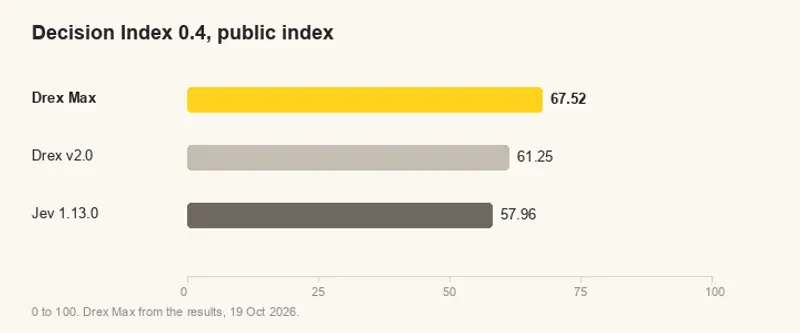
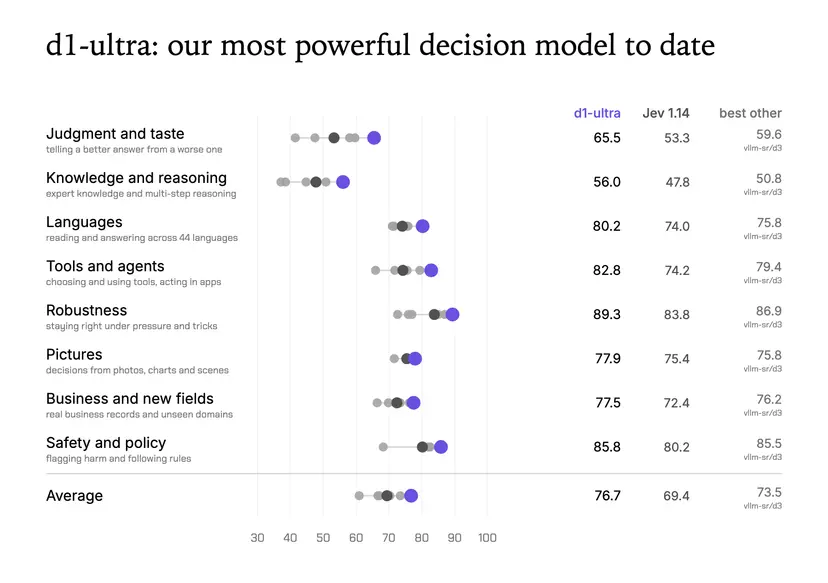
- 私有测试集表现:KnowLine-31B-Gen1 在结合私有同技能与新领域测试的 Jev Decision Index 0.4.1 Full 上取得 71.86 分,排除了公开套件结果,展现了其在封闭环境下的决策上限。
- 稀疏激活与低延迟:基于 MoE 架构的 KnowLine-35B-A3B-Gen1.5(总参数 35B,每 token 激活约 3B 参数)在单块 RTX PRO 6000 设置下,中位延迟仅为 47.1 毫秒,实现了高性能与低计算开销的平衡。
- 概率校准与鲁棒性:在 31B 模型的公开套件评估中,以至少 95% 置信度做出的决策中,错误率控制在 0.9% 至 1.0% 之间。同时,模型在面对植入指令(Prompt Injection)时表现出较强的抵抗力,多数版本在使用未见过的注入模板时,回答被引导至植入选项的比例低于 5% 的安全目标。
模型矩阵与具体规格
KnowLine 系列根据参数量与架构差异,划分为三个主要梯队,以满足不同算力预算的部署需求:
1. 轻量级边缘部署模型 (0.8B, 2B, 4B)
- KnowLine-0.8B-Gen1 / 2B-Gen1:分别基于 Qwen3.5-0.8B 和 2B 构建。在单张 H20 GPU 上逐个处理请求,中位延迟分别为 24.6 毫秒和 30.0 毫秒,适合对延迟极度敏感的边缘设备或高频并发场景。
- KnowLine-4B-Gen5.5:基于 Qwen3.5-4B,采用“读取两次”机制后,其在 Decision Index 0.3 公开测试集上的得分从 65.67 提升至 66.75,长文本推理能力得到针对性增强。
2. 中型与 MoE 架构模型 (9B, 26B-A4B, 35B-A3B)
- KnowLine-9B-Gen1:基于 Qwen3.5-9B,主要面向纯文本决策任务,支持最多 255 个命名选项的复杂选择题。
- KnowLine-26B-A4B-Gen2.5:基于 Gemma 4 26B MoE 架构(激活 4B 参数)。Gen2.5 版本通过双重读取机制,将 Decision Index 0.3 得分从 66.94 提升至 68.21,且在新领域决策任务上得分从 60.6 提升至 66.4。
- KnowLine-35B-A3B-Gen1.5:基于 Qwen3.5-35B MoE 架构(激活 3B 参数)。在引入双重读取机制后,其在 Decision Index 0.3 测试集上取得 70.72 分,并在长输入推理任务中表现出显著增益。
3. 旗舰稠密模型 (31B)
- KnowLine-31B-Gen1:基于 Gemma 4 31B 稠密架构。该模型不仅继承了智能体驱动的数据循环训练优势,还保留了基座模型的视觉塔。尽管未进行多模态微调,它在 Decision Index 0.3.1 视觉测试集上仍取得了 69.9 分,并具备零样本返回图像边界框的能力(如 ScreenSpot 中心命中率达 81.3%)。
部署兼容性与开源生态
KnowLine 系列在设计上高度兼容现有的工程生态。其 API 接口与 Jev 协议保持兼容,现有客户端仅需更改基础 URL 或模型名称即可无缝接入。模型支持通过 ms-swift 框架进行持续的后训练(Post-training),允许企业根据自身业务数据定制决策逻辑。
在开源协议方面,所有模型权重均采用 Apache 2.0 协议发布,配套的服务代码(如 serve_knowline.sh 和 knowline_server.py)采用 MIT 协议,为企业级应用提供了明确的法律合规保障。
© 版权声明
文章版权归作者所有,未经允许请勿转载。