Liquid AI 今日正式发布其最新一代全模态(omnimodal)决策模型 d1.2 和 d1.2-ultra。此次更新不仅引入了对音频输入的支持,还新增了五项关键的结构化提取与定位任务。在 Artificial Analysis Decision Index v2.1 基准测试中,d1.2-ultra 以 75 分的成绩位居所有决策模型之首,并在成本效益方面表现出色。
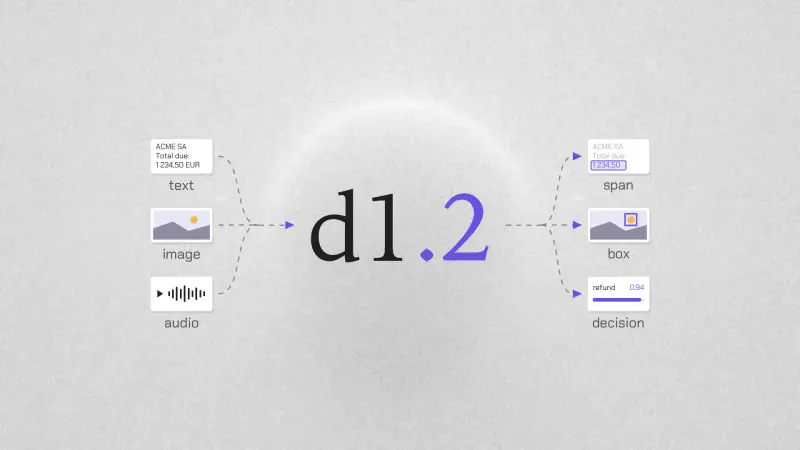
核心升级:音频支持与五项新任务
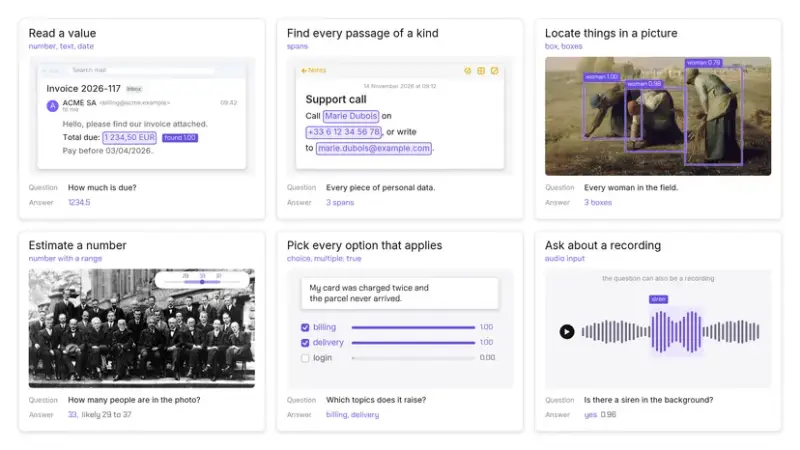
d1.2 系列模型现在能够处理音频输入,用户可以直接通过语音提问或让模型分析背景声音(如警报声、语言识别)。此外,API 新增了五种高精度的结构化任务能力:
- 数值/文本提取:从发票、收据等非结构化文本中精确读取特定值(如金额、日期),若未找到则返回“未找到”而非猜测。
- 敏感信息定位:在长文本中识别并定位每一处个人数据(PII),如姓名、电话、邮箱,并返回其在文本中的具体位置。
- 视觉对象定位:在图片中框出指定物体(如签名、树木),返回矩形坐标及实例计数。
- 数量估算:估算照片中物体的数量,并提供最佳猜测值及置信范围(例如:12人,范围10-14)。
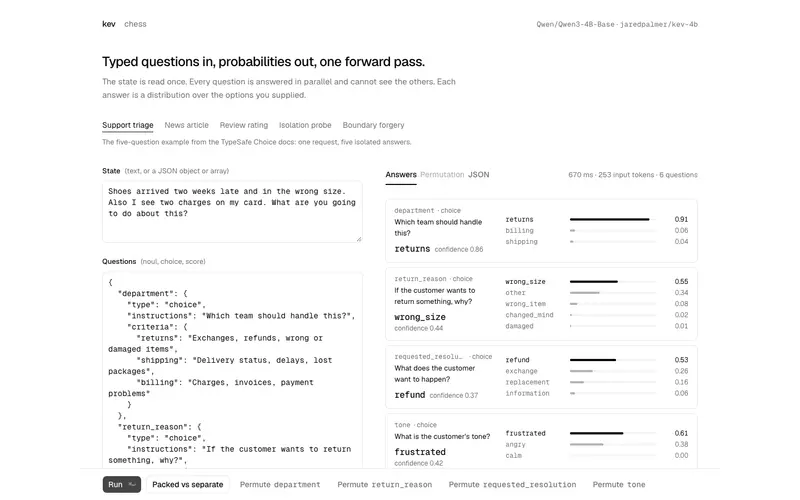
- 多选分类:针对支持消息等场景,选择所有适用的主题标签,并为每个选项提供概率值。
性能基准:精度与校准的双重领先
在 Artificial Analysis Decision Index v2.1 中,d1.2-ultra 取得了 75 分的最高成绩,比此前的最佳模型高出 2 分。更重要的是,它在概率校准方面表现卓越:
| 模型 | 校准误差 (Calibration Error) | 备注 |
|---|---|---|
| d1.2-ultra | 0.8 | 极低误差,概率预测高度可信 |
| d1.2 | 1.2 | – |
| Jev 1.14 | 2.7 | – |
| Perplexity Decider v1.3 | 3.7 | – |
| GPT-6 Luna | 7.2 | – |
低校准误差意味着当模型表示有 80% 的把握时,其正确率确实接近 80%,这使得开发者可以可靠地设置自动化阈值,将低置信度任务转交人工审核。
新任务准确率表现
在内部构建的保留测试集上,d1.2-ultra 展现了极高的鲁棒性:
- 收据数值读取:98% (d1.2: 96%)
- PII 信息定位 (精确率/召回率):94% / 93% (d1.2: 92% / 88%)
- 视觉对象定位:94% (d1.2: 94%)
- 物体数量估算:93% (d1.2: 92%)
- 音频理解 (ESC-50/FLEURS):95% – 97% 准确率
定价与可用性
d1.2 系列模型现已通过 Liquid API 开放,采用极具竞争力的按输入 Token 计费模式:
- d1.2:$0.02 / 百万输入 Token
- d1.2-ultra:$0.042 / 百万输入 Token
计费说明:
- 仅对输入 Token 计费,输出免费。
- 图像按每 32×32 像素补丁 1.5 Token 计费(例如 1024×1024 图像约为 1,536 Token)。
- 同一请求中的多个问题仅额外增加问题文本的 Token 消耗。
未来,d1.2 系列还将上线 OpenRouter 和 Vercel 平台。对于需要高精度结构化数据提取、多模态决策及高可靠性概率输出的开发者而言,d1.2 系列提供了一个高效且经济的新选择。
© 版权声明
文章版权归作者所有,未经允许请勿转载。