Perplexity 正式推出其开源决策模型系列的最新版本 pplx-decider-v1.3 及轻量版 pplx-decider-flash-v1.3。作为专为结构化决策设计的非生成式模型,Decider v1.3 不再输出自然语言文本,而是直接返回选项概率。此次更新的核心亮点是引入了 Locate 功能,能够根据指令或标签从文本中精确提取片段,进一步拓展了其在命名实体识别(NER)、PII 检测及抽取式问答中的应用场景。所有权重均以 Apache 2.0 协议在 Hugging Face 上开源。
- pplx-decider-v1.3:https://huggingface.co/perplexity-ai/pplx-decider-v1.3
- pplx-decider-flash-v1.3:https://huggingface.co/perplexity-ai/pplx-decider-flash-v1.3
核心架构:从生成到分类的范式转变
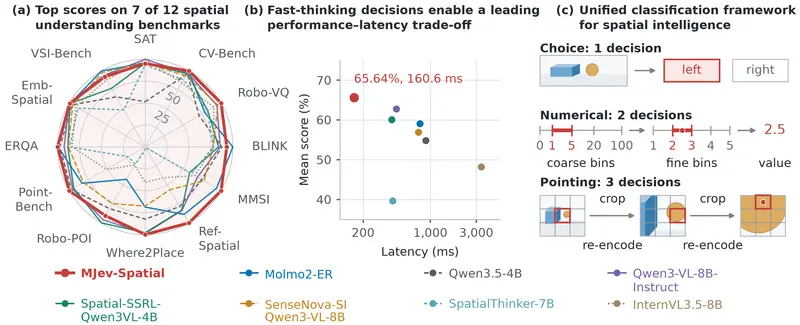
Decider 系列受 TypeSafe 的 Jev 模型启发,将生成式 LLM 骨干网改编为高效分类器。其技术演进主要体现在以下方面:
- 双向注意力机制:全注意力层被调整为双向模式,消融实验表明这显著提升了分类性能。
- 隔离的问题注意力:在 v1.3 中,每个问题仅关注全局“状态”和自身,避免了 v1.2 中问题间相互干扰导致的答案偏移。所有关于同一输入的问题仍在单次前向传递中并行处理。
- 三阶段训练策略:包括数百个公共数据集的全量微调、LoRA 专业化适配器训练以及 LoRA 视觉适配器训练。Flash 版本则通过最小化与大模型输出的 KL 散度进行蒸馏。
新增功能:Locate 精确提取
Locate 功能是 v1.3 的重大突破。它通过引入新的 <|locate|> token 和专用的跨度头(Span Head),能够返回带有精确字符偏移量的文本片段。
- 灵活指令:支持短标签(如 “location”)或自然语言指令(如 “提取工作所在城市的名称”)。
- 独立适配器:Locate 使用独立的 LoRA 适配器,且保持未合并状态,以确保不损害主决策头的准确性。
- 应用场景:特别适用于 NER、敏感信息(PII)检测及需要从长文中定位关键信息的抽取式 QA 任务。
性能基准:全面领先竞品
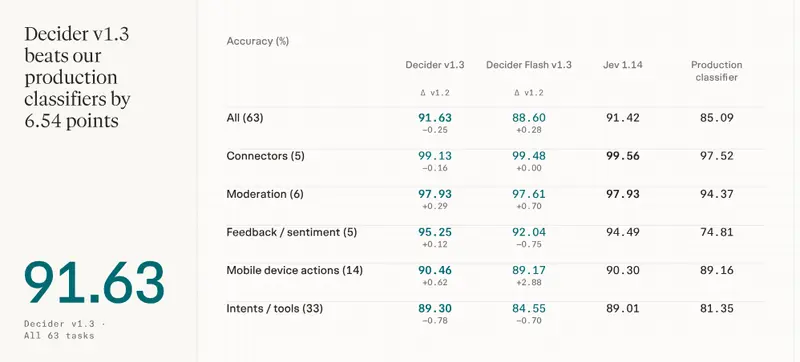
根据 Perplexity 的自我报告数据,Decider v1.3 在多项评估中表现优异,尤其在稳健性和多语言能力上超越了 TypeSafe 的 Jev 1.14。
| 评估维度 | Decider v1.3 | Decider Flash v1.3 | Jev 1.14 (竞品) | 备注 |
|---|---|---|---|---|
| 查询分类 (63任务) | 91.6% | – | – | 比生产分类器高 6.54 分 |
| 领域分类 | 全面领先 | 金融/编程/法律略弱 | – | 金融领域最多高出 12.9 分 |
| 检索重排序 (nDCG@10) | 83.99 | – | 81.75 | 优于 Qwen3-Reranker-8B |
| 多语言 (19任务) | 88.16% | 86.50% | 85.41% | 覆盖 8 种语言 |
| Locate 提取 (17任务) | 69.0 | 63.6 | – | 远超 Liquid d1 (43.3) |
| 图像分类 | 76.99% | 72.77% | 75.52% | – |
| 答案翻转率 (稳健性) | 0.27% | – | 2.69% – 4.84% | 极低的重排/重标记敏感度 |
部署与定价
开发者可以通过 API 或本地部署两种方式使用 Decider v1.3:
- API 服务:
- 端点:
POST https://api.perplexity.ai/v1/decisions - 定价:v1.3 为 $0.02 / 百万输入 Token;Flash 为 $0.01 / 百万输入 Token。输出免费。
- 延迟:处理约 243K Token 的请求,v1.3 耗时约 16 秒,Flash 仅需 5 秒。
- 端点:
- 本地部署:
- 硬件需求:v1.3 (BF16) 需约 49 GiB 显存;Flash 需约 8.5 GiB。
- 运行环境:CUDA GPU,Python 环境。需使用
pplx_decider包加载,并确保全注意力层以非因果方式运行。 - 推荐场景:v1.3 适用于细微的评分标准和复杂分类;Flash 适用于高容量的路由和简单决策。
© 版权声明
文章版权归作者所有,未经允许请勿转载。