前 OpenAI 研究员、RLHF(人类反馈强化学习)共同发明人 Diogo Almeida 创立的 TypeSafe AI 正式发布了一款名为 Jev 的新型 AI 模型。
- 地址:https://typesafe.ai
与 ChatGPT 或 Claude 等旨在与人自然对话的模型不同,Jev 被设计为“机器原生的智能组件。它不生成自然语言文本,而是直接输出类型化的概率决策。这种范式转移旨在解决当前 LLM 在自动化工作流中面临的延迟高、成本高、易幻觉和解析困难等核心痛点。
核心突破:从“生成器”到“决策函数”
Jev 的核心逻辑是将大模型从“会聊天的作家”转变为“软件可调用的概率决策函数”。
| 特性 | 传统 LLM (如 GPT-5.6) | Jev (TypeSafe AI) |
|---|---|---|
| 输出形式 | 自由文本字符串 (Token by Token) | 类型化结构化数据 (JSON/Probabilities) |
| 推理方式 | 顺序生成 (Sequential) | 并行采样 (Parallel System One) |
| 主要用途 | 对话、创作、通用推理 | 分类、路由、打分、抽取、微决策 |
| 延迟 | 秒级甚至分钟级 | 70ms – 500ms (快 40-200 倍) |
| 成本 | 输入 $2/M, 输出 $12/M | 输入 $0.042/M, 输出 $0 (便宜 5-238 倍) |
| 可靠性 | 需额外解析验证,存在类型错误风险 | Schema 内约束,无类型错误,自带置信度 |
技术架构:System One 与 RLCD
Jev 背后是一套全新的技术栈,旨在模拟人类直觉式的快速反应(System 1 Thinking),而非缓慢的逻辑推导(System 2)。
- 并行概率决策:
- 传统 LLM 像打字机一样逐个预测下一个 token。
- Jev 采用并行处理架构,一次性返回查询的所有可能结果及其概率分布。例如,面对客服分流问题,它直接返回
{"billing": 0.08, "technical": 0.85, "sales": 0.07},并附带整体置信度分数。
- RLCD (Calibrated Decision Reinforcement Learning):
- 这是一种新的训练方法,专注于校准决策的准确性而非语言的流畅性。通过强化学习,模型学会在预定义的模式(Primitives)如
Choice(选择)、Score(打分)、Noul(未知/拒绝)中做出最优判断。
- 这是一种新的训练方法,专注于校准决策的准确性而非语言的流畅性。通过强化学习,模型学会在预定义的模式(Primitives)如
- 零幻觉结构:
- 由于输出被严格限制在预定义的 Schema 内,Jev 不会产生“伪造法律引用”或“编造事实”这类传统幻觉。它可能会给出错误的概率判断,但绝不会输出非法格式或无法解析的乱码。
应用场景:基础设施层的“智能 If”
Jev 瞄准的是那些需要海量、高频、低延迟微决策的场景,充当业务系统中的“智能路由器”或“判断器”。
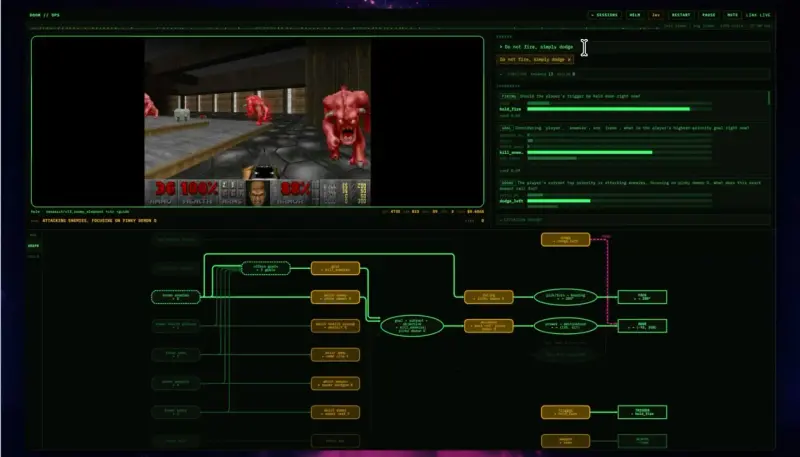
- 游戏 AI:演示中,Jev 能根据《毁灭战士》的游戏状态数据,实时做出移动和射击决策。
- 客服路由:自动分析用户投诉(如“我的卡被扣了两次”),以极高准确率将其分流至技术部、财务部或销售部。
- 数据清洗与分类:在 Map-Reduce 作业中快速对非结构化数据进行打标、分类和抽取。
- 实时风控:在毫秒级时间内对交易进行风险打分和拦截。
- Agent 工具调用:作为 Agent 的底层判断模块,决定下一步调用哪个工具,避免因幻觉导致的工具调用失败。
争议与挑战:杰文斯悖论
Jev 的名字致敬了 19 世纪经济学家威廉·斯坦利·杰文斯(William Stanley Jevons),其著名的杰文斯悖论指出:提高资源使用效率往往会导致该资源消耗量的增加,而非减少。
TypeSafe AI 赌的是:当 AI 决策的成本趋近于零且速度极快时,令牌(Token)的市场需求将爆炸式增长。 即使单个决策极其便宜,但由于其可嵌入到每一个软件循环、每一次点击判断中,总消耗量将远超传统聊天机器人。
然而,这一假设也面临挑战:
- 市场接受度:并非所有场景都需要如此极致的速度和低成本,许多现有 LLM 已能满足需求。
- “无幻觉”的定义:虽然 Jev 不会生成乱码,但如果它对关键业务做出了错误的概率判断(如将高风险交易误判为安全),其后果依然严重。
- 伦理边界:正如文章末尾所言,如果 Jev 能高效玩《毁灭战士》,未来是否会被用于无人机目标识别等军事决策?这将引发新的伦理和安全讨论。
© 版权声明
文章版权归作者所有,未经允许请勿转载。