随着企业级 AI 智能体(Agent)处理的业务逻辑日益复杂,开发者面临着一个严峻的挑战:如何让智能体在拥有数百甚至数千个工具库的情况下,准确选择并组合正确的工具来完成任务?传统的做法是将所有工具描述塞入提示词(Prompt),这不仅导致上下文窗口迅速溢出,更带来了高昂的 Token 成本。
- 论文地址:https://arxiv.org/pdf/2606.18051
阿里云研究人员最新推出的 SkillWeaver 框架,通过引入“技能感知分解”(Skill-Aware Decomposition, SAD)和迭代反馈机制,成功解决了这一痛点。实验数据显示,该方法在保持高准确率的同时,将 Token 消耗减少了 99% 以上,为大规模智能体部署提供了极具性价比的解决方案。
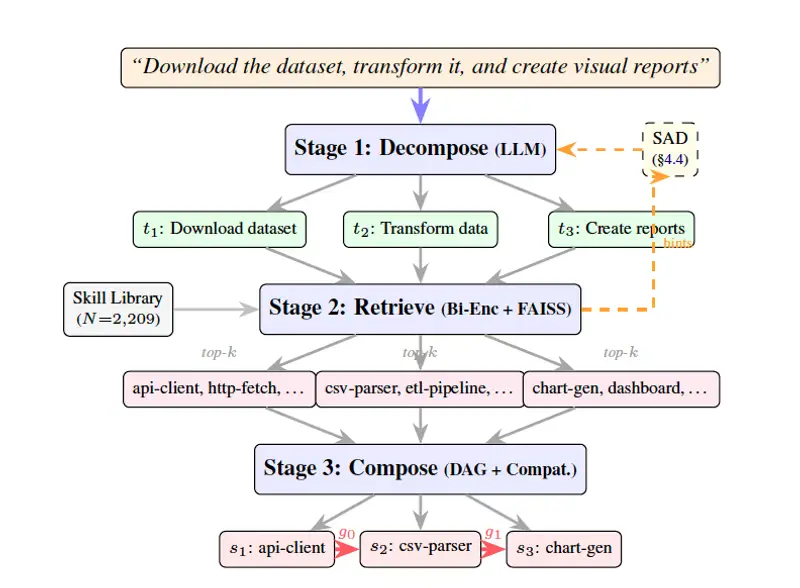
核心痛点:工具选择的“组合爆炸”
在现代 LLM 智能体架构中,“技能”(Skill)被定义为模块化的、可重用的工具规范。然而,现实世界的业务请求往往是组合式的,无法由单一工具完成。例如,一个“分析销售数据并生成可视化报告”的请求,需要依次调用数据提取、清洗、分析和绘图等多个 API。
传统框架通常采用两种方式处理:
- 暴力填充:将所有工具名称和描述放入 Prompt。这会导致 Token 激增(单次查询可达数十万 Token),且模型容易在海量选项中迷失。
- 单步路由:每一步单独选择工具。这种方式缺乏全局视野,难以规划多步骤的依赖关系,容易导致执行链条断裂。
SkillWeaver 的工作原理:分解、检索与组合
SkillWeaver 将复杂任务的处理流程重构为三个精密协作的阶段:
- 任务分解(Decomposition):
LLM 充当分解器,将用户的复杂查询拆解为一系列原子性子任务。 - 技能检索(Retrieval):
利用嵌入模型(Embedding Model),将每个子任务与庞大的技能库进行语义匹配,拉取顶级候选工具列表。 - 计划组合(Composition):
规划器评估候选工具间的兼容性,确保前一个工具的输出能自然流入下一个工具的输入,最终生成一个包含依赖关系的可执行有向无环图(DAG)。
关键创新:技能感知分解(SAD)
SkillWeaver 最大的突破在于引入了 Iterative Skill-Aware Decomposition (SAD) 反馈循环。
LLM 在初步分解任务时,往往使用通用的自然语言描述,这与工具库中特定的技术词汇存在鸿沟。SAD 机制通过以下步骤弥合这一差距:
- LLM 起草初始计划。
- 系统进行初步检索,找到松散匹配的技能。
- 将这些检索到的具体技能名称和描述作为上下文反馈给 LLM。
- LLM 根据实际存在的工具重写分解步骤,使粒度和词汇与工具库完美对齐。
这种“先检索后优化”的策略,显著提高了任务分解的准确性。
性能表现:小模型也能打败大模型
在基于 2,209 个真实 MCP 技能构建的 CompSkillBench 基准测试中,SkillWeaver 展现了惊人的效率:
- Token 节省:相比将所有工具放入 Prompt 的基线方法(每查询约 884,000 Token),SkillWeaver 仅需约 1,160 Token,降幅达 99.9%。
- 准确率提升:在使用轻量级 7B 参数模型时,普通分解的准确率仅为 51.0%,而启用 SAD 反馈循环后,准确率跃升至 67.7%。在涉及 4-5 种技能的困难任务上,准确率提升了 50%。
- 模型悖论:研究发现,在没有 SAD 引导的情况下,更大的 14B 模型反而表现更差,因为它倾向于过度分解任务。SAD 提供的具体工具上下文起到了“锚定”作用,让模型回归务实。
相比之下,传统的 ReAct 基线在多步骤规划上完全失败(0% 分解准确率),因为它无法维持连贯的多工具序列。
开发者指南:如何落地 SkillWeaver?
虽然阿里云尚未发布官方源代码,但其核心逻辑完全基于现有开源技术,开发者可以轻松复现:
- 构建向量索引:使用 FAISS 等工具对技能库进行向量化。测试显示,索引 2,000+ 技能仅需 15 秒,单次检索延迟低于 15 毫秒。
- 实现 SAD 循环:参考论文中的提示模板,编写一个包含“分解-检索-重写”逻辑的 Python 脚本或编排工作流。
- 优化检索排序:虽然双编码器能将相关工具排进前 10 名(约 70% 概率),但为了进一步提升首位命中率,建议引入二级交叉编码器(Cross-Encoder)或基于 LLM 的重排序器。
- 补充错误恢复:SkillWeaver 目前专注于路由和规划。在生产环境中,开发者需在执行层自行构建重试、回退和异常处理机制,以应对 API 超时或格式错误。
© 版权声明
文章版权归作者所有,未经允许请勿转载。