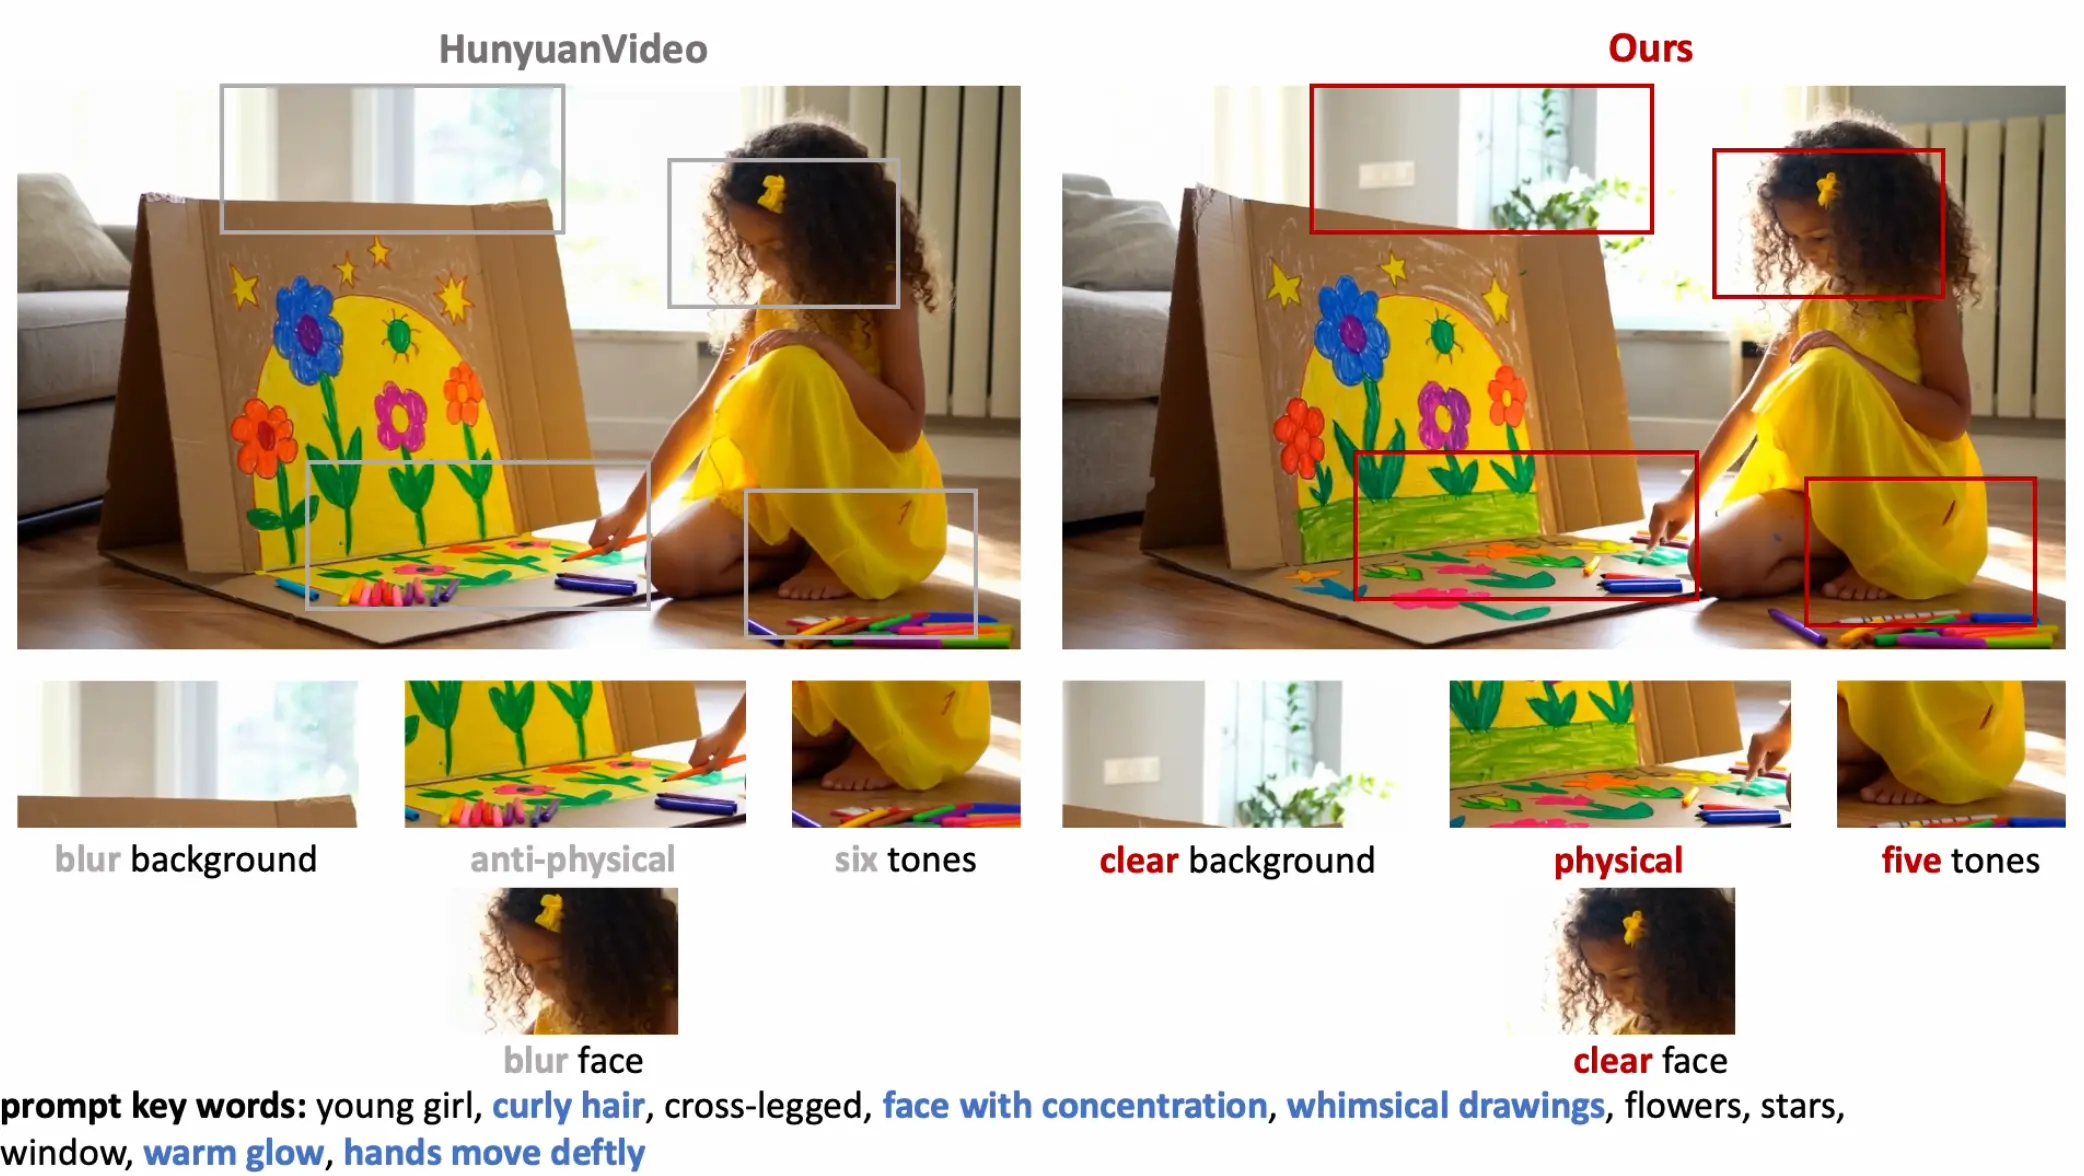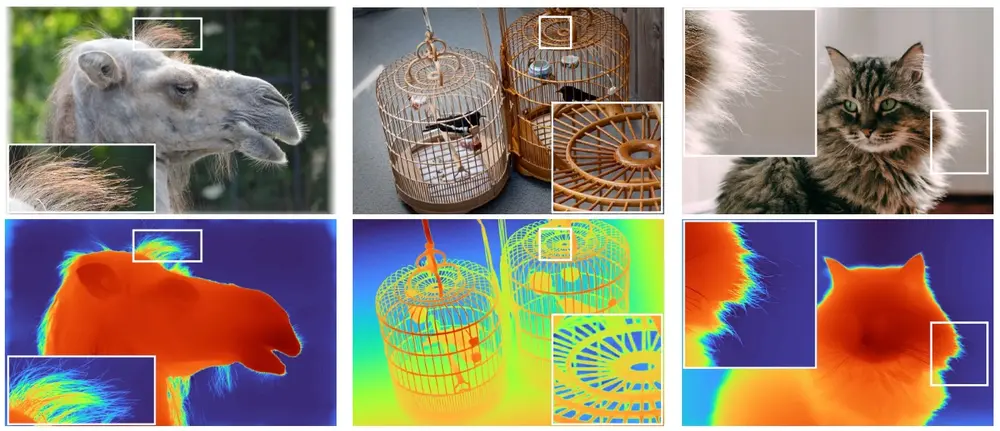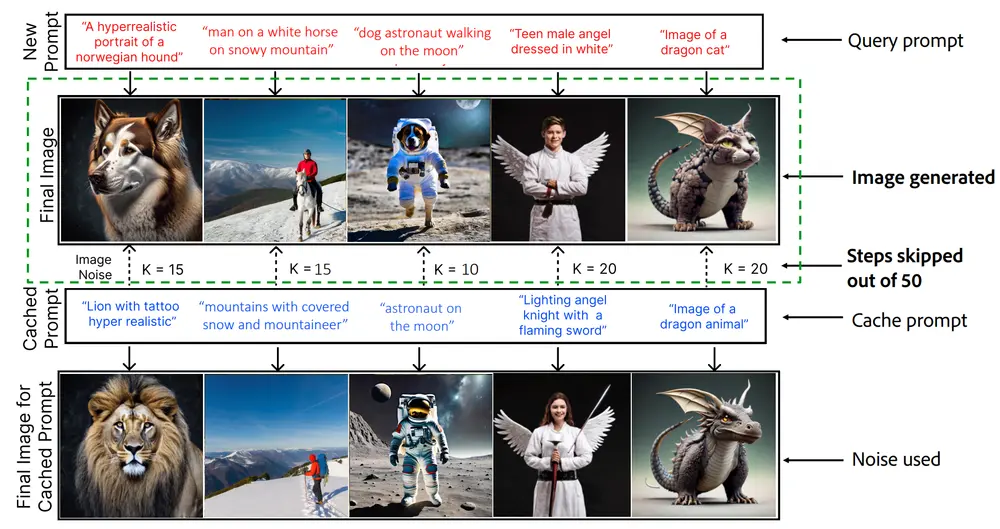
在 AI 绘画领域,用户常面临两大痛点:“听不懂人话”(文生图内容偏差)和“画不出美感”(质感失真、人脸恐怖谷)。阿里云 Qwen 团队推出的 Qwen-Image-2.0-RL,通过在基础模型之上引入强化学习(Reinforcement Learning, RL)与人类反馈(Human Feedback, HF),为 AI 上了一堂深度的“审美课”和“理解课”,显著提升了文生图与图像编辑的精准度与美学质量。
- 论文地址:https://arxiv.org/abs/2606.27608
核心突破:不仅仅是模仿,更是理解
Qwen-Image-2.0-RL 并非从零构建的新模型,而是对 Qwen-Image-2.0 进行的后训练升级。它通过一套复杂的强化学习流程,同时强化了两大核心能力:
- 文生图(Text-to-Image):
- 精准对齐:不再漏掉细节或擅自加戏,严格遵循文字描述。
- 美学跃升:构图更和谐、光影更自然、纹理更真实,彻底摆脱“塑料感”。
- 人像精致化:面部比例协调、皮肤毛发细腻,有效解决“恐怖谷”效应。
- 创意爆发:在抽象与艺术创作中展现出更强的想象力。
- 图像编辑(Image Editing):
- 指令精准执行:说“换背景”绝不改衣服,指哪打哪。
- 身份保持:编辑后的人物依然是原来那个人,拒绝“换脸”。
- 无缝融合:修改部分与原图自然衔接,无违和感。
亮点:这两个能力被整合在同一个模型中,无需切换工具,既能从无到有地创作,也能在已有基础上精修。
技术揭秘:如何教会 AI “审美”?
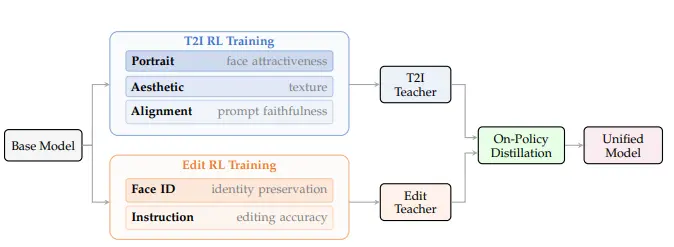
研究团队设计了一套精密的训练架构,解决了传统 RL 在绘画领域的多个难题:
1. 多层次复合奖励系统(Multi-Teacher Reward System)
就像由多位专家联合评分,针对不同维度设立专门的“评分老师”:
- 文生图老师:分别负责“图文对齐度”、“整体美学”和“人脸质量”。
- 图像编辑老师:分别负责“指令遵循度”和“身份保持度”。
- 链式思考:这些老师基于 Qwen VLM 微调,具备先分析再打分的能力,确保评分可靠。
2. 逐点评分 vs 两两对比
实验证明,**逐点评分(Absolute Scoring)**优于两两对比。让模型知道一张图“绝对有多好”(1-5分),比只知道“A 比 B 好”能提供更丰富的学习信号,从而生成视觉质量更高、瑕疵更少的图片。
3. 混合 CFG 策略(Hybrid CFG Strategy)
为解决强化学习中 CFG(分类器无关引导)导致的训练不稳定问题:
- 生成时开 CFG:确保候选图片质量足够高,让奖励打分准确。
- 训练时关 CFG:避免梯度更新时的震荡,保护模型预训练学到的世界知识。
4. 在线策略蒸馏(Online Policy Distillation, OPD)
这是合并多任务能力的“神来之笔”:
- 先分别训练专攻文生图和图像编辑的“专科老师”。
- 再通过 OPD 让一个“学生模型”在生成过程中实时对比老师的建议,逐步融会贯通。
- 优势:避免了直接混合训练导致的目标冲突(如创造力与保守性的打架),实现了能力的完美统一。
5. 智能提示词筛选与分类权重
- 筛选机制:只挑选那些“有的画得好、有的画得差”的提示词进行训练,避免在太简单或太难的任务上浪费算力。
- 分类权重:对人像、风景、3D 等不同类别设置不同的奖励权重,确保模型在特定领域不掉链子。
性能表现:全面超越基线
在权威基准测试中,Qwen-Image-2.0-RL 展现了显著的提升:
| 评测维度 | 基础模型 (Qwen-Image-2.0) | 强化学习版 (Qwen-Image-2.0-RL) | 提升幅度 |
|---|---|---|---|
| Qwen-Image-Bench 总分 | 55.23 | 57.84 | +2.61 |
| 创意生成 | 58.22 | 64.94 | +6.72 🚀 |
| 真实世界保真度 | 47.54 | 51.83 | +4.29 |
| 文生图 Elo 评分 | 1115 | 1193 | +78 |
| 图像编辑 Elo 评分 | 1256 | 1349 | +93 🚀 |
- 对比竞品:超越了 FLUX 2 Pro、Seedream 4.0/4.5 等强劲对手,仅次于 GPT Image 2 等顶级商业模型。
- 定性观察:人像皮肤更真实、风景层次更丰富、编辑指令执行更严格,无明显偏科。
行业价值:一套可复用的“后训练方法论”
Qwen-Image-2.0-RL 的贡献不仅在于模型本身,更在于其提出的一套通用方法论:
- 复合奖励设计:证明了多维度评判对复杂生成任务的重要性。
- 逐点评分实证:为奖励模型训练提供了新的最佳实践。
- 混合 CFG 方案:解决了扩散模型 RL 训练的工程痛点。
- 在线策略蒸馏:展示了优雅的多任务能力合并路径。
© 版权声明
文章版权归作者所有,未经允许请勿转载。