在大语言模型(LLM)的应用中,如何让冻结的模型持续获取新知识而不进行昂贵的重新训练,一直是企业 AI 面临的难题。MeMo 是一个由多所大学研究人员开发的创新框架,它引入了一种模块化的“记忆模型”架构,将知识存储与推理引擎解耦,不仅避免了传统 RAG 的上下文限制和微调导致的灾难性遗忘,更实现了零重训升级与显著的性能提升。
- 论文:https://arxiv.org/abs/2605.15156
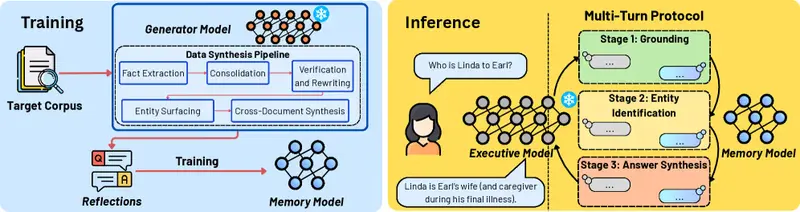
核心突破:模块化记忆架构
MeMo 将系统分为两个独立组件:
- 🧠 记忆模型(Memory Model):一个小型、专用的语言模型,负责将新知识编码到其参数中。
- ⚙️ 执行模型(Executor Model):一个冻结的、现成的 LLM(如 Qwen、Gemini),作为推理引擎。
工作原理:三阶段交互协议
- 分解(Decomposition):执行模型将复杂查询拆解为原子子问题,向记忆模型发起针对性查询以获取基本事实。
- 缩小(Narrowing):基于初始线索,执行模型发出后续查询,逐步收敛到特定目标实体。
- 综合(Synthesis):执行模型向记忆模型请求支持事实,并将碎片化信息综合为连贯答案。
关键技术:反射式学习与模型合并
1. 🔄 反射式知识编码
- 结构化提炼:MeMo 不使用原始非结构化文档,而是利用生成模型将语料库提炼为数千个针对性的问答对(Reflections)。
- 参数化记忆:记忆模型在这些 QA 对上微调,使其能仅凭参数知识回答问题,无需实时检索上下文,从而大幅提升推理效率。
2. 🔗 高效持续更新
- 模型合并(Model Merging):当有新知识加入时,MeMo 仅在新数据上训练一个新的独立记忆模型,提取“任务向量”,并通过数学方式合并到原记忆模型权重中。
- 避免灾难性遗忘:这种方法隔离了更新过程,保护了原有知识,虽然准确率相比完全重训略有下降(11%-19%),但计算成本极低且无需停机。
性能表现:超越传统 RAG
实验表明,MeMo 在复杂推理任务上表现卓越:
| 基准测试 | MeMo + Gemini 3 Flash | HippoRAG2 (SOTA Graph RAG) | 提升幅度 |
|---|---|---|---|
| NarrativeQA (长文档推理) | 53.58% | 23.21% | +130% 🚀 |
| MuSiQue (多跳推理) | 显著提升 | – | +11.90% (相比旧基线) |
- 零重训升级红利:仅将执行模型从 Qwen 切换为 Gemini 3 Flash,MeMo 在 NarrativeQA 上的性能即提升 26.73%。
- 抗噪声能力:在充斥无关文档的噪声环境中,MeMo 性能下降不到 2%,而 HippoRAG2 下降高达 11.55%。
MeMo vs. 传统 RAG:如何选择?
| 特性 | 传统 RAG | MeMo |
|---|---|---|
| 核心机制 | 查找(Lookup) | 综合(Synthesis) |
| 适用场景 | 答案位于单文档、需精确来源引用 | 跨多文档综合、复杂多跳推理 |
| 数据波动性 | 高频变化、需实时性 | 相对稳定、通用领域知识 |
| 来源归因 | ✅ 清晰可追溯 | ❌ 模糊(参数化记忆) |
| 前期成本 | 低(快速索引) | 高(需训练记忆模型) |
💡 建议策略:采用混合路由架构,将简单“查找”请求发给向量数据库,将复杂“综合”请求发给 MeMo。
局限性与展望
- 前期训练成本:需为每个新语料库训练记忆模型,数据生成管道计算昂贵。
- 容量限制:记忆模型的大小限制了其内化知识的总量。
- 合规挑战:参数化记忆导致来源归因困难,可能不适用于需要严格审计跟踪的场景。
尽管存在局限,MeMo 代表了一种范式转变。正如 MIT CSAIL 主任 Daniela Rus 所言:“记忆模型有望像缓存和索引一样,成为未来数据系统的标准组件。”
© 版权声明
文章版权归作者所有,未经允许请勿转载。