当我们将一张模糊低清的图片通过 AI 放大时,往往面临两难选择:要么画面平滑但丢失细节,要么细节丰富却充满“AI 味”的虚假纹理(如塑料感皮肤、歪曲文字)。针对这一行业痛点,中科院自动化所与快手科技联合提出了全新的图像超分辨率框架 —— ASASR。
- GitHub:https://github.com/wafer-bob/ASASR
ASASR 旨在解决生成式模型在超分辨率任务中的“频谱失配”问题,通过引入彩色噪声流与对抗式 Sobolev 对齐,实现了既符合自然统计规律、又保持语义结构真实的图像重建。
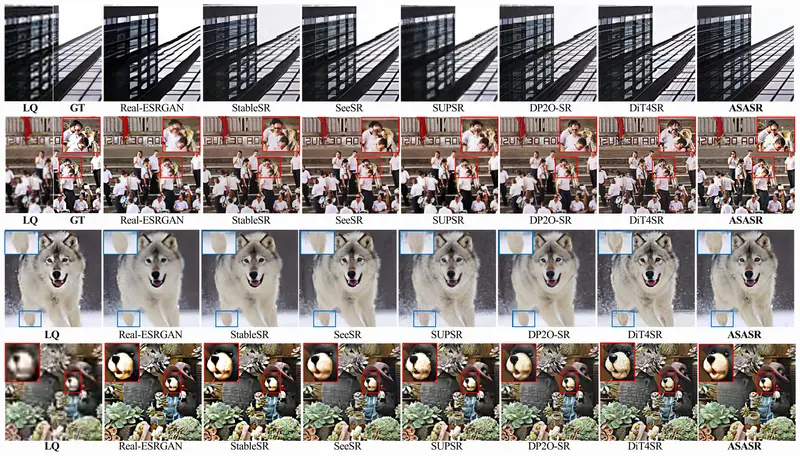
核心痛点:为什么现有 AI 放大会“造假”?
传统生成式超分辨率模型(如基于 Stable Diffusion 的方法)通常使用各向同性高斯噪声(白噪声)。这种噪声假设图像中所有频率的能量相同,但自然图像并非如此——高频细节(纹理、边缘)的能量远低于低频部分。
这种频谱失配导致 AI 在高频区域产生偏差:
- 过度平滑:丢失真实纹理。
- 过度生成:编造不存在的细节(如将模糊树叶变成奇怪花纹,或改变人脸特征)。
ASASR 的核心创新:给噪声“上色”与训练“找茬员”
ASASR 通过两大机制重构了生成过程:
1. 彩色噪声流:频谱校正
- 原理:摒弃白噪声,采用与自然图像频谱特性一致的**“彩色噪声”**。
- 作用:在优化过程中,高频差异受到更严格的惩罚。相当于给 AI 戴上“高频敏感眼镜”,使其对细节错误更加警觉,从而抑制虚假纹理的生成。
- 数学基础:基于 Sobolev 诱导几何,将优化空间从欧几里得空间重塑为更贴合自然图像统计规律的黎曼度量空间。
2. 对抗式 Sobolev 对齐:专业“找茬员”
- 原理:训练一个专门的对抗网络,生成**“看似不错但结构有细微缺陷”**的负样本(如轻微变形的文字、错位的建筑边缘)。
- 作用:主模型必须学会识别这些高级错误,从而提升对真实结构的敏感度。
- 优势:相比随机噪声,这种结构化负样本能更有效地暴露模型盲区,提升语义保真度。
主要优势:既真实又好看
| 特性 | 传统生成式 SR | ASASR |
|---|---|---|
| 噪声模型 | 白噪声(各向同性) | 彩色噪声(频谱对齐) |
| 细节真实性 | ⚠️ 易产生幻觉/虚假纹理 | ✅ 忠实还原真实信号 |
| 频谱一致性 | ❌ 高频分布异常 | ✅ 与自然图像高度吻合 |
| 语义保真度 | ⚠️ 像素准但结构可能歪曲 | ✅ 结构正确,利于下游任务 |
| 感知质量 | ✅ 看起来清晰 | ✅ 清晰且自然无塑料感 |
实验结果:全面领先
研究团队在多个维度验证了 ASASR 的卓越性能:
- 📊 指标登顶:在合成数据集上,ASASR 在感知质量(LPIPS, DISTS)和结构保真(SSIM)上均达到 SOTA。
- 👁️ 用户盲评:在 50 人参与的盲测中,ASASR 获得了 91.1% 的第一名选票,直观感受优势明显。
- 📈 下游任务提升:由于还原的是“真实”而非“虚构”细节,ASASR 处理后的图片在后续 AI 任务中表现更佳:
- OCR 文字识别召回率:提升至 45.91%
- 目标检测 mAP:提升至 35.62%
- 实例分割 mAP:提升至 30.98%
- 🌍 泛化能力:在真实世界退化场景(手机拍摄、老电影修复)及不同骨干网络(SD1.5, SDXL, FLUX)上均表现稳定。
© 版权声明
文章版权归作者所有,未经允许请勿转载。