面壁智能正式发布了 MiniCPM5-1B,这是 MiniCPM5 系列的首个成员,也是目前 1B 参数量级开源模型中的状态最佳(SOTA)。专为设备端、本地部署及资源受限场景设计,它在保持极小体积的同时,实现了在智能体工具调用、代码生成和复杂推理任务上的卓越表现。
- GitHub:https://github.com/OpenBMB/MiniCPM
- 模型:https://modelscope.cn/collections/OpenBMB/MiniCPM5
- Demo:https://huggingface.co/spaces/openbmb/MiniCPM5-1B-Demo
核心亮点:小身材,大智慧
1. 1B 级别开源 SOTA
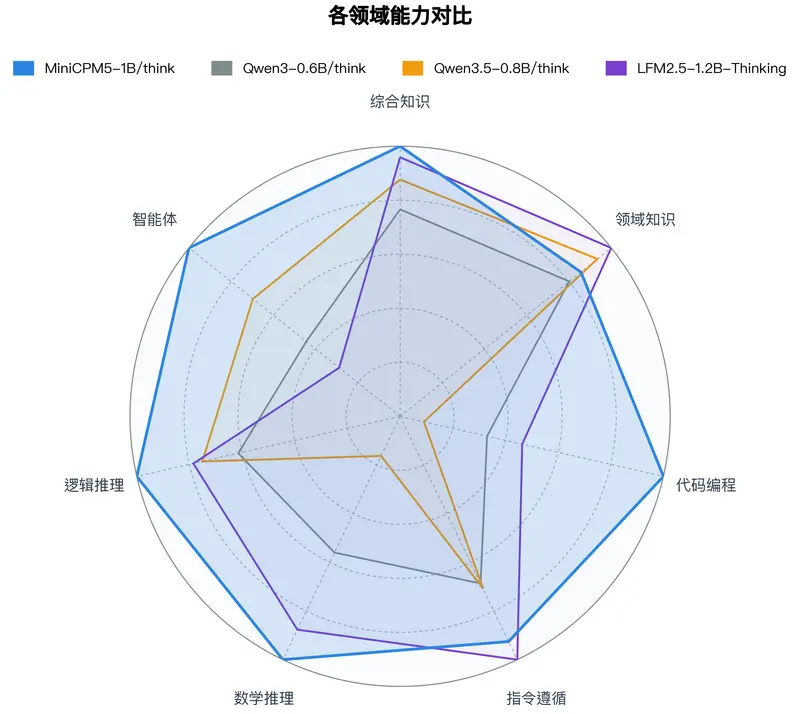
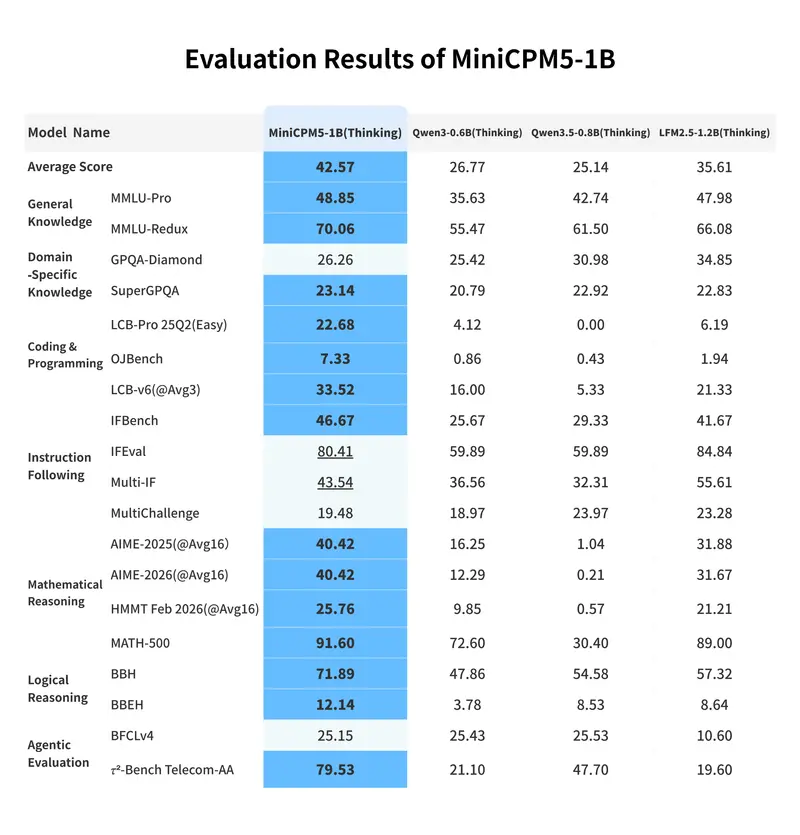
在与 LFM2.5-1.2B-Thinking、Qwen3-0.6B/think 等强劲基线模型的对比中,MiniCPM5-1B 在多项基准测试中胜出,尤其在以下领域优势显著:
- 智能体工具调用:更精准地识别和执行外部工具。
- 代码生成:提供更高质量、更符合规范的代码片段。
- 复杂推理:在数学、逻辑推导任务中表现优异。
2. 原生混合推理:“思考”与“不思考”自由切换
- 双模式聊天模板:内置
<think>标签,通过enable_thinking开关即可切换。 - 灵活应用:
- 快速助手模式:无需深度推理,响应速度快,适合日常对话。
- 深思熟虑模式:激活思维链,逐步拆解复杂问题,适合数学、代码及逻辑难题。
- 单检查点支持:无需加载不同模型,同一权重文件即可胜任两种角色。
3. 128K 超长上下文
- 支持高达 131,072 tokens 的上下文长度,能够处理长篇文档、复杂代码库或多轮深度对话,且保持极高的信息检索准确性。
4. 极简部署与微调
- 多格式支持:提供 BF16、GGUF(适配 llama.cpp/Ollama/LM Studio)、MLX(适配 Apple Silicon)等多种格式。
- 一站式指南:GitHub 仓库提供针对主流推理后端和微调框架的单页速查指南(cookbooks)及智能体技能(Agent Skills),降低上手门槛。
技术揭秘:UltraData 全栈训练与 RL + OPD
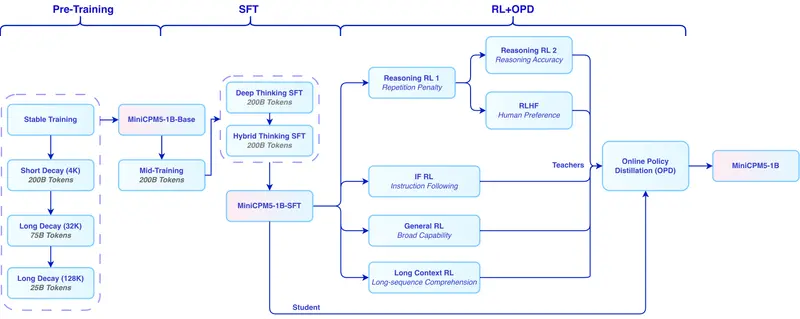
MiniCPM5-1B 的强大性能得益于面壁智能 UltraData 分层数据管理 的全栈实践,涵盖基础训练、中期训练和后训练三个阶段。
1. 基础与中期训练
- 数据基石:使用 Ultra-FineWeb、Ultra-FineWeb-L3 和 UltraData-Math 等高质量语料。
- 能力强化:通过稳定训练和衰减训练建立核心语言能力,并在中期阶段进一步强化目标领域分布。
2. 后训练突破:RL + OPD
这是 MiniCPM5-1B 性能跃升的关键:
- 深度思维 SFT:使用 200B tokens 的深度思维数据和 200B tokens 的混合思维数据进行监督微调,建立强大的思维链能力。
- RL(强化学习):
- 多领域信号:结合数学(DAPO-Math-17k)、代码、闭卷问答、写作及长上下文理解的互补训练信号。
- 长度调度策略:在提升推理准确性的同时,有效减少过长回答的比例。
- OPD(On-Policy Distillation,在线策略蒸馏):
- 反向 KL 散度优势估计:替代传统验证优势计算,在准确性和效率间取得平衡。
- 无需额外数据整理:直接复用 RL 教师模型的领域内提示作为蒸馏数据。
- 显著成效:RL + OPD 使数学、代码和指令遵循任务的平均得分提升 ↑16 分,同时将达到最大 token 限制的回答比例降低 ↓29 个百分点。
模型家族与下载
| 模型名称 | 格式/类型 | 适用场景 |
|---|---|---|
| MiniCPM5-1B | BF16 (RL + OPD) | 推荐:最终发布版,性能最强 |
| MiniCPM5-1B-SFT | BF16 (仅 SFT) | 研究对比,RL/OPD前版本 |
| MiniCPM5-1B-Base | BF16 (基础预训练) | 继续预训练或特定领域微调 |
| MiniCPM5-1B-GGUF | GGUF | llama.cpp / Ollama / LM Studio |
| MiniCPM5-1B-MLX | MLX / 4bit | Apple Silicon (Mac/iPad/iPhone) |
所有模型均可在 ModelScope 下载。
趣味应用:本地 AI 桌面宠物
面壁智能还展示了一个由 MiniCPM5-1B 驱动的本地大语言模型桌面宠物。它完全在本地运行,无需联网,保护隐私的同时提供陪伴感,展示了小模型在端侧交互领域的巨大潜力。
MiniCPM5-1B 的发布标志着端侧小模型能力的又一里程碑。通过创新的 RL + OPD 后训练方案,它在极小的参数量下实现了媲美更大模型的推理和代码能力,并原生支持“思考”模式和超长上下文。
© 版权声明
文章版权归作者所有,未经允许请勿转载。