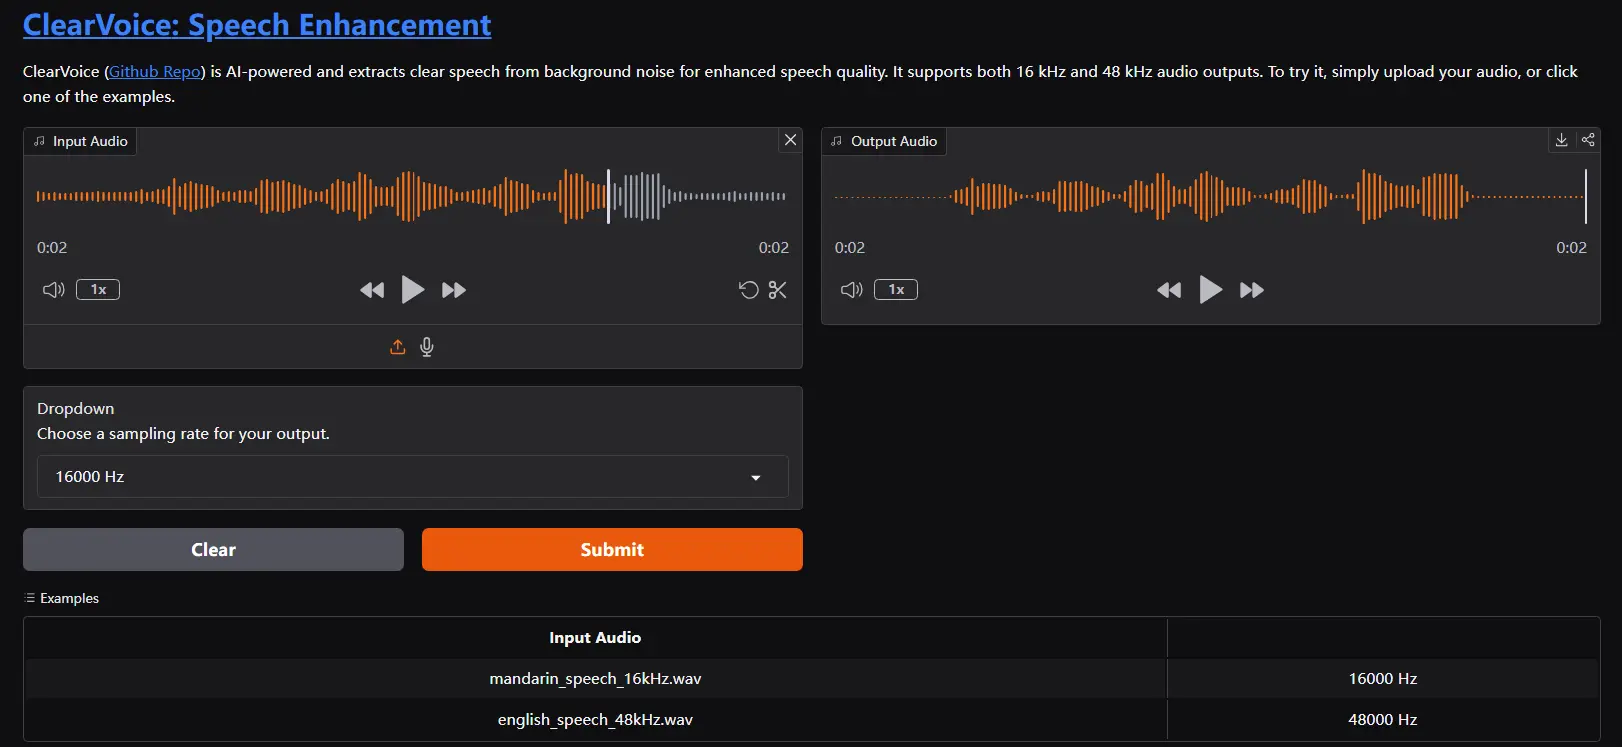
阿里巴巴语音实验室发布开源语音处理框架 ClearerVoice-Studio:支持语音增强、分离和目标说话人提取在当今的音频环境中,清晰沟通面临诸多挑战。背景噪音、重叠对话以及音频和视频信号的混合等因素常常破坏了沟通的清晰度和理解力。这些问题不仅影响个人通话,还波及专业会议和内容制作等场景。尽管音频技术有所进步...语音模型# ClearerVoice-Studio# 阿里巴巴2年前5080
阿里巴巴Wanx 团队推出新型多模态生成模型ACE:可以根据文本指令来执行复杂的图像编辑和生成任务阿里巴巴Wanx 团队推出新型多模态生成模型ACE,这个模型的核心功能是处理和生成图像,但它与传统的图像处理工具不同,因为它可以根据文本指令来执行复杂的图像编辑和生成任务。例如,你是一名摄影师,你拍摄...新技术# ACE# 阿里巴巴2年前8230
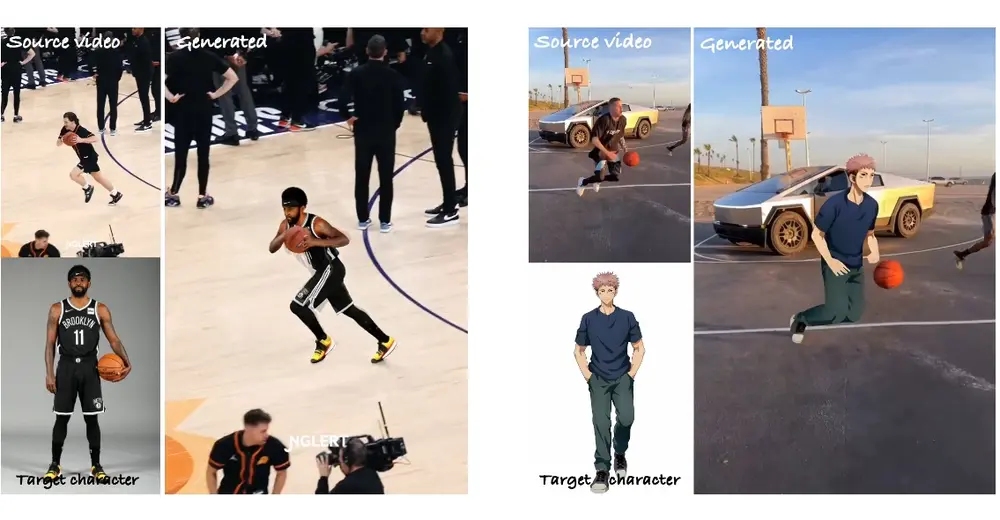
阿里推出角色视频合成框架MIMO:允许用户对视频中的人物进行替换阿里巴巴智能计算研究院推出MIMO,它能够根据用户提供的简单输入,合成具有可控属性(如角色、动作和场景)的逼真角色视频。简单来说,这项技术能够让用户通过提供一些基本的指令或样本,来创造出一段新的视频...新技术# MIMO# 角色视频合成# 阿里巴巴2年前6940
阿里推出新型大型多模态模型ConvLLaVA:专门设计用于处理高分辨率的视觉数据清华大学和阿里巴巴的研究人员推出新型大型多模态模型ConvLLaVA,它专门设计用于处理高分辨率的视觉数据。多模态模型能够理解和处理多种类型的数据,比如文本、图像和视频,这使得它们在各种应用场景中都非...新技术# ConvLLaVA# 多模态模型# 阿里巴巴2年前9060
通义千问视觉理解模型 Qwen-VL升级版:Qwen-VL-Plus、Qwen-VL-Max阿里云宣布通义千问视觉理解模型 Qwen-VL 再次升级,继 Plus 版本之后推出 Max 版本,升级版模型拥有更强的视觉推理能力和中文理解能力,能够根据图片识人、答题、创作、写代码,并在多个权威测...新技术# Qwen-VL-Max# Qwen-VL-Plus# 视觉理解模型3年前1,3090