Voice Showdown
Scale AI 推出了 Voice Showdown,据称这是首个基于真实人类交互视角、通过人类偏好来评估语音 AI 的竞技场。
 Open Agent Leaderboard
在 AI 代理(Agent)日益成为生产力核心的今天,我们往往陷入一个误区:认为模型的能力决定了代理的上限。然而,IBM 最新发布的 Open Agent Leaderboard(开放代理排行榜) 揭示了一个被忽视的事实:代理的效果取决于它的构建方式,而不仅仅是内部的模型。
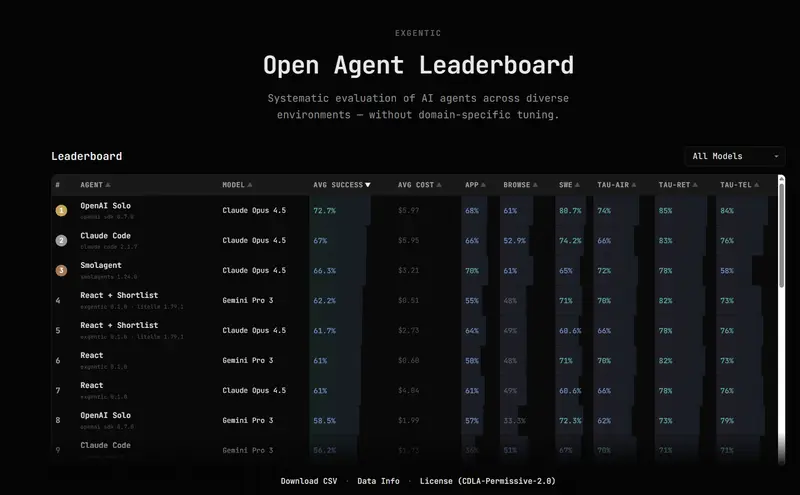
为了更真实地反映代理在实际部署中的表现,IBM 推出了这一开放基准,不仅评估质量,还严格考量成本,旨在回答一个核心问题:你的代理实际上有多通用?它是否值得部署?
传统的 AI 评估报告通常只关注模型在特定基准测试上的得分。但在实际应用中,一个代理是一个复杂的系统,包含:
改变其中任何一项,即使使用相同的底层模型,代理的表现和成本也可能天差地别。Open Agent Leaderboard 正是为了衡量这种完整系统的性能而生。
为了测试代理的通用性(即在陌生环境中无需手动定制即可工作的能力),IBM 组装了六个涵盖不同现实场景的基准测试,并通过统一的协议将它们标准化:
这种组合测试确保了评估的全面性:一个能在编码中表现优异的代理,未必能在遵循严格客服政策的环境中胜出。
通过分析排行榜数据,IBM团队得出了几个令人惊讶且重要的结论:
排行榜前三名往往使用相同的底层大模型,但得分和成本却截然不同。这证明了代理系统的设计(如提示词策略、工具调用逻辑)对最终结果有决定性影响。
最经济的配置价格仅为最强配置的一小部分。更重要的是,失败的成本高昂实验显示,失败运行的成本比成功运行高出 20% 到 54%。这意味着,一个容易陷入死循环或无效尝试的代理,其账单可能远超预期。
未经过特定基准微调的通用代理,在许多任务中已经能够匹配甚至优于专门针对该任务构建的系统。这表明单一代理处理多种工作的时代正在到来。
简单的工具筛选机制(帮助代理聚焦于相关工具)显著提升了所有模型的性能,甚至将一些原本失败的配置变成了可行方案。这说明,优秀的代理设计可以弥补模型能力的不足。
为了确保透明度和可复现性,IBM 同步发布了 Exgentic 框架。这是一个用于运行和复现评估的开源工具,允许开发者:
一切从一开始就是开放的,旨在建立一个社区驱动的评估标准。
目前,排行榜已涵盖五个代理框架和六个基准测试。数据显示,虽然开源权重模型在特定组合上具有竞争力,但在平均表现上仍落后于前沿闭源模型 18 到 29 个百分点。
IBM 呼吁社区共同参与: