JevBench
JevBench 是由 Benchmark Heaven 独立维护的 Jev 类 System 1 决策模型基准(非 TypeSafe AI 官方),专门评估模型在给定状态与有界评分标准下返回带类型答案(含概率)的能力。
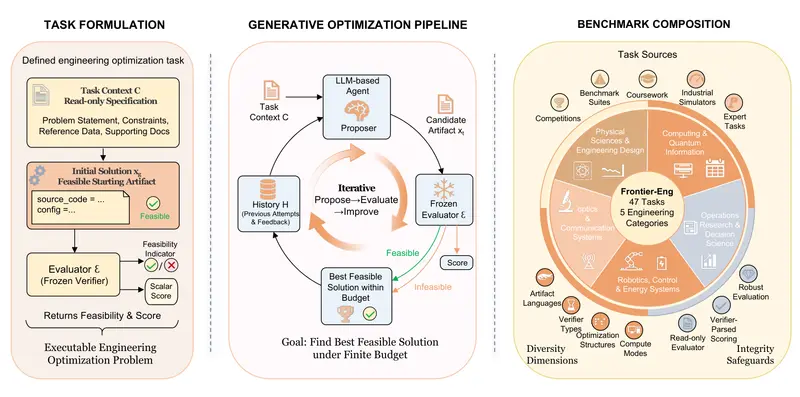
Frontier-Eng 是一个面向 generative optimization 的 benchmark:Agent 不是一次性写出“标准答案”,而是持续修改可运行的工程代码,读取只读 verifier 的反馈,并在固定预算内不断改进。当前版本包含 47 个任务,覆盖计算系统、量子信息、运筹优化、机器人控制、光学通信、物理与工程设计...
 Frontier-Eng
过去两年,大模型在代码生成、数学推理和任务执行上展现了惊人能力。然而,真正的科研与工程高手深知:最艰难的部分并非提出第一个可行方案,而是随后漫长的“长期优化”——在温度、寿命、性能之间寻找平衡,在成百上千次试错中抠出那 1% 的性能提升。
近日,Einsia AI 旗下 Navers Lab 发布了全新基准测试 Frontier-Eng Bench,试图回答一个关键问题:当 AI 进入真实世界的长期反馈循环后,智能的本质究竟是什么?
论文《Frontier-Eng: Benchmarking Self-Evolving Agents on Real-World Engineering Tasks with Generative Optimization》指出,下一代 Agent 的核心竞争力,正从“一次性给出正确答案”转向**“在环境反馈中持续自我修正”**。
现有的评估体系(如代码生成、数学题)大多基于“对/错”二元逻辑,衡量的是模型一次性生成正确答案的能力。但这忽略了真实工程的本质:
Frontier-Eng Bench 将 Agent 置于真实的工程优化环境中,要求其完成以下闭环:
这种能力被定义为**“生成式优化” (Generative Optimization)。它衡量的不再是静态的知识储备,而是动态的长期反馈闭环中的持续优化能力**。
Frontier-Eng 涵盖了五大硬核领域,共 47 个任务,每个任务都要求 Agent 进行多轮迭代:
| 领域 | 典型任务示例 | 优化目标 |
|---|---|---|
| 量子计算 | 量子线路优化 | 最大化保真度,最小化噪声影响 |
| 运筹与决策 | 复杂调度算法 | 最小化成本,最大化资源利用率 |
| 机器人控制 | 运动轨迹规划 | 平滑性、能耗、避障能力平衡 |
| 光学与通信 | 光子芯片设计 | 信号传输效率、损耗最小化 |
| 物理工程 | 电池快充策略 | 平衡充电速度、温度控制与电池寿命 |
在这些任务中,Agent 不能仅靠“灵光一闪”,必须展现出类似人类专家的韧性——在失败中学习,在反馈中进化。
Frontier-Eng 最引人注目的结论之一,是关于推理算力分配的洞察:
随着优化进入“深水区”,性能提升的难度呈指数级上升。每一个百分点的进步,都需要付出巨大的计算代价。
面对复杂难题,Agent 应该:
实验结论:深度胜出。
Frontier-Eng 的发现预示着 AI 行业护城河的转移: