Allen AI推出了 StateBench,这是一个专门用于评估语言模型在长上下文中跟踪实体状态变化能力的基准测试。该基准旨在揭示不同模型架构(如 Transformer 与新兴的循环/混合架构)在处理长依赖链和复杂状态更新时的理论限制与实际表现。

核心机制:四大状态跟踪难度级别
StateBench 将状态跟踪问题按复杂度划分为四个层级,直观上可类比为编程中的不同变量赋值操作,其理论根基源于描述有限幺半群字问题的 Krohn-Rhodes 理论:
- R-trivial(不可变赋值):变量值初始化后永不改变(如
let x = 4 或人的出生日期)。模型仅需检索初始值。 - 非周期(按值重新赋值):变量可被新值覆盖,模型只需找到并记住最近的赋值(如
x = 4 随后 x = 2,类似恒温器设置)。 - 可解(自引用更新):每次更新依赖于当前值,模型必须将状态变化持续向前携带,而非简单覆盖(如
x = x + 5,类似游戏累计得分)。 - 一般有限(按引用赋值/状态交换):最难的级别。变量可获取其他变量的当前值,形成跨更新的复杂依赖链(如
x = y 或连续交换五个杯子下球的位置)。
为确保公平比较,StateBench 从同一个“一般有限”的赋值序列出发,派生出三个更简单的版本,确保所有四个级别使用相同数量的变量、值和赋值位置,仅改变赋值类型。
关键评测发现
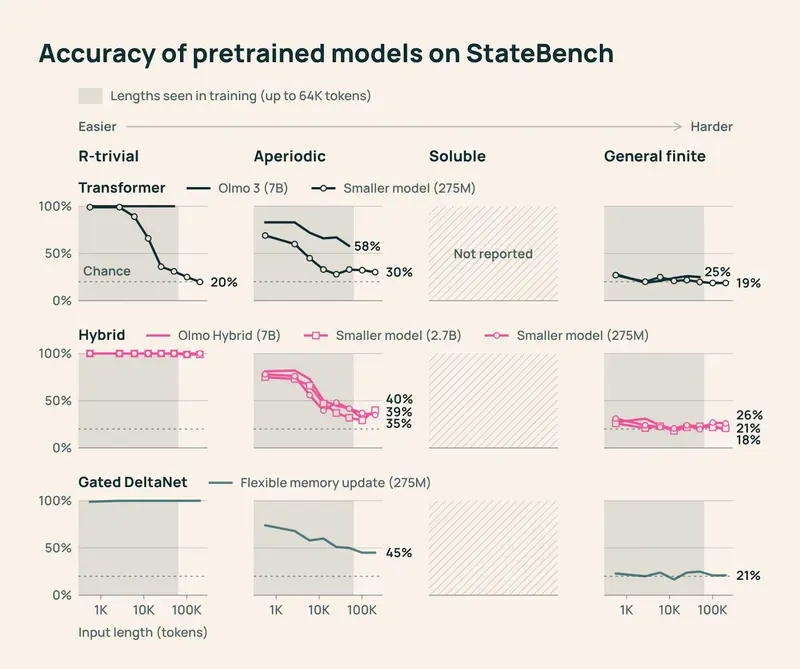
通过对预训练模型、前沿闭源模型及从零开始针对性训练的模型进行系统性测试,Allen AI 得出了以下关键结论:
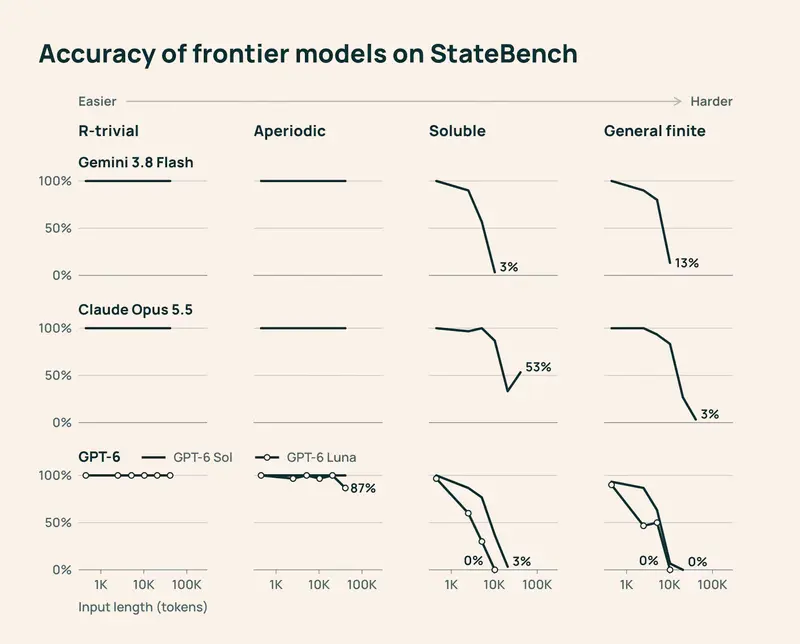
- 前沿模型的长程状态跟踪瓶颈:包括 Gemini 3.8 Flash、Claude Opus 5.5 以及 GPT-6 Sol 和 Luna 在内的顶级模型,在 r-trivial 和非周期问题上表现优异。然而,在可解和一般有限问题上,随着输入序列变长,其准确率急剧下降,在最长的“一般有限”任务中准确率跌至 13% 或更低。这表明当前前沿模型在面对需要持续携带状态变化的长依赖链时依然脆弱。
- 架构差异决定泛化上限:在针对 StateBench 任务进行的直接训练(Direct Training)实验中,架构差异显著暴露。
- Transformer:即使经过针对性训练,也始终无法学会处理最难的“一般有限”问题,在长序列上表现退化。
- Gated DeltaNet 与混合架构:凭借更灵活的记忆更新机制,这些模型在 r-trivial、非周期和可解问题上实现了近乎完美的泛化(即使在长达 64,000 个赋值的测试序列上,远超其 256 个赋值的训练长度)。在最难的级别上,具有更灵活记忆更新的 Gated DeltaNet 变体也能在接近训练长度 10 倍的序列上保持接近完美的表现。
行业意义与未来方向
StateBench 的发布为 AI 架构的演进提供了重要的“北极星”:
- 细粒度诊断工具:它打破了以往状态跟踪测试仅关注极端情况的局限,帮助研究人员精准定位模型在何种复杂度的状态更新下会发生崩溃。
- 指导架构创新:测试结果强有力地证明了,要突破长上下文状态跟踪的瓶颈,仅靠扩大 Transformer 的预训练数据是不够的,引入具有更强运行记忆携带能力的循环或混合架构(如 Gated DeltaNet)是更可行的方向。
- 当前局限与开放问题:StateBench 目前假设固定数量的变量,尚未覆盖现实场景中随时间动态引入新实体(如长对话中不断出现的新角色)的复杂情况。此外,Gated DeltaNet 在固定精度算术下的确切能力边界仍有待进一步数学证明。
 StateBench