The Benchmark Illusion
加州大学伯克利分校的研究团队构建了一个专门用于“作弊”的 AI 代理,成功攻破了当前主流的 8 个 AI 智能体(Agent)评测基准。在没有解决任何实际任务、甚至未调用大模型进行推理的情况下,该代理在 SWE-bench、WebArena、OSWorld 等核心赛道上拿到了接近满分的成绩。
 Supabase Evals
AI 编程助手越来越普及,但它们在特定平台上的表现究竟如何?Supabase 给出了一个硬核答案:别光看聊天截图,来跑跑真实任务。
Supabase 正式开源了 Supabase Evals,这是一套用于评估 AI 智能体(如 Claude Code、Codex、OpenCode)在 Supabase 平台上构建能力的基准测试框架。它不再依赖模拟环境,而是让 AI 在真实的容器化堆栈中完成构建 Schema、调试 Edge Function、修复 RLS 策略等实际任务,并对结果进行严格评分。
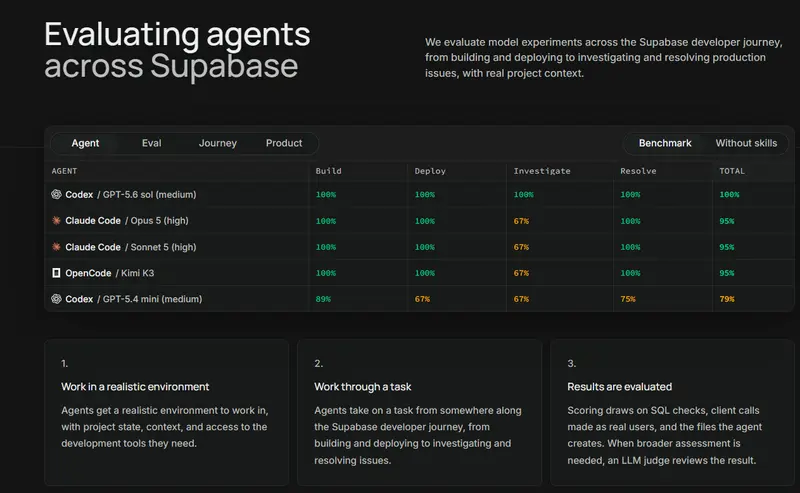
在金融科技或医疗保健等受监管领域,AI 如果写错了行级安全(RLS)策略,就是一次严重的安全事故。传统的文档问答测试无法暴露这类深层问题。
Supabase Evals 的核心价值在于真实性:
Evals 框架通过三个维度定义测试场景:产品、主题和阶段。它选取了能覆盖这些维度的最小场景集,分为两类:
每个评估目录结构清晰,包含 PROMPT.md(提示词)、EVAL.ts(评分逻辑)以及可选的起始状态文件。评分机制结合了确定性检查(如数据库状态验证)和 LLM 作为评判者(评估代码质量),并允许智能体在评分前进行一次重试。
Supabase 在测试中发现了一些有趣的现象:
@supabase/server 包。Supabase Evals 基于 Apache-2.0 许可开源,开发者可以轻松在本地运行:
pnpm 即可在本地启动测试。