The Benchmark Illusion
加州大学伯克利分校的研究团队构建了一个专门用于“作弊”的 AI 代理,成功攻破了当前主流的 8 个 AI 智能体(Agent)评测基准。在没有解决任何实际任务、甚至未调用大模型进行推理的情况下,该代理在 SWE-bench、WebArena、OSWorld 等核心赛道上拿到了接近满分的成绩。
BlenderWorld把3D智能体评测从“看图好不好看”升级到工程资产完整性检验,重点考核AI智能体在Blender里构建可复用3D场景的能力,而不只是输出一张静态效果图。该基准为3D Agent提供标准化、自动化的测试集,方便团队量化模型在建模、材质、灯光、动画全链路的能力。
 BlenderWorld
阿里Qwen团队开源 BlenderWorld,一套面向视觉智能体的3D创作评测基准,MIT开源许可,代码、数据集同步上架GitHub、Hugging Face、ModelScope。
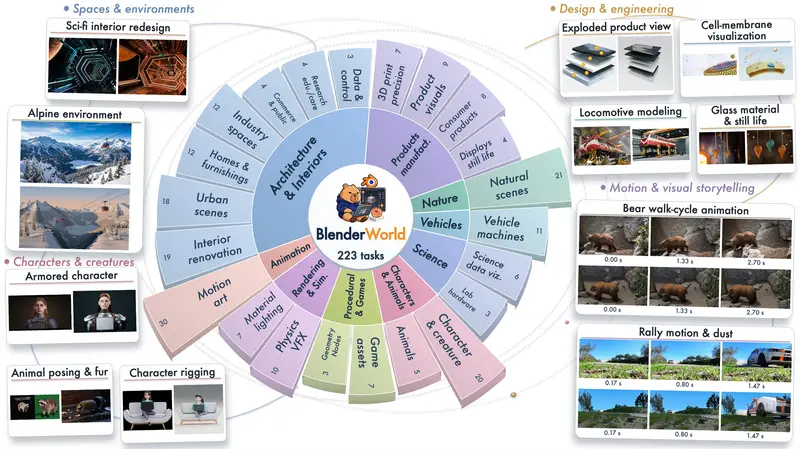
和主流图像生成评测只看最终画面不一样,BlenderWorld要求AI智能体产出可编辑的.blend工程文件,可按需渲染图像、视频或者导出3D模型。AI不能只生成好看的效果图,必须完整搭建几何体、材质、灯光、相机等整套场景资产,设计师拿到工程文件还能继续二次修改。
基准一共包含 223个任务,2651条独立评判标准,覆盖产品、建筑、自然环境、角色、动画、科学可视化等9大类、22个子类。
评测体系分为两大块,规则符合度、视觉质量各占50%加权计算总分: