livenerf
livenerf是一个长期运行、尽可能确定性的基准,用于检测前沿模型在发布后是否悄悄变差。
 AI IQ
在 AI 模型能力飞速迭代的今天,传统的榜单往往陷入“刷分”与“碎片化”的困境。AI IQ (aiiq.org) 是一个由 Stacks 联合创始人 Ryan Shea 创建的初创项目,旨在通过借用人类智商测试隐喻,为全球 50 多个最强语言模型估算“智商”,并将其绘制在标准的钟形曲线上。
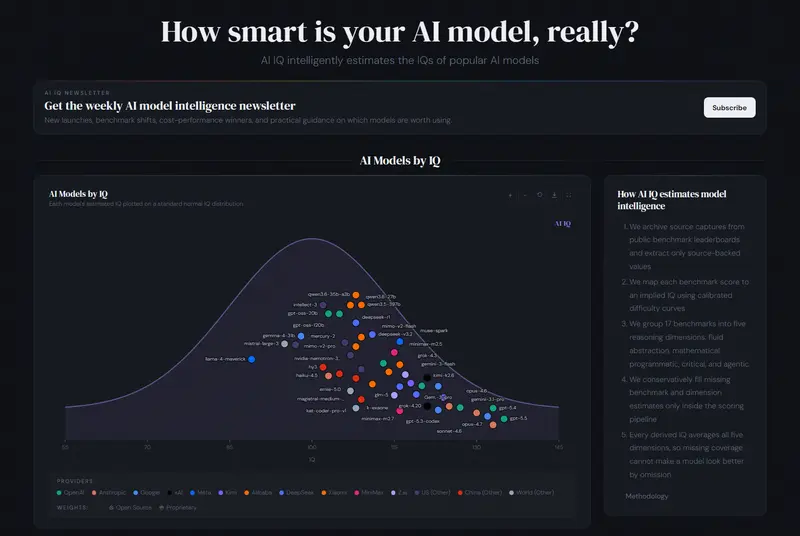
尽管该方法因将复杂能力简化为单一数字而饱受争议,但其提供的跨维度对比、情商 (EQ) 评分及成本效益分析,为企业买家提供了一套前所未有的清晰决策框架。截至 2026 年 5 月,OpenAI 的 GPT-5.5 以接近 136 的估计 IQ 位居榜首,标志着顶级模型集群已进入高度压缩的“超智能”时代。
AI IQ 并非简单平均,而是将能力划分为四个关键推理维度,每个维度包含多项高难度基准:
| 维度 | 包含基准 | 考察能力 |
|---|---|---|
| 抽象推理 | ARC-AGI-1, ARC-AGI-2 | 通用流体智力、模式识别(极难被记忆覆盖) |
| 数学推理 | FrontierMath, AIME, ProofBench | 复杂逻辑推导、形式化证明 |
| 编程推理 | Terminal-Bench 2.0, SWE-Bench Verified, SciCode | 实际代码生成、调试、科学计算脚本 |
| 学术推理 | Humanity’s Last Exam, CritPt, GPQA Diamond | 高阶知识理解、批判性思维、专业领域深度 |
AI IQ 最具价值的图表或许是 IQ vs. 有效成本 散点图:
结论:对于绝大多数企业应用,模型路由 (Model Routing) 已成为必然架构——将昂贵模型用于难题,廉价模型处理常规任务,以实现智能与成本的最佳平衡。
尽管受欢迎,AI IQ 也面临尖锐批评:
| 批评观点 | 详细说明 |
|---|---|
| “参差不齐”能力被掩盖 | 模型在不同领域表现不均(如 GPT-5.5 在 MMLU-Pro 饱和,却在 ClockBench 失败率高),单一 IQ 分数产生“精确性幻觉”。 |
| 方法论透明度不足 | 校准曲线的具体数学转换未完全公开,原始数据未作为开放数据集发布,难以复现验证。 |
| IQ 隐喻的误导性 | 人类 IQ 测试本身存在争议,将其套用于 AI 可能忽略创造力、直觉等非线性能力。门萨测试等替代方案虽片面,但更具可比性。 |
| 天花板效应 | 随着模型越来越强,即使最难基准也将被攻克,现有框架需不断调整上限以维持区分度。 |