AI IQ
AI IQ (aiiq.org) 是一个由 Stacks 联合创始人 Ryan Shea 创建的初创项目,旨在通过借用人类智商测试隐喻,为全球 50 多个最强语言模型估算“智商”,并将其绘制在标准的钟形曲线上。
Liquid AI联合独立验证机构Artificial Analysis正式开源 Pipette,一款面向设备端大模型的可复现基准测试工具。它跳出传统只看模型纸面跑分的思路,将模型、量化方案、推理运行时、硬件设备视作一个完整部署系统进行综合测评,解决模型实验室跑分和手机、电脑等边缘设备实际表现差距巨大的痛点。
 Pipette
Liquid AI联合独立验证机构Artificial Analysis正式开源 Pipette,一款面向设备端大模型的可复现基准测试工具。它跳出传统只看模型纸面跑分的思路,将模型、量化方案、推理运行时、硬件设备视作一个完整部署系统进行综合测评,解决模型实验室跑分和手机、电脑等边缘设备实际表现差距巨大的痛点。
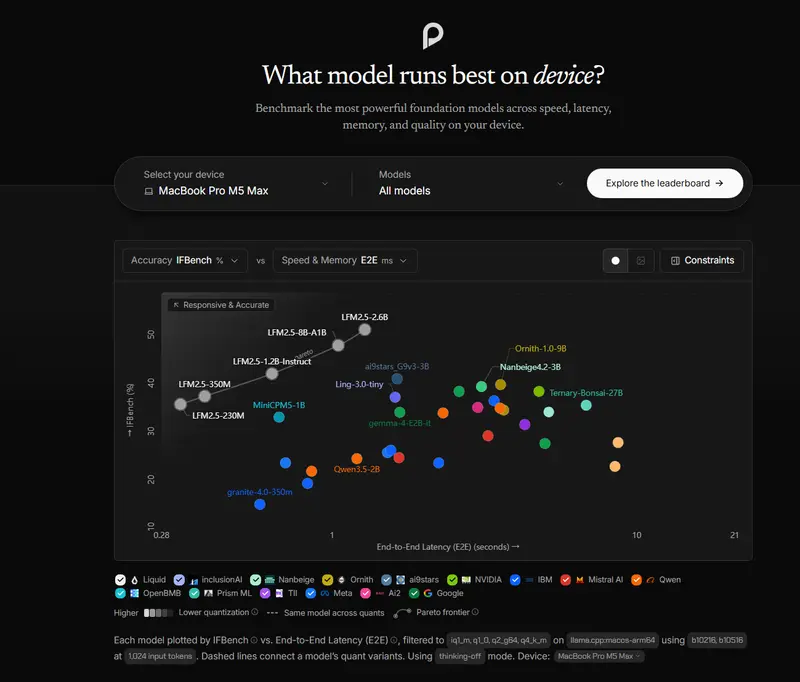
大多数公开的模型卡片给出的性能数据,都是服务器、全精度环境下测出的结果,很难预判同一个模型移植到手机、终端硬件之后的真实延迟、吞吐表现。Pipette正是为了填补这一块实测空白而生。
Pipette整套工具栈采用 Apache 2.0 协议开源,没有申请等待名单,开放资源包括后端管理组件、跨平台客户端、评分库、公开实测数据集、可视化数据看板,还有原生iOS、Android基准测试App。社区提交跑分结果的功能目前处于测试阶段。
初始数据集已经覆盖 1000+种不同配置组合,包含30余款模型、多套量化方案、适配macOS / iOS / Windows / Android的llama.cpp版本,上下文长度区间256‑8192 Token。首批实测硬件:MacBook Pro M5 Max、iPhone 17 Pro、Galaxy S26 Ultra。AMD Ryzen AI Max+ 395、Radeon 8060S等硬件的测试数据将会后续上线。
重要说明:模型质量得分(IFBench、GPQA‑Diamond、MATH‑500)并不在手机等边缘设备上运行,而是在NVIDIA H100‑80GB参考服务器完成评测,之后和对应设备的吞吐、延迟数据做匹配对照。
智能手机硬件厂商、车载智能、工业机器人、医疗设备、金融、政企离线推理项目,所有因为延迟、隐私、网络限制而需要把大模型跑在本地硬件的业务。
上线前对比挑选模型与量化方案;芯片硬件采购验证;系统、驱动、推理引擎更新后的性能回归测试;规划可用上下文窗口大小;独立核验第三方厂商宣传的设备端性能指标。
官方放出四组对照案例,直观证明量化、运行环境、硬件会极大改变最终效果:
Pipette拥有一套标准化、可复现的测评方法论:
固定Token形状、贪婪解码、舍弃预热轮次,每个任务重复测量5次。正式计时前,平台会校验设备温度、负载状态,不合格测试直接丢弃。
模型评分采用盲测机制,打分程序不知道被测模型身份,消除人为偏差。每一条跑分记录完整留存基准版本、模型文件、量化参数、运行时配置、操作系统、硬件信息,保证结果可追溯复现。