DeepSWE
Datacurve 公司最新发布的 DeepSWE 基准测试,不仅重新洗牌了顶级模型的排名,更揭露了当前行业标准 SWE-Bench Pro 中存在的严重验证漏洞与数据污染问题。
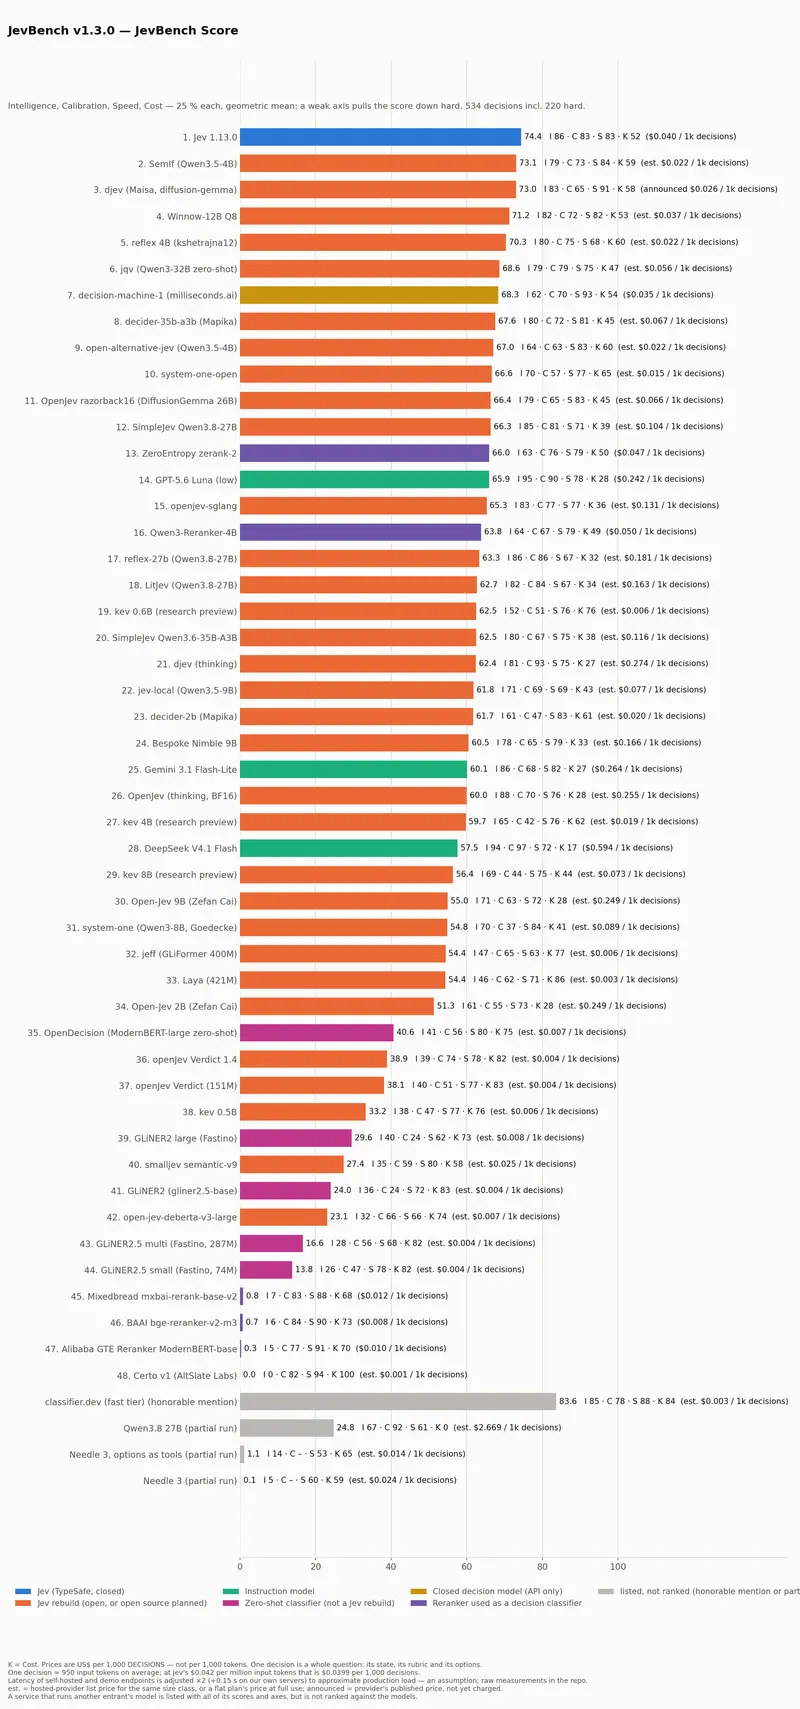
JevBench 是由 Benchmark Heaven 独立维护的 Jev 类 System 1 决策模型基准(非 TypeSafe AI 官方),专门评估模型在给定状态与有界评分标准下返回带类型答案(含概率)的能力。
 JevBench
 是 Benchmark Heaven 推出、专门针对 Jev 这类 System 1 决策模型的基准测试,不属于大语言模型文本生成赛道。
它的任务范式:输入一段状态与限定评分标准,模型输出带类型的选项结果,附带各选项概率,不输出散文、推理解析、AI 套话。该基准独立开发,和 TypeSafe AI 没有隶属、官方背书关系,TypeSafe 的 Jev 模型只是被测对象之一。
| 轴 | 计算方式 | 权重 | 关键调整 |
|---|---|---|---|
| Intelligence | (准确率 – 机会) / (1 – 机会),按层加权(hard 30%, easy 14%, standard 28%, judge 28%) | 25% | v1.4.1 起混合 20% 密封 + 80% 公开;公开-密封差距 >25pp 降分 |
| Calibration | ECE + 对金分布保真度(无标签系统计 0) | 25% | 硬层专属子分数 |
| Speed | score(p50) + score(p95) 平均;score(s)=100−20log₁₀(s/0.1s) | 25% | 自托管/演示端点延迟 ×2 +0.15s 模拟生产负载 |
| Cost | 100−30log₁₀(每千决策$/0.001) | 25% | 单位是每千决策美元,非每千 token;<$0.001=100,每贵10倍−30 |
⚠️ 重要澄清:
- Cost 列数值如
$0.0399表示 1,000 次完整决策的成本(含状态+标准+选项,通常数百至数千 tokens),绝非 token 单价- Speed 的 ×2 延迟调整是假设性修正,非实测生产环境数据
- 密封项目答案键不公开,防止训练泄露;随领域演变需持续更新
| 排名 | 系统 | 分数 | 备注 |
|---|---|---|---|
| 1 | Jev 1.13.0 (TypeSafe AI) | 63.29 | 商业 API,每千决策 $0.0399 |
| 2 | JevK5 v0.2.0 | 62.04 | 开源实现 |
| 3 | Hopper | 59.43 | — |
| 4 | Winnow-12B Q8 | 55.58 | 量化版本 |
| 5 | reflex 4B (kshetrajna12) | 53.99 | 小模型代表 |
📌 未排名但可见:swanOne(密封运行未完成);jqv、Qwen3.8 27B、Needle 3(部分运行)
🏅 荣誉提名:classifier.dev(快速层 83.6)——因其底层为 Jev 1.13.0,避免重复排名
results/ JSON,评分代码开源(jevbench/composite_v13.py)✅ 适用场景:
⚠️ 注意事项: