MCPMark
MCPMark是一个全面的压力测试MCP基准,包含一系列多样化、可验证的任务,旨在评估模型和智能体在现实世界MCP使用中的能力。MCPMark将持续更新新兴的MCP服务器,以跟上充满活力的生态系统步伐!
livenerf是一个长期运行、尽可能确定性的基准,用于检测前沿模型在发布后是否悄悄变差。
 livenerf
 是一套长期、尽可能确定性的追加式基准测试框架,核心目标:监测前沿大模型正式发布之后,能力会不会发生隐性下滑(俗称模型“削弱/nerf”)。
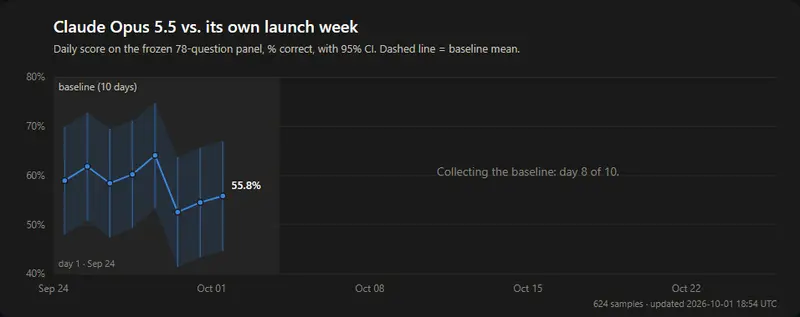
此前一直有传闻,Anthropic会在模型发布后的几天或几周悄悄降低模型能力,可能是量化、替换更小模型、降低推理算力投入、路由策略改动;但也有可能只是用户主观感受+随机噪声。过去缺少发布当日的固定基线,各方争论只能停留在主观感受,livenerf正是为解决这个问题而搭建,本次针对Claude Opus 5.5(2026-09-22发布)启动长期观测。
模型采样本身天然存在随机性,无法做到100%固定输出。livenerf的思路:把其余所有变量全部锁死——冻结提示词、固定Claude CLI版本、固定评分器、永久保存原始日志,依靠上千样本做统计学漂移检验。底层基于英国AI安全研究所开源评估框架Inspect,统计方法直接采用Anthropic论文《Adding Error Bars to Evals》,避免自定义统计方案带来的争议。
整套实验持续30天,每日跑一轮;第1–10天作为基线窗口,之后分为两个10天观测窗口,最早可在2026-10-24得到第一个判定结论,20天后产出首批正式结果。
环境需求:Python3.11+、uv、已登录Claude Code(Max订阅,使用claude -p,无需API Key),支持Linux/macOS/Windows。
git clone [https://github.com/ninjahawk/livenerf](https://github.com/ninjahawk/livenerf)
cd livenerf
uv sync
关键:锁定Claude CLI版本,防止CLI更新干扰实验结果
export DISABLE_AUTOUPDATER=1
claude --version | awk '{print $1}' > CLAUDE_CLI_VERSION
可以备份一份固定版本二进制,设置LIVENERF_CLAUDE_CLI指定路径。
实验流程:校准 → 面板设计 → 验证(阳性对照+A/A校验)→ 预注册提交 → 定时每日运行
# 查看Claude Max订阅配额
python -m livenerf.usage
# 校准采样
python -m livenerf.benchmarks.calibrate run --weekly-points 12
# 设计并冻结评估面板
python -m livenerf.design --max-weekly-points 10 --samples-per-day 1 --write
python -m livenerf.design --max-weekly-points 10 --lock
# 验证实验装置
python -m livenerf.validate run --weekly-points 8
python -m livenerf.validate report
# 预检
python -m livenerf.preflight --probe
配置定时任务每日执行整套面板,用量超限会自动跳过并重试。查看结果:
inspect view
python -m livenerf.analysis