BlenderWorld
BlenderWorld把3D智能体评测从“看图好不好看”升级到工程资产完整性检验,重点考核AI智能体在Blender里构建可复用3D场景的能力,而不只是输出一张静态效果图。该基准为3D Agent提供标准化、自动化的测试集,方便团队量化模型在建模、材质、灯光、动画全链路的能力。
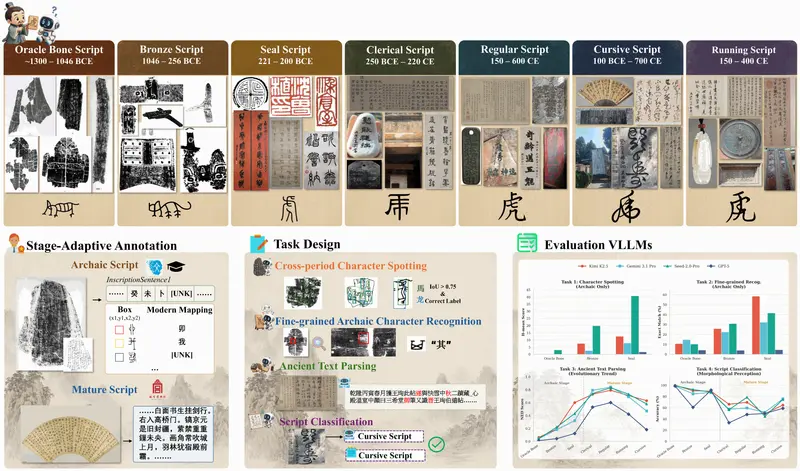
Chronicles-OCR 是首个专为评估视觉语言大模型(VLLMs)跨时域视觉感知能力而设计的综合性基准,覆盖汉字完整的演化轨迹——"汉字七体"。本数据集与安阳师范学院甲骨文信息处理教育部重点实验室及故宫博物院等顶级机构领域专家合作构建,包含 2,800 张严格均衡的图像,涵盖从龟甲到纸本书法在内的高度多样化物理媒介。
 Chronicles-OCR
汉字作为世界上唯一沿用至今的表意文字,其五千余年的演变历程构成了独特的视觉谱系。然而,现有 OCR 基准多聚焦于现代印刷体或手写体,缺乏对甲骨文、金文、篆书等古文字及隶、楷、行、草等成熟书体的系统性评估。Chronicles-OCR 是由腾讯联合安阳师范学院与故宫博物院专家共同打造的跨时域感知基准,旨在全面衡量 AI 模型在“汉字七体”上的识别、检测与解析能力。
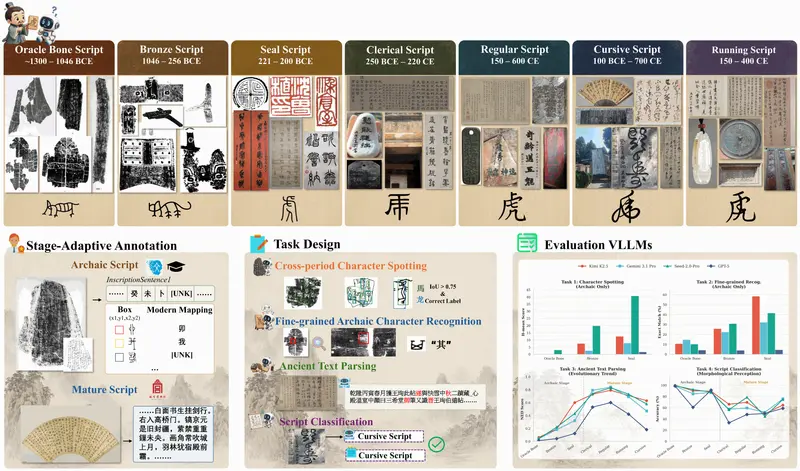
该基准包含 2,800 张高质量标注图像,覆盖从殷商甲骨文到东汉草书的完整演化链条,通过四大评测任务,揭示了当前主流大模型在古文字理解上的巨大潜力与显著短板。数据显示,Kimi K2.5 与 Seed 2.0 Pro 在综合性能上处于领先地位,而开源模型中 Qwen3.5-A17B 表现优异。
| 任务 | 简称 | 适用范围 | 指标 | 考察能力 |
|---|---|---|---|---|
| 跨时期字符检测 | Spotting | 甲骨文、金文、篆书 | F1 @ IoU > 0.75 | 在复杂背景/残损载体中定位古文字 |
| 细粒度古文字识别 | Recognition | 甲骨文、金文、篆书 | 精确匹配准确率 | 准确转录异体字、生僻古字形 |
| 古文本解析 | Parsing | 七种书体全覆盖 | 1 − NED (编辑距离) | 理解整段文字语义,处理连笔/缺省 |
| 书体分类 | Classification | 七种书体全覆盖 | 准确率 | 区分不同历史阶段的字体风格特征 |
git clone https://github.com/VirtualLUOUCAS/Chronicles-OCR.git
cd Chronicles-OCR
pip install -r requirements.txt
将数据集下载并解压至 data/ 目录,结构如下:
data/
├── Chronicles_OCR.jsonl  # 标注文件
└── images/
    ├── 甲骨文/
    ├── 金文/
    ├── 篆书/
    ├── 隶书/
    ├── 楷书/
    ├── 行书/
    └── 草书/
支持 OpenAI 兼容 API 和本地 vLLM 部署:
使用 OpenAI 兼容 API (如 Qwen2.5-VL-7B):
python infer.py --api_type openai_compat \
    --model_name Qwen2.5-VL-7B-Instruct \
    --base_url http://127.0.0.1:8000/v1 \
    --api_key EMPTY \
    --max_workers 64
使用本地 vLLM:
python infer.py --api_type local_vllm \
    --model_path /path/to/Qwen2.5-VL-7B \
    --tensor_parallel_size 1 \
    --max_model_len 32768
# 评测所有已生成结果的模型
python judge.py

# 仅评测指定模型
python judge.py --models Qwen2.5-VL-7B

# 生成 Excel 分析报告
python summarize.py
# 输出: judge_results/results_analysis.xlsx
Chronicles-OCR 不仅是一个基准测试,更是一座连接古代文明与现代 AI 的桥梁。它揭示了当前模型在理解汉字深层结构与历史演变上的真实水平,为下一代多模态大模型的优化指明了方向。