DPAI Arena
DPAI Arena 宣称是业内首款开放式、多语言、多框架和多工作流基准测试平台,旨在衡量 AI 编码智能体在现实世界软件工程任务中的成效。它围绕灵活且基于路径的架构构建而成,能够对各种工作流(例如,修补、bug 修正、PR 审查、测试生成、静态分析等)进行公平、可重现的比较。
10月7日,Nousresearch正式推出Hermes Index大模型评测榜单,和以往侧重单纯推理能力的评测不同,这份榜单同时考核两大维度:性能指数越高越强,单任务成本越低越划算。
 Hermes Index
10月7日,Nousresearch正式推出Hermes Index大模型评测榜单,和以往侧重单纯推理能力的评测不同,这份榜单同时考核两大维度:性能指数越高越强,单任务成本越低越划算。
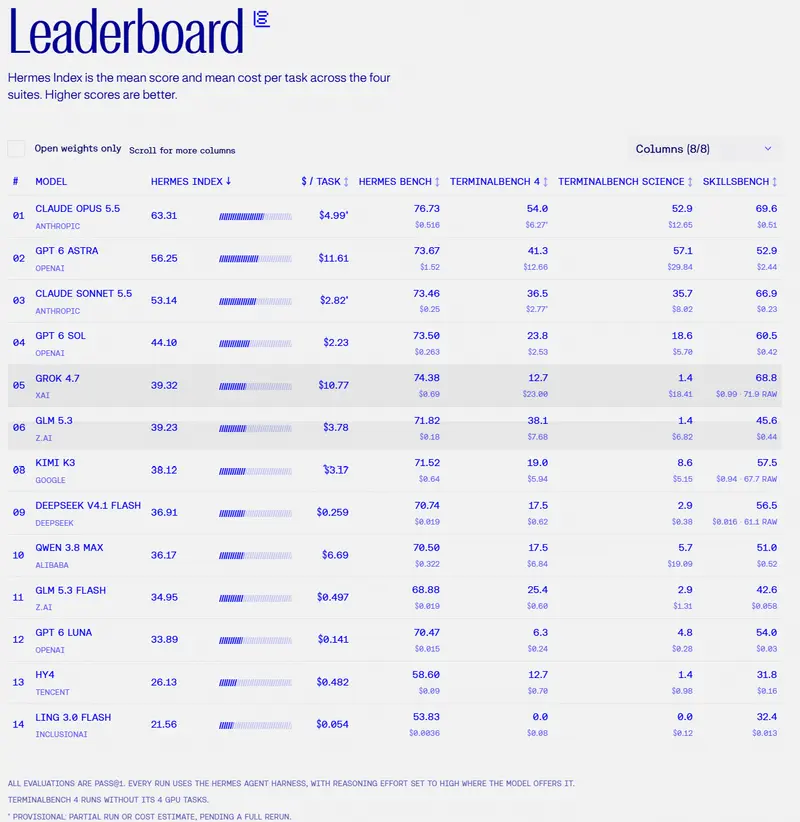
榜单当前性能榜首是Opus 5.5,单任务成本4.99美元;GPT-6 Astra性能位居第二,但单任务成本高达11.61美元,是参评十多款模型里成本最高的。榜单前排主力是Anthropic、OpenAI的模型,国产大模型GLM-5.3拿到第六名,剩余8个上榜席位大多由国产模型包揽。
成本梯队差异非常明显。DeepSeek V4.1 Flash单任务成本仅0.259美元,相比头部闭源模型直接下一个量级。GPT-6 Luna性价比更进一步,单任务成本比DeepSeek V4.1 Flash更低,同时性能差距不大。
蚂蚁Ling 3.0 Flash是这份榜单里单任务成本最低的,低至0.054美元,支持免费调用但存在每日额度限制。而刚发布的Ling 3.1 Flash跑分已经超越DeepSeek V4.1 Flash,官网也开放免费试用周期。
市面上绝大多数大模型评测只关注基准性能,但对于Hermes智能体、OpenCalw这类自动化任务场景,调用成本是不可忽视的关键指标,这也是Nousresearch打造Hermes Index的初衷。
从选型参考来看:预算充足优先选Opus 5.5;成本敏感的国内场景推荐DeepSeek V4.1 Flash;海外场景看重性价比可以选GPT-6 Luna;零成本需求可以尝试Ling系列,Ling 3.0 Flash有每日免费额度,新版Ling 3.1 Flash也有官网免费期。