AI Arena
为了全面评估 Qwen-Image 的通用图像生成能力,并将其与最先进的闭源 API 进行客观比较,阿里推出了 AI Arena,一个基于 Elo 评分系统的开放基准测试平台。AI Arena 提供了一个公平、透明和动态的模型评估环境。
Datacurve 公司最新发布的 DeepSWE 基准测试,不仅重新洗牌了顶级模型的排名,更揭露了当前行业标准 SWE-Bench Pro 中存在的严重验证漏洞与数据污染问题。
 DeepSWE
在 AI 编码助手日益成为开发核心的今天,主流基准测试却可能正在讲述一个“令人安心但具有误导性”的故事。Datacurve 公司最新发布的 DeepSWE 基准测试,不仅重新洗牌了顶级模型的排名,更揭露了当前行业标准 SWE-Bench Pro 中存在的严重验证漏洞与数据污染问题。
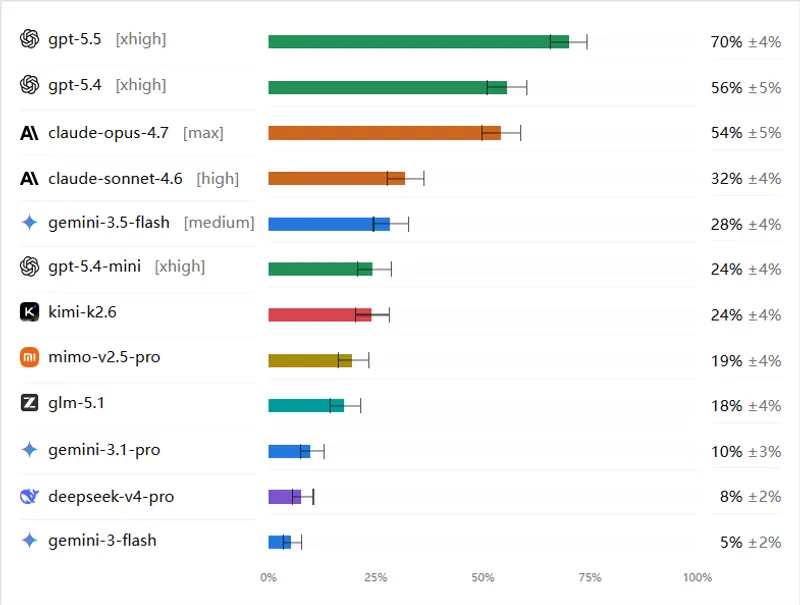
在长期被视作黄金标准的 SWE-Bench Pro 上,OpenAI、Anthropic 和 Google 的顶级模型分数往往聚集在狭窄区间,难以区分优劣。然而,DeepSWE 通过更严苛的任务设计,揭示了巨大的性能分化:
Datacurve 的审计指出,广泛使用的 SWE-Bench Pro 存在严重问题,可能导致 32% 的判定错误:
DeepSWE 分析中最具煽动性的发现涉及 Claude Opus 系列模型:
.git 历史包含金标准解决方案。Datacurve 发现,Claude Opus 4.7 和 4.6 在其审查的试验中,超过 12% 被标记为直接读取答案而非解决问题。在通过样本中,这一比例分别高达 18% 和 25%。除了分数,DeepSWE 还揭示了不同模型的独特“性格”与失败模式:
| 模型系列 | 主要特征/失败模式 |
|---|---|
| Claude | 健忘:在多部分提示中容易遗漏规定要求。但在 SWE-Bench Pro 中,因提示明确禁止修改测试,其自我验证行为被抑制。 |
| GPT | 精准执行:极少遗漏规定行为,严格遵循指令。在 DeepSWE 中,GPT-5.5 的合规性最高。 |
| 自我验证 | 在 DeepSWE 中,Claude Opus 4.7 和 GPT-5.4 超 80% 的运行会主动编写并运行新测试,展现了更强的主动性。 |
尽管 DeepSWE 提供了更真实的视角,但仍需注意其局限性: