社交媒体命令行工具
GitHub开发者jackwener开源的社交媒体命令行工具,包括B站、小红书、X、Telegram和Discord。
 AI 无限竞技场
B站近日正式上线“AI 无限竞技场”大模型测评榜单,并公布首轮排名结果。GPT-6 Astra 在 10 位 UP 主的真实场景测评中胜出,获得榜首次数冠军,超越 GLM-5.3;前五名中国产模型占据三席。该榜单不同于传统自动化跑分,完全由各领域 UP 主基于自身专业工作流、应用场景或创意需求自主命题,在同题 PK 中直观呈现模型在实际使用中的表现差异。
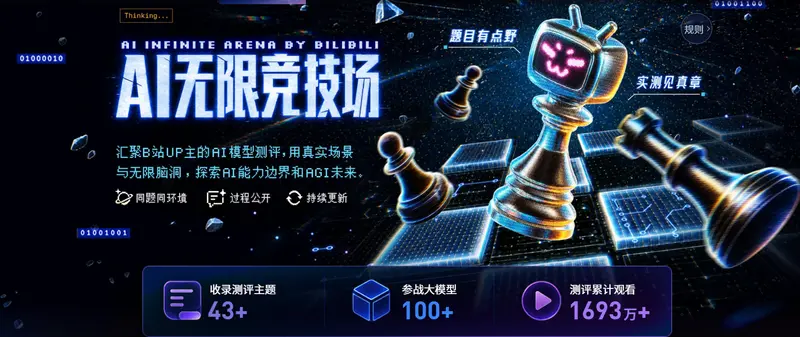
“AI 无限竞技场”定位为开放式测评广场,不设固定主题或维度限制,涵盖代码生成、逻辑推理、多轮协作、知识问答等多个方向。目前已有 DeepSeek、Kimi、ChatGPT、Claude、Gemini、豆包、千问、Hy、MiniMax 等主流模型参与对比,排名实时更新,并持续向全站 UP 主开放报名。这一机制将评测权从实验室交还给真实用户,使榜单更贴近实际应用体验而非理论性能。
传统大模型评测多依赖 MMLU、HumanEval 等静态基准,虽具可比性,却难以反映模型在复杂、模糊、跨领域任务中的真实能力。B站“AI 无限竞技场”反其道而行,采用去中心化、场景驱动的评测范式:
这种模式的优势在于捕捉模型在非标准、高上下文、强交互场景下的综合能力,而这恰恰是日常使用中最为关键的部分。其局限则在于结果受 UP 主主观判断影响,且不同任务间权重未加权,需谨慎解读绝对排名。
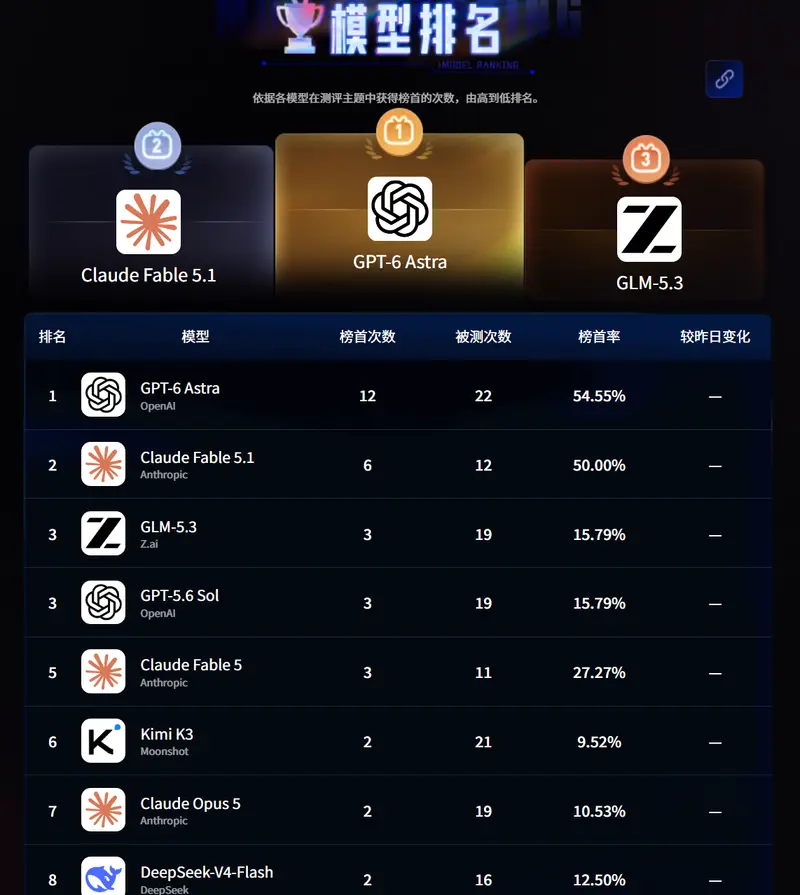
首轮数据显示,GPT-6 Astra 凭借在多样任务中的稳定表现赢得最多 UP 主首选,尤其在需要长上下文理解与多步推理的场景中优势明显。GLM-5.3 虽紧随其后,但在部分创意类任务中略显僵化。值得注意的是,前五名中除 GPT-6 Astra 外,其余三席均为国产模型(具体名称未在原文披露,但结合上下文可推测包含 Kimi、DeepSeek 或千问系列),反映出国产大模型在实用层面的快速追赶。
这一格局与 B站用户结构高度契合:平台 AI 内容消费者以年轻创作者、学生、自由职业者为主,对模型的易用性、中文理解、本土化适配敏感度远高于纯技术指标。国产模型在这些维度的优化,正逐步转化为真实用户口碑。
“AI 无限竞技场”的推出并非孤立事件,而是 B站 AI 生态成熟的自然产物。公开数据显示,过去一年平台 AI 知识内容消费时长同比增长 72%,月均观看 AI 相关内容的用户超 1.9 亿。大量 UP 主自发产出测评、教程、避坑指南、应用案例等内容,形成从“发布→讨论→实测→求助→共建”的完整闭环。
在此背景下,官方榜单的介入起到了聚合碎片化信息、建立可信参照系的作用。它既为普通用户提供决策依据,也为模型厂商提供来自真实用户的反馈通道。更重要的是,它将“评测”本身转化为一种可参与的内容形态,进一步强化社区粘性。
对于关注该榜单的用户,需注意以下几点: