LMArena
Chatbot Arena是一个开放平台,专注于通过人类偏好评估大型语言模型(LLMs)的性能。该平台由加州大学伯克利分校的SkyLab和LMSYS研究团队开发,旨在为LLMs提供一个公正、透明的评估环境。
 OmniParseBench
Datalab推出OmniParseBench,面向文档OCR与解析器的开源评测基准。整套基准包含2343份文档、2937页素材,拆分为16288个通过/失败二元测试用例,覆盖92种语言,数据集与评估代码全部公开。它的设计目标不只是简单的排行榜,而是让开发者能够按文档类型切片评估,回答“解析器能不能处理我这类文档”。Datalab自家解析器Datalab accurate综合得分92.7,位列第二,第一名是Gemini 3.8 Flash(92.9)。
OmniParseBench是评估工具集(harness),并非OCR模型。安装命令uv pip install omni-parse-bench,要求Python3.11及以上;评分环节完全离线、不需要API密钥,仅在调用各家厂商解析器时需要对应服务商密钥。
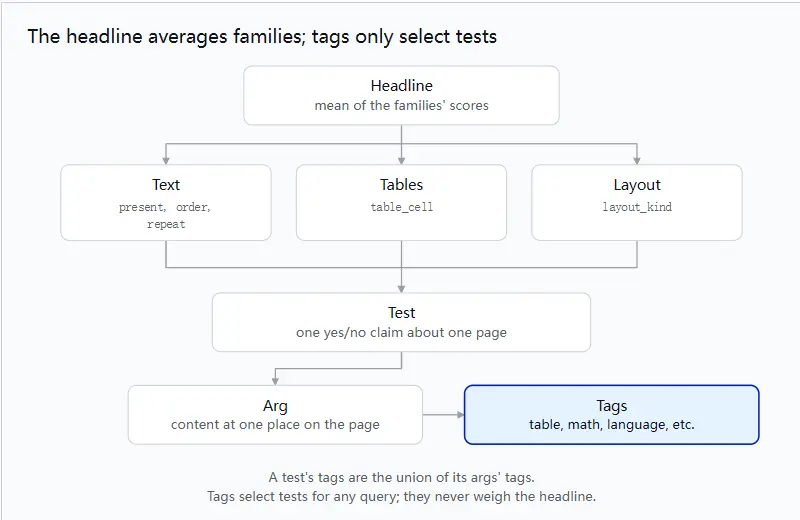
总分由文本、表格、布局三类得分取平均,包含5类测试:
数字匹配支持千分位逗号忽略,公式采用KaTeX渲染比对;判定结果分为通过、失败、不支持、错误,后两类不计入得分,全程没有大模型充当裁判,打分逻辑完全开源。每个测试项附带结构、渲染、角色、文字、语言多维度标签,可按标签筛选子集单独统计分数,标签不会干预判定结果。
| 解析器 | 综合得分 | 文本 | 表格 | 布局 |
|---|---|---|---|---|
| Gemini 3.8 Flash* | 92.9 | 91.3 | 95.2 | 92.2 |
| Datalab accurate | 92.7 | 90.8 | 91.8 | 95.6 |
| Datalab balanced | 91.6 | 90.0 | 89.2 | 95.5 |
| Reducto | 90.8 | 85.4 | 91.2 | 95.8 |
| LlamaParse | 90.4 | 88.2 | 92.6 | 90.4 |
| Mistral OCR | 89.5 | 82.8 | 91.9 | 93.8 |
| Claude Sonnet 5.5* | 88.7 | 93.1 | 95.4 | 77.5 |
| GPT-5.6 Sol | 87.8 | 85.4 | 91.6 | 86.5 |
| Extend | 83.3 | 64.1 | 92.5 | 93.4 |
| Azure | 83.0 | 74.6 | 81.7 | 92.8 |
| Tesseract | 无 | 17.6 | 0.0 | 不支持 |
*部分测试用例的构建与验证用到该模型
亮点分项:Claude Sonnet 5.5文本、表格单项最高分;Reducto布局单项第一,但Claude布局得分偏低拖累综合成绩。基准同时还统计各解析器的延迟与每页成本。
| 特性 | OmniParseBench | olmOCR-bench | ParseBench | OmniDocBench |
|---|---|---|---|---|
| 维护方 | Datalab | Ai2 | LlamaIndex | OpenDataLab |
| 规模 | 16288测试,2937页,2343文档 | 7010测试,1403 PDF | 169011规则,2078页 | 1651 PDF页 |
| 语言覆盖 | 92种 | 英语 | 未披露 | 5类语言 |
| 评分机制 | 通过/失败,三项均值 | 通过/失败单元测试 | 5个独立维度,指标不统一 | 编辑距离、TEDS、CDM复合指标 |
| 模型裁判 | 无 | 不参与打分 | 默认无 | 不参与打分 |
| 额外指标 | 延迟、每页成本 | 未提供 | 每页价格 | 未披露 |
| 许可 | 代码Apache2.0;测试CC BY4.0 | ODC-BY 1.0 | Apache2.0 | 代码Apache2.0,仅限研究 |
Datalab指出现有基准缺陷:olmOCR-bench趋于饱和,高分模型差异更多来自输出规范而非阅读能力;ParseBench多维度指标单位不一致,难以合并对比。