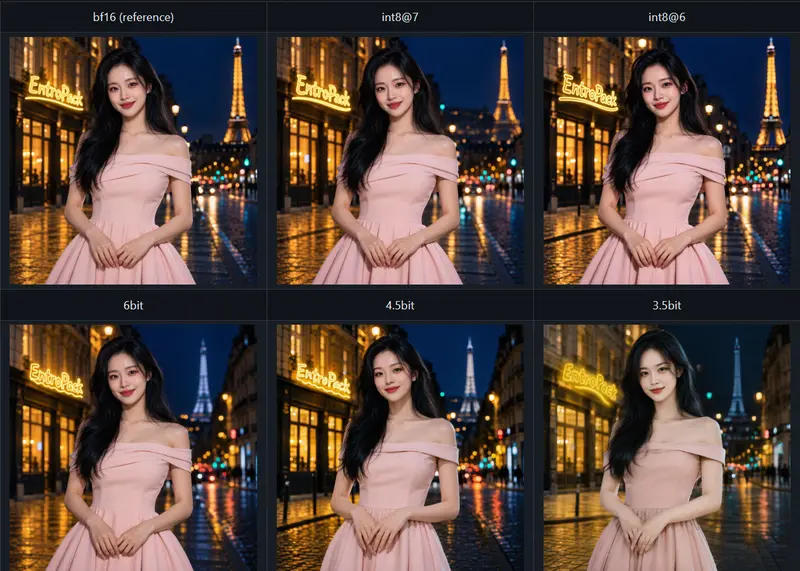
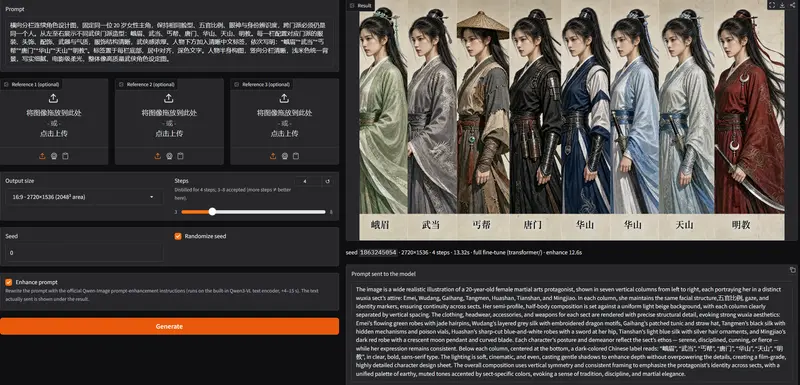
MOSS-Image-EntroPack 阿里DiffSynth-Studio项目组放出MOSS-Image(Base、SFT版本)的EntroPack预量化权重,基于EntroPack熵编码方案从原版BF16权重转换而来,最低仅需4GB显存就能跑,可在DiffSynth-Studio、DiffSynth-ComfyUI加载使用。
MiniMax-H3-x-Z-Image-native MiniMax-H3-x-Z-Image-native 是一个将 Z-Image 强大的空间注意力特征移植到 MiniMax H3 引擎上的 ComfyUI 原生版本。该模型旨在通过增强场景的丰富度与纹理细节,同时保持 H3 原有的身份一致性,解决传统视频生成中常见的“逐镜头锐化偏移”问题。
Kreamagine Kreamagine 是一款基于 Krea-2-Turbo(12.9B 单流 DiT)进行风格适配的微调模型。它保留了基础模型 8 步生成的极速特性,但通过引入 Grok Imagine v0.9/v1.0 的数据集进行训练,显著增强了光照表现力与细节密度。
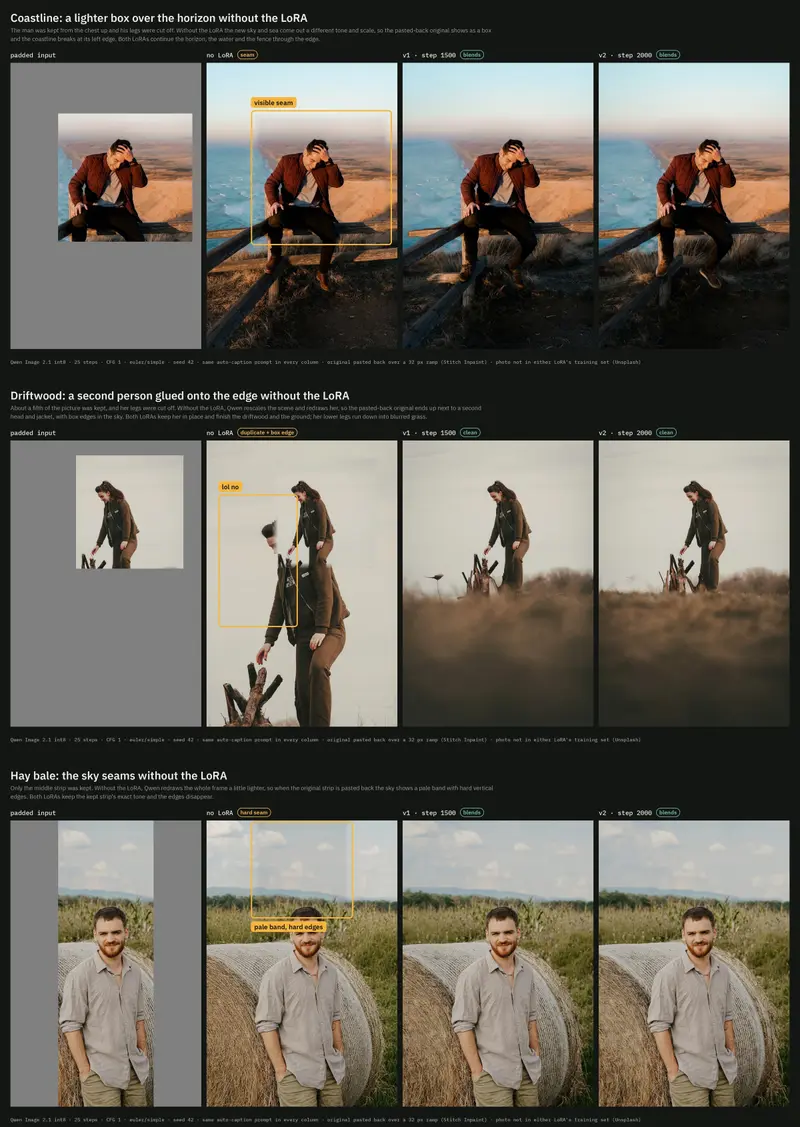
Qwen Image 2.1 Outpaint LoRA Qwen Image 2.1 Outpaint LoRA 是专为通义Qwen Image 2.1打造的外绘(Outpaint)LoRA,核心解决原生Qwen Image 2.1扩图时原图容易移位、重新构图的痛点。
Aether Blast Aether Blast 提供了一种高效、可控的方式来生成高质量、大尺度的冲击波动态效果,特别适合需要环境级视觉震撼的创作者。无论你是制作短片、游戏过场动画,还是探索 AI 视频艺术表达,这个 LoRA 都能帮助你快速实现“毁天灭地”的视觉构想。
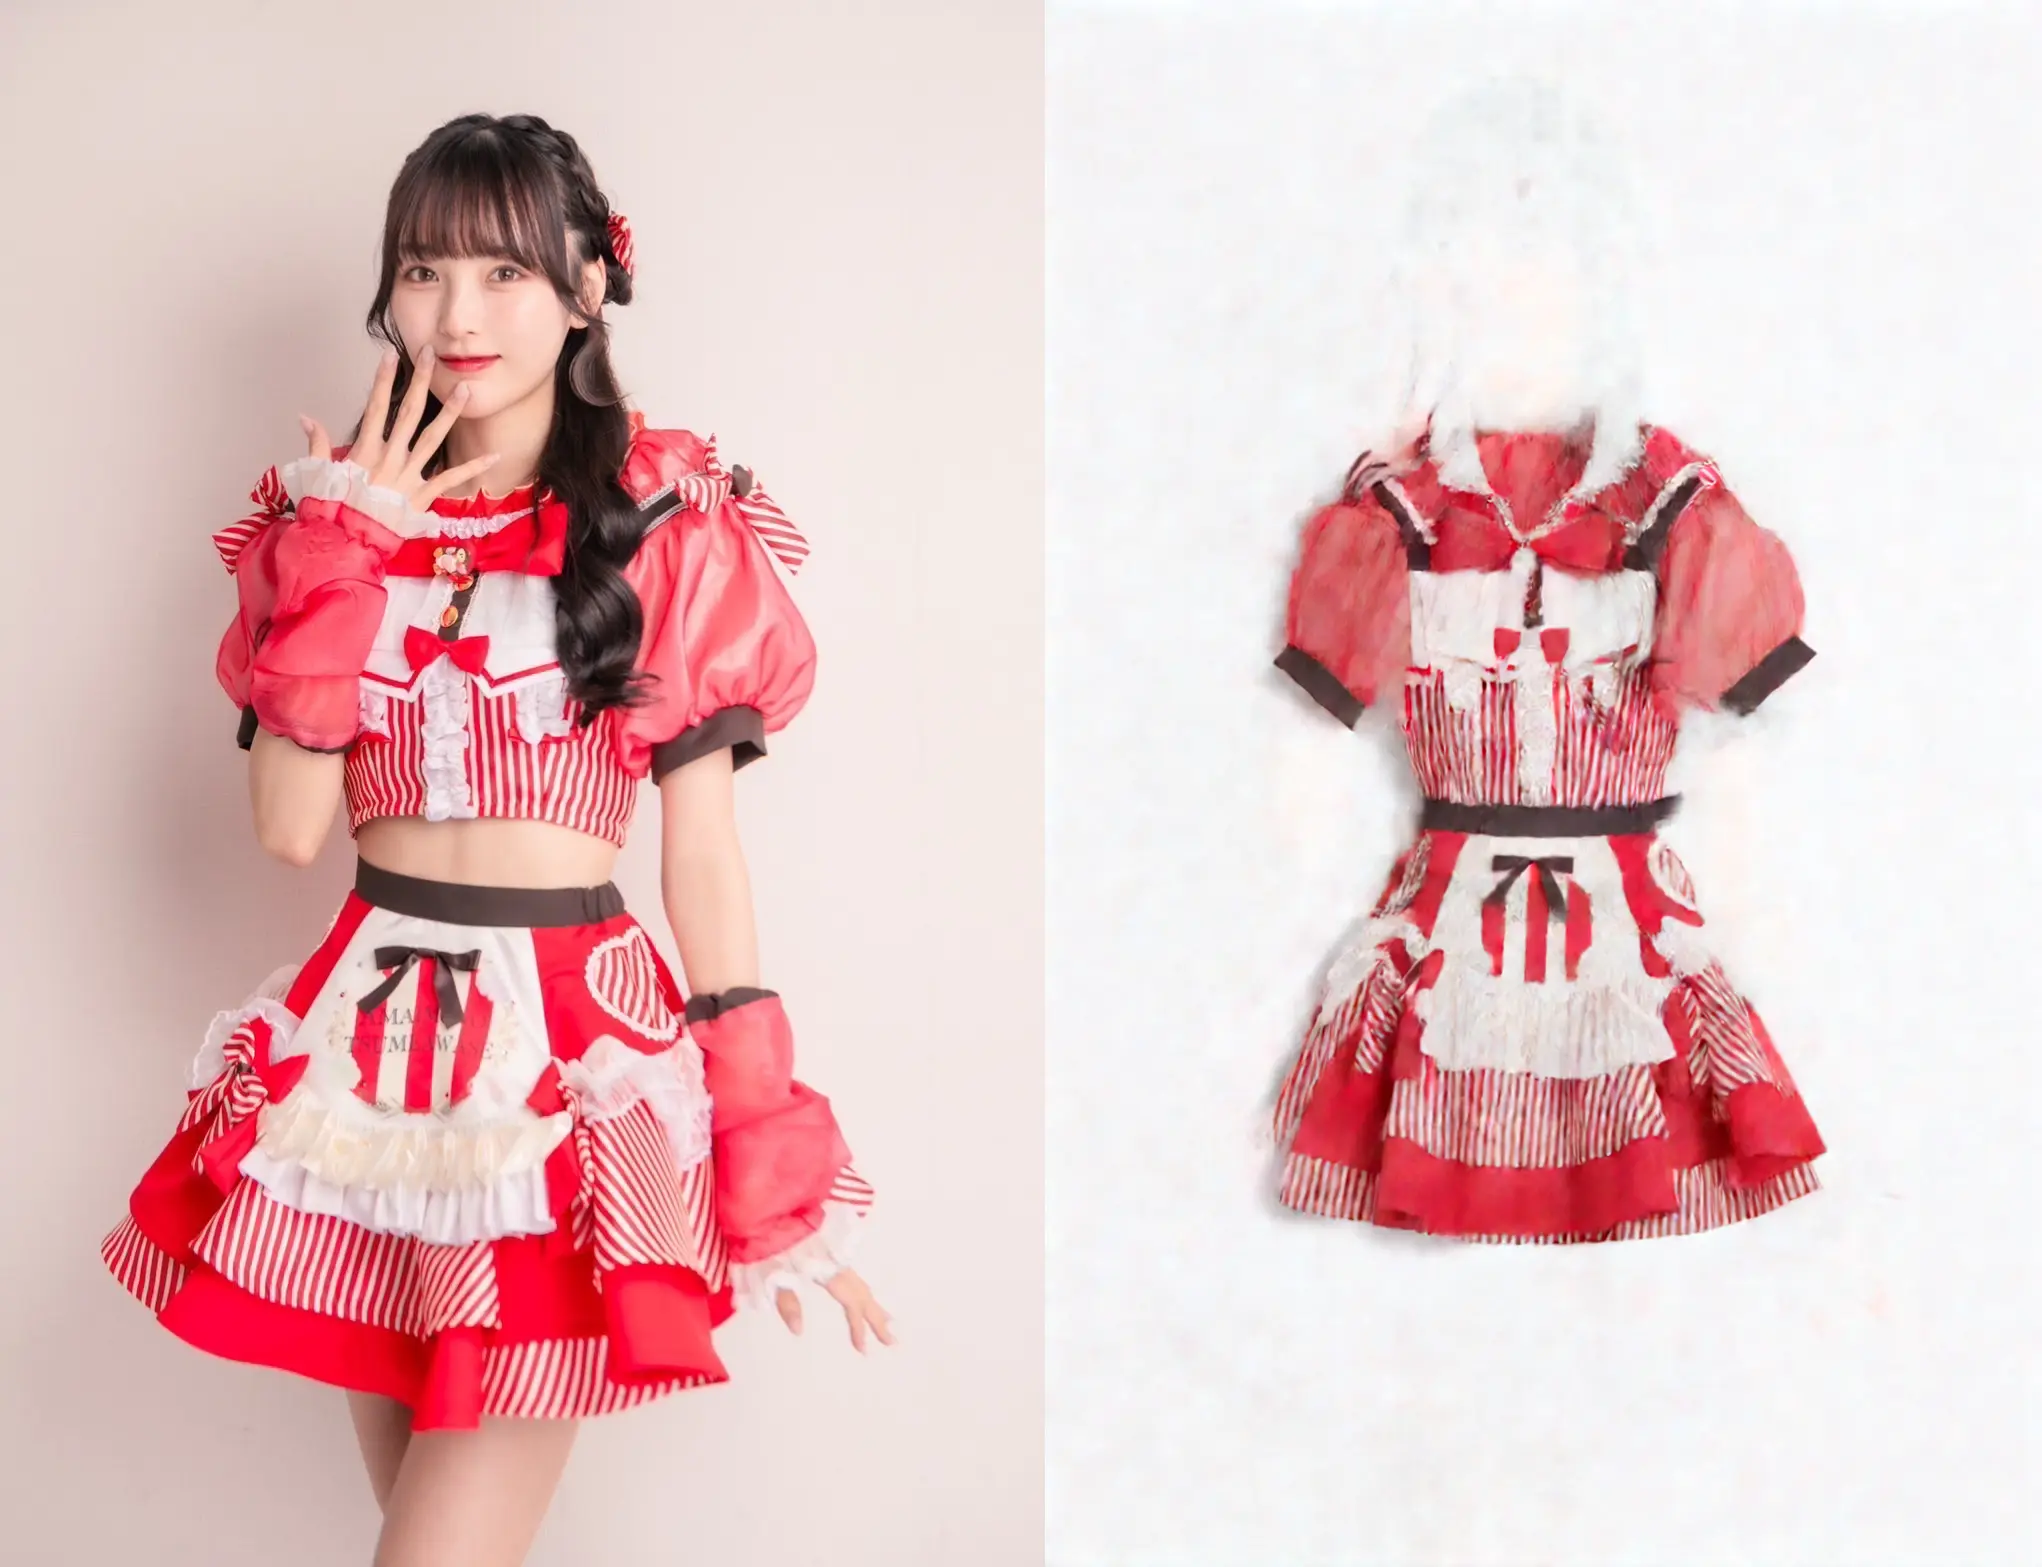
Outfit Extractor Outfit Extractor 是一个针对性极强的工具型 LoRA,填补了当前 AI 时尚应用中“高质量衣物素材获取”的空白。虽然它并非必需,但对于追求精确控制和专业级输出的用户而言,它提供了一条更干净、更可控的编辑路径。
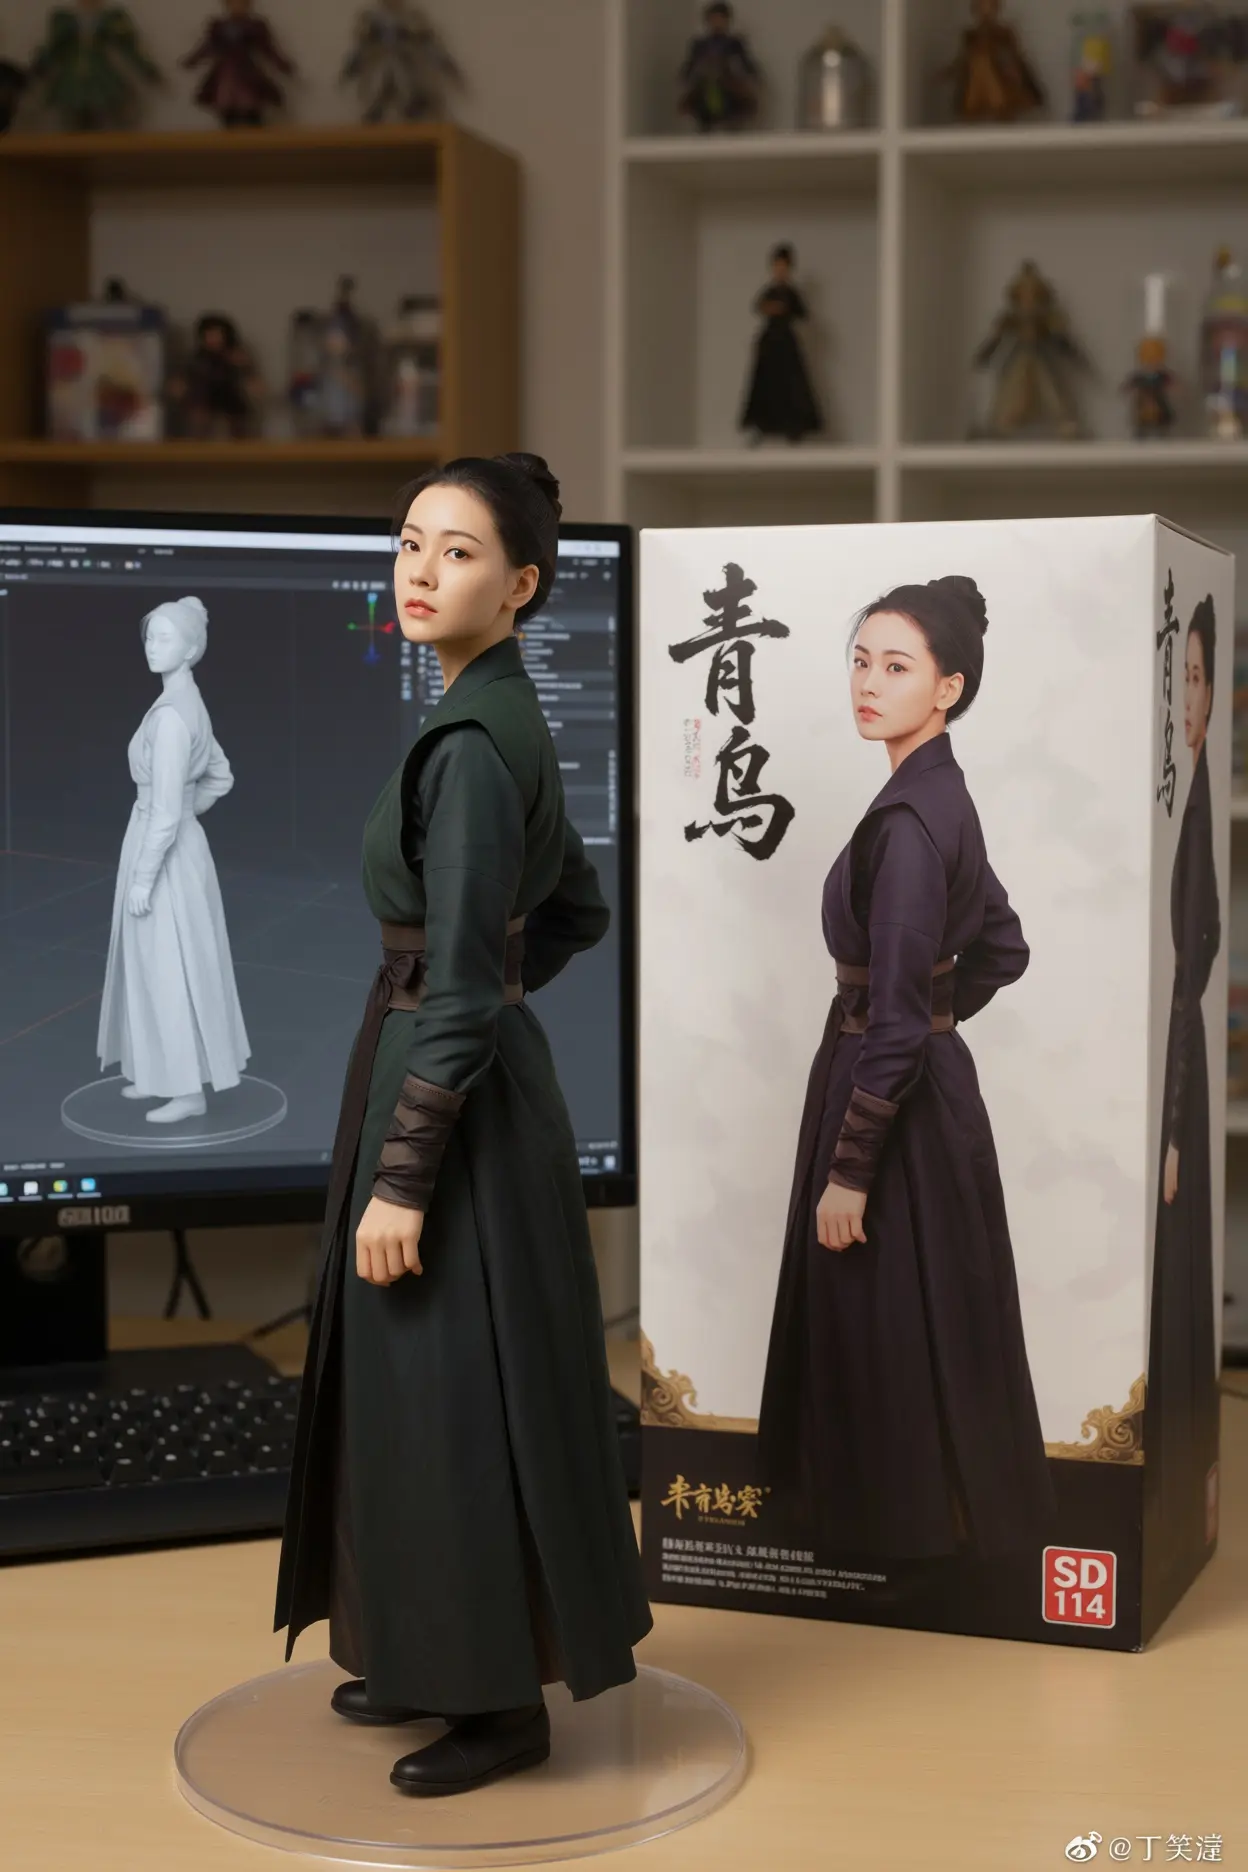
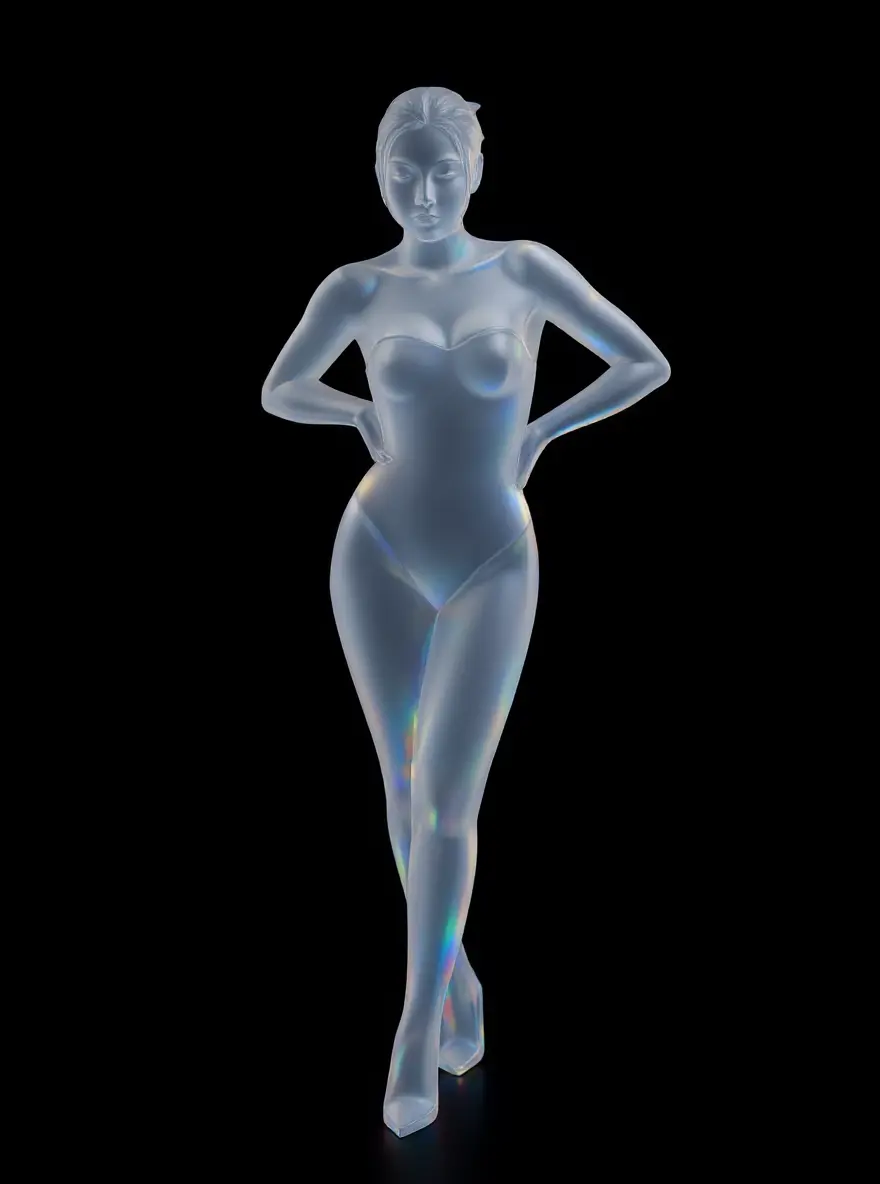
Qwen Edit Figure Maker wen Edit Figure Maker由模型训练者 aldniki217 基于 Qwen Image Edit 模型微调训练的 LoRA,灵感源自谷歌 Nano Banana模型的“真实手办”玩法,但更稳定、更可控、更支持中文。
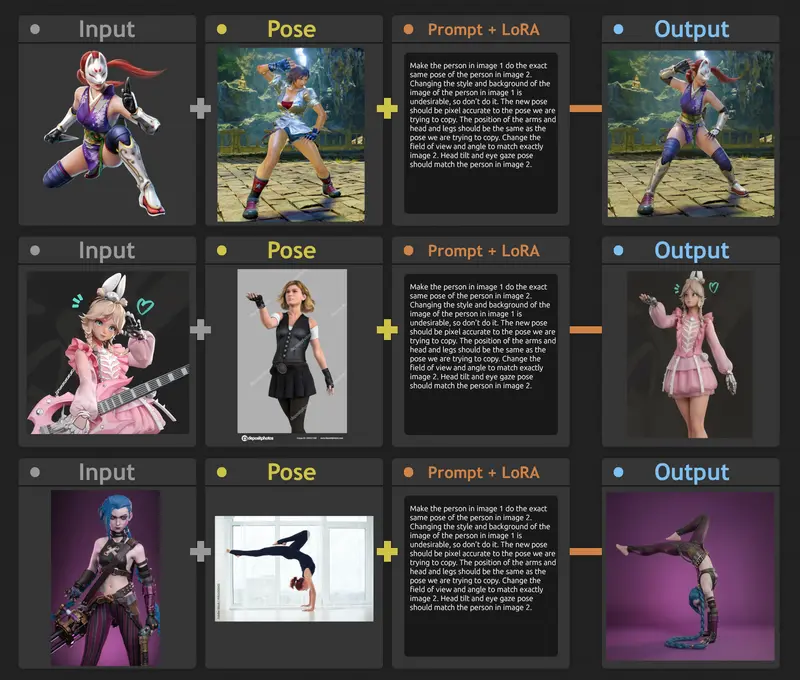
AnyPose AnyPose专为 Qwen Image Edit 2511 Lightning LoRA 设计,无需 ControlNet,无需骨骼图,仅凭一张参考图 + 简单提示词,即可让目标角色精准复刻任意姿势。
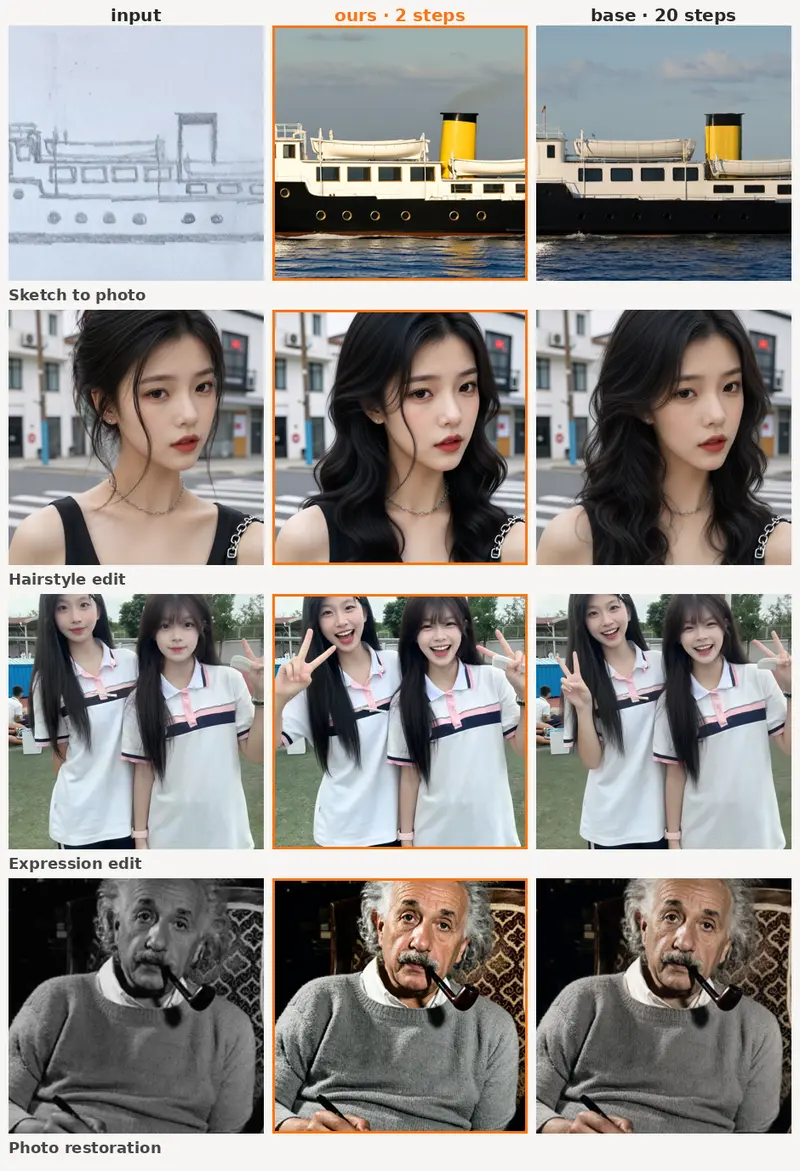
Qwen-Image-2.1-DMD2-2steps DMD2 蒸馏 LoRA 给 Qwen-Image-2.1 做两步加速,仅注意力层微调;在大幅减少采样步数的前提下,文生图和图像编辑效果贴近原版 20 步模型,主打交互式实时绘图。
Nunchaku-Qwen-Image-EDIT-2511/Nunchaku-Qwen-Image-2512 官方 Nunchaku 推理引擎 本以高效量化著称,能显著降低显存占用,但近期对阿里新发布的 Qwen-Image-2512 和 Qwen-Image-EDIT-2511 尚未提供官方支持。 好消息是:社区开发者 QuantFunc 已率先完成量化适配,并发布了两个系列的 4-bit 模型,现已可在 ComfyUI 中直接使用。
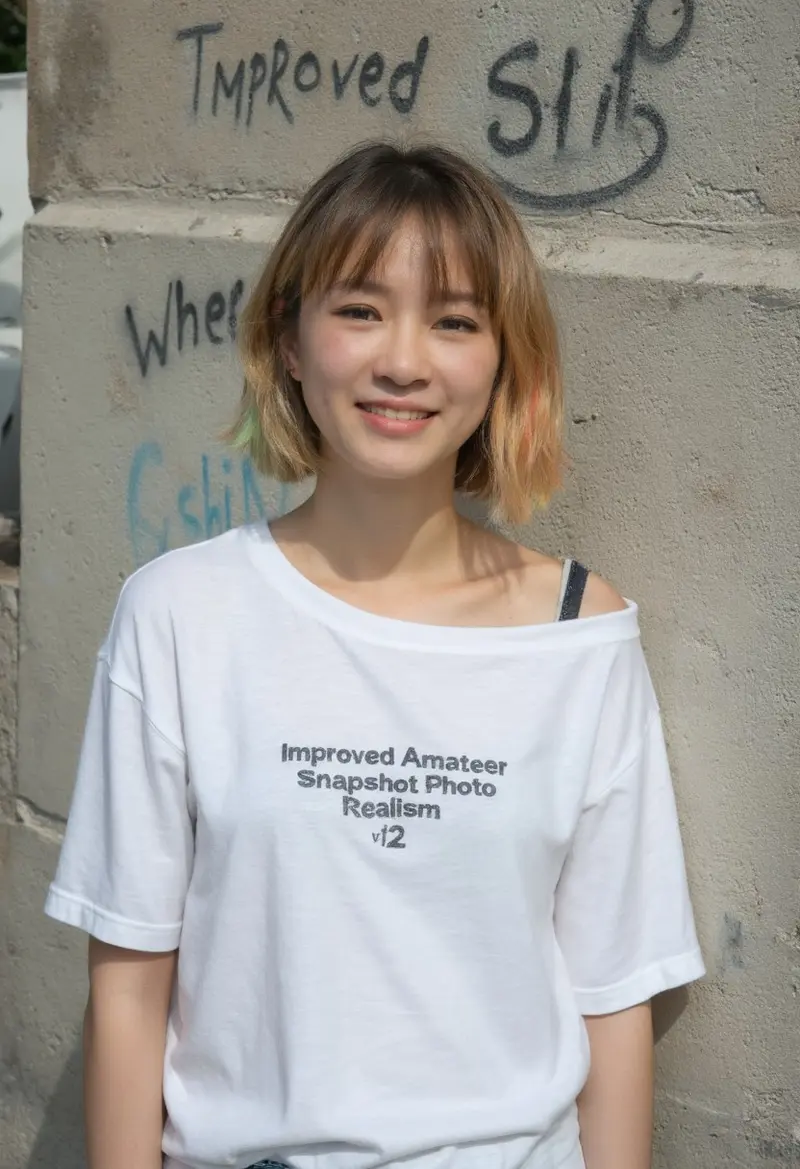
Improved Amateur Snapshot Photo Realism 此Lora旨在生成更“真实”且更少“FLUX 风格”的图像。该模型通过优化自然光和人造光的表现、减少散景强度、为图像的每个部分(如皮肤、眼睛、头发和树叶)添加更多细节。
Qwen-Image-2.1-viggle-turbo Viggle 发布 Qwen-Image-2.1-viggle-turbo(v0.1 预览版),基于 Qwen-Image-2.1 做分布匹配蒸馏得到学生模型。原生只需要4 次 Transformer 传递,而非原版 40 步,无需无分类器引导,支持文生图,以及带 1~3 张参考图的指令式图像编辑。
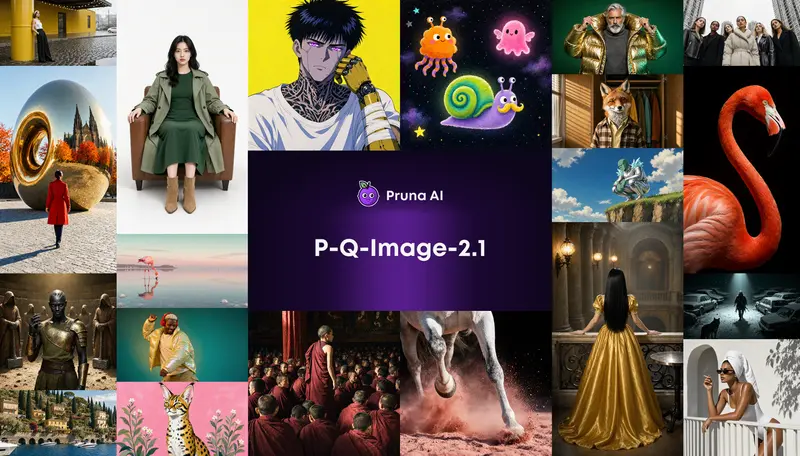
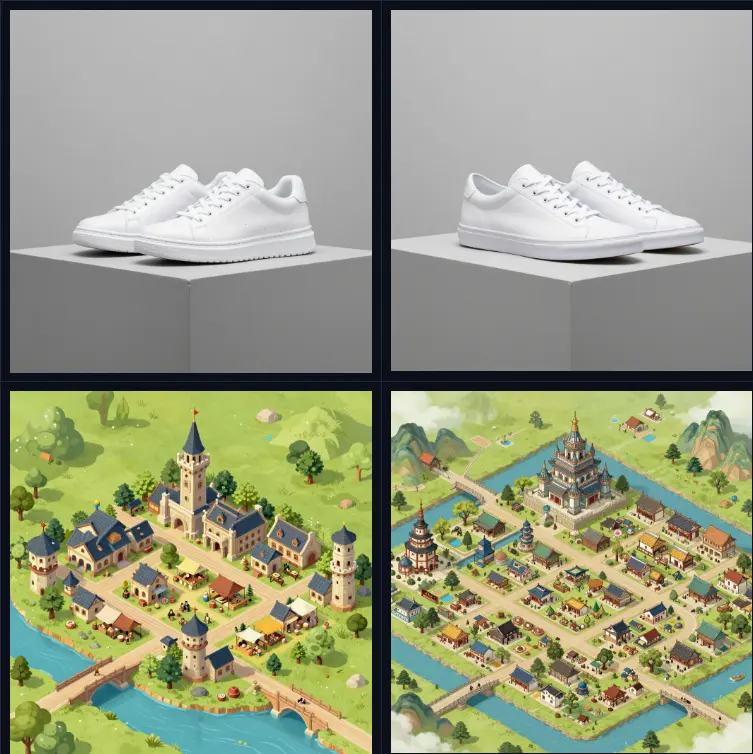
P-Q-Image-2.1 P-Q-Image-2.1 是 PrunaAI 针对 Qwen-Image-2.1 开发的少步蒸馏LoRA适配器,挂载在原基础模型之上,文本编码器、VAE、主干模型都不需要替换;支持文生图、图像编辑,不使用CFG,最高提速可达6.3倍,适配ComfyUI原生节点,不用自定义节点。
Z-Image-Turbo Student Adapter Z-Image-Turbo Student Adapter 通过一种巧妙的文本编码器蒸馏技术,将原始的 4B 参数编码器替换为更轻量的 1.7B 学生模型加上一个微型适配器。
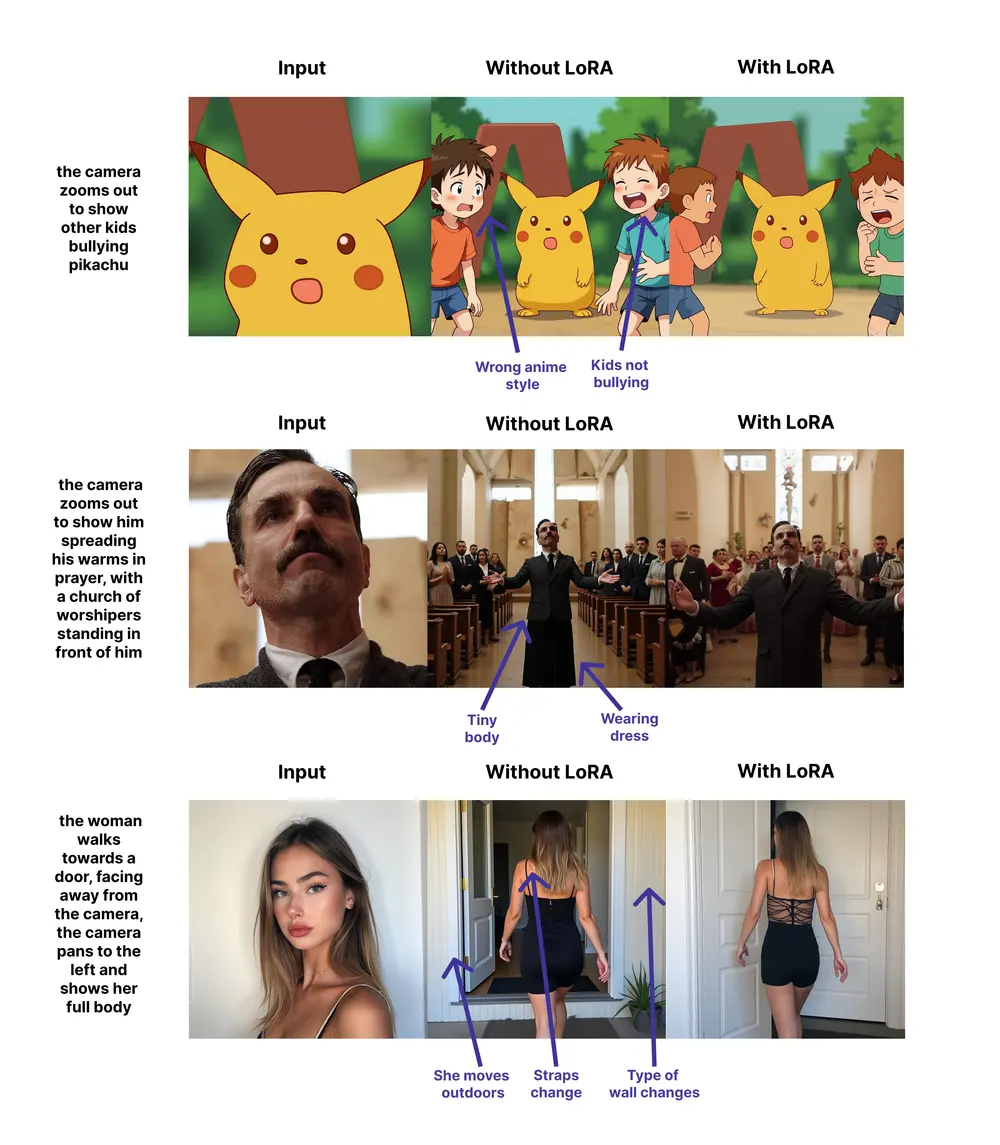
InScene InScene 是一个为 Flux.1-Kontext.dev 设计的 LoRA,旨在生成与源图像保持场景一致性的图像。它基于 Flux.1-Kontext.dev 进行训练。主要用途是生成镜头变体,同时保持背景、整体环境、角色和风格不变。
ClipProj-MiniMax-H3 MiniMax H3 的视频生成能力很强,但它的文本编码器(Qwen3-VL-32B)是个“显存杀手”,光这一项就要吃掉 15.7 GB 显存。ClipProj 提供了一个巧妙的解决方案:通过一个学习到的线性投影矩阵,让只有 40 亿参数的 Qwen3-VL-4B 也能产出符合 H3 要求的条件控制张量。