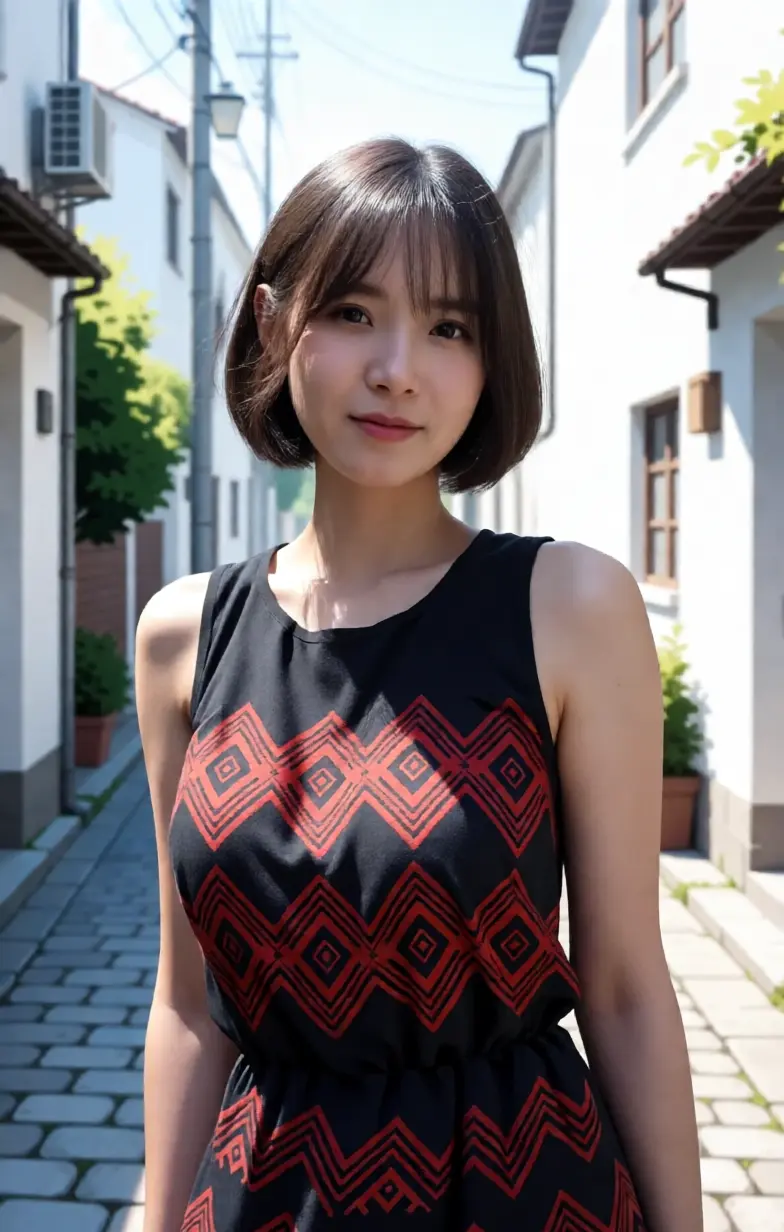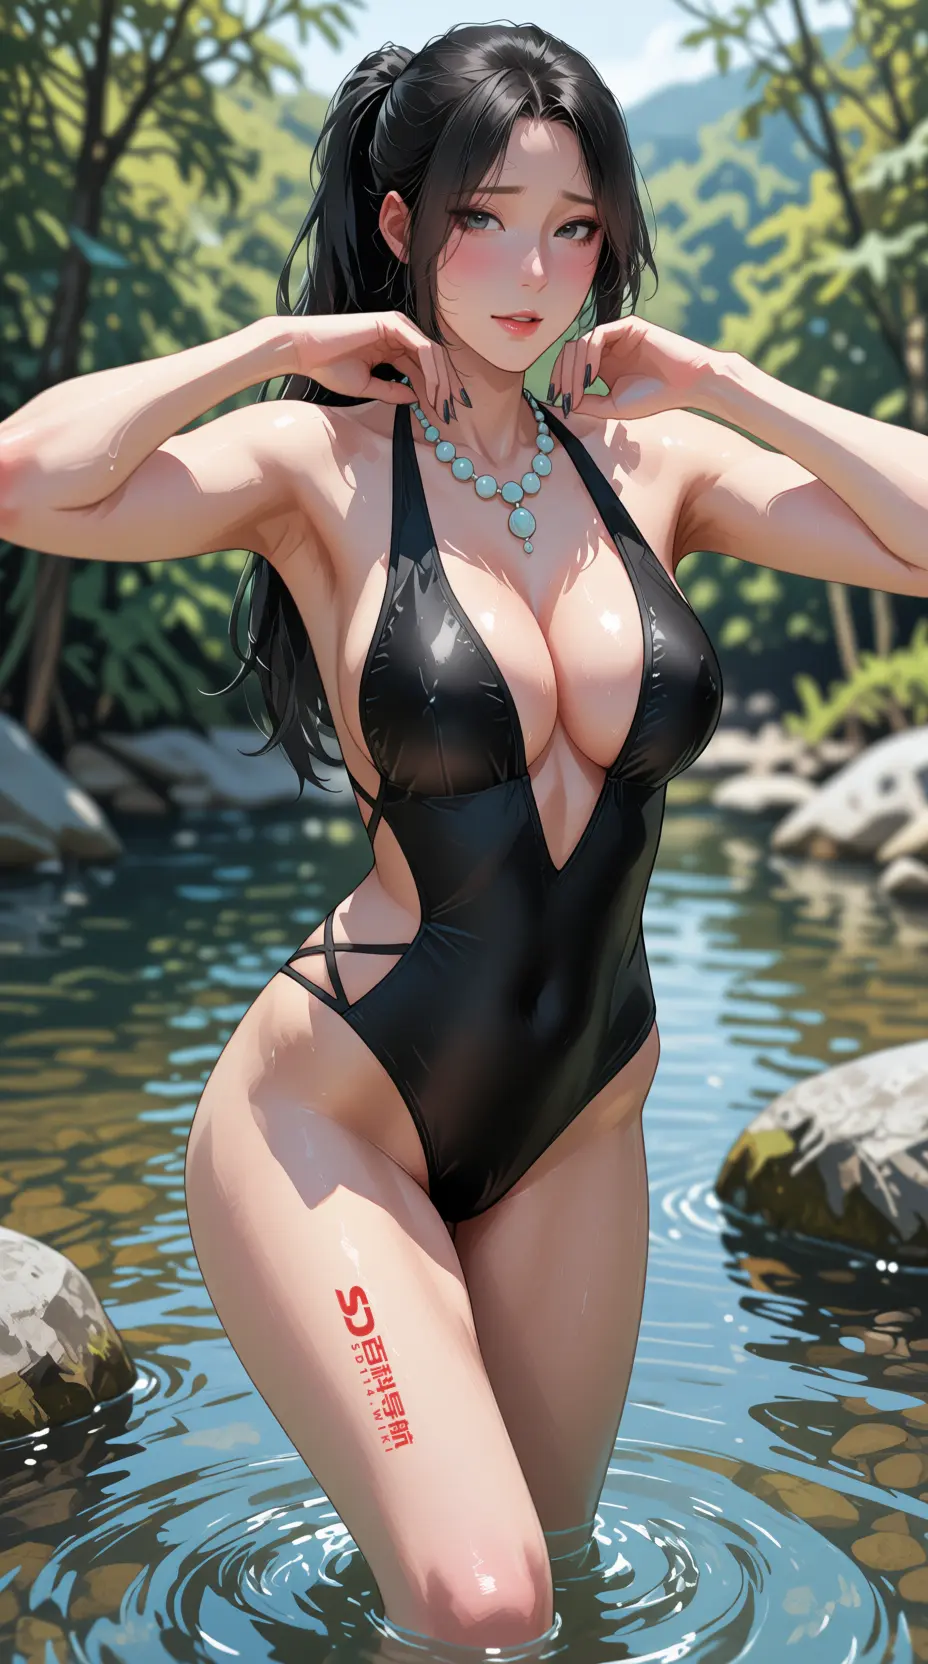
Qwen-Image-2512-Turbo-LoRA-2-Steps
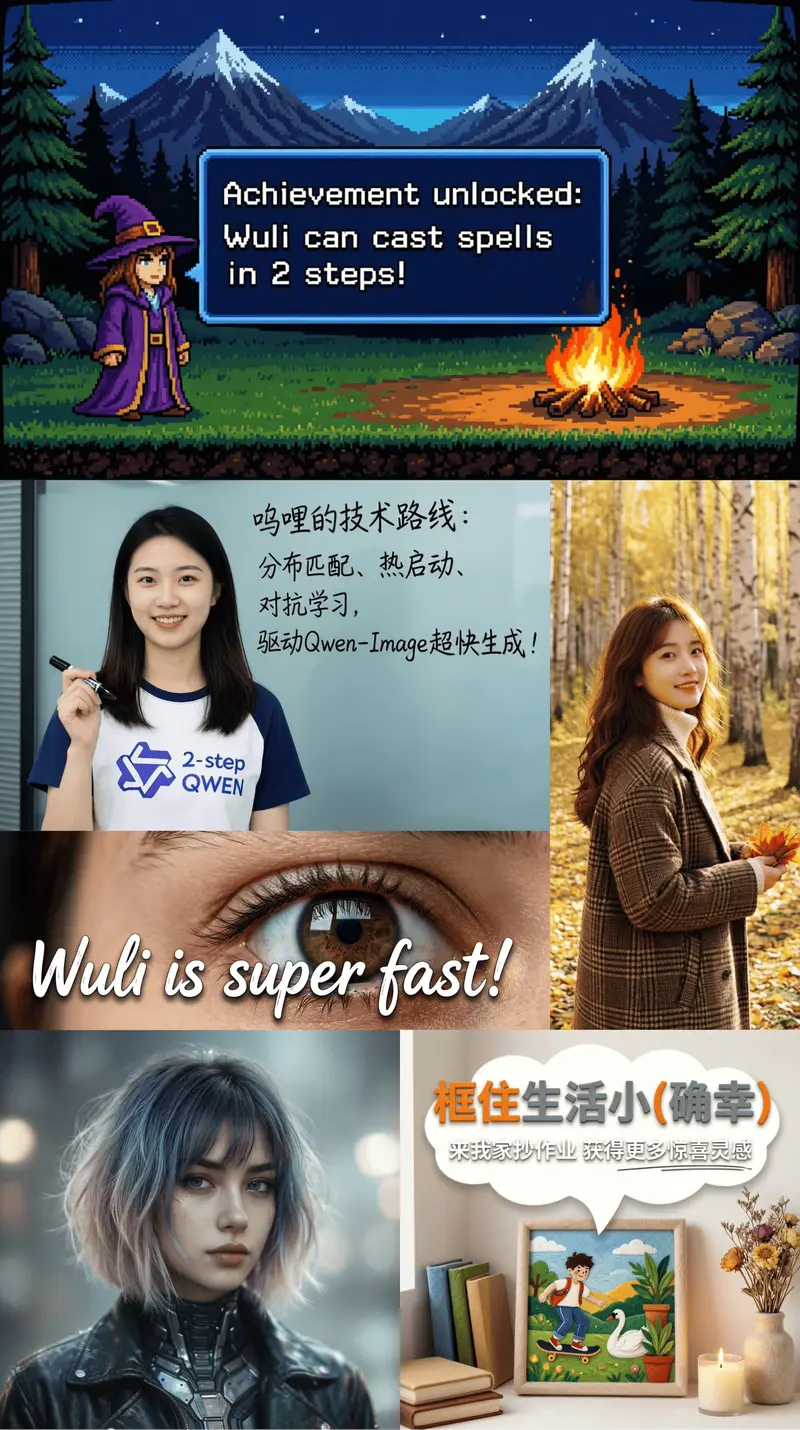
由 Wuli 团队训练的 两步加速版 LoRA,适用于 Qwen Image 2512,相比Wuli 之前的 四步加速版 LoRA 有所改进。
Viggle 发布 Qwen-Image-2.1-viggle-turbo(v0.1 预览版),基于 Qwen-Image-2.1 做分布匹配蒸馏得到学生模型。原生只需要4 次 Transformer 传递,而非原版 40 步,无需无分类器引导,支持文生图,以及带 1~3 张参考图的指令式图像编辑。
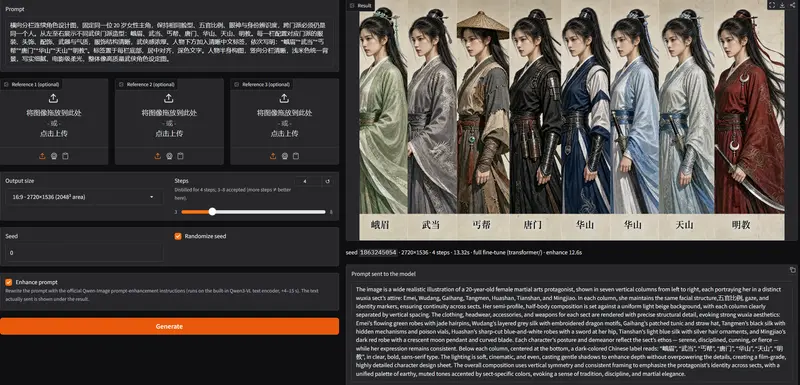
Viggle 发布 Qwen-Image-2.1-viggle-turbo,一个基于分布匹配蒸馏(DMD)的 4 步推理学生模型,旨在将 Qwen/Qwen-Image-2.1 的 40 步生成压缩至仅 4 次 transformer 传递。当前为 v0.1 预览版,明确声明整体性能仍不及基础模型:文本到图像(T2I)基本可用,但在多参考构图、换脸、身份保持等复杂编辑任务上显著退化。提供两种权重形式:完整微调 transformer(14.2 GB bf16,推荐)与 LoRA 适配器(340 MB r64,稍弱)。项目处于活跃开发中,后续将随蒸馏改进持续更新。
| 类型 | 大小 | 精度 | 优势 | 劣势 |
|---|---|---|---|---|
| 完整微调 transformer | 14.2 GB | bf16 | 编辑更忠实,演示默认使用 | 下载体积大 |
| LoRA (r64) | 340 MB | bf16 (运行时加载) | 轻量,易部署 | 编辑质量略低 |
⚠️ 关键提醒:LoRA 不可合并至基础 transformer(bf16 合并有损),必须运行时动态加载。
训练覆盖三类面积基准,所有尺寸四舍五入至 32 倍数:
支持 1:1 / 4:3 / 3:4 / 16:9 / 9:16 / 3:2 / 2:3 七种宽高比,参考图像统一以 1024² 编码。
shift_terminal: null✅ 当前可用场景:
❌ 明确不适用场景:
📌 重要声明:目前仅有定性评估(留出用户请求),无任何定量指标承诺。此版本是预览,非替代品。
transformer/ 目录下的全量权重