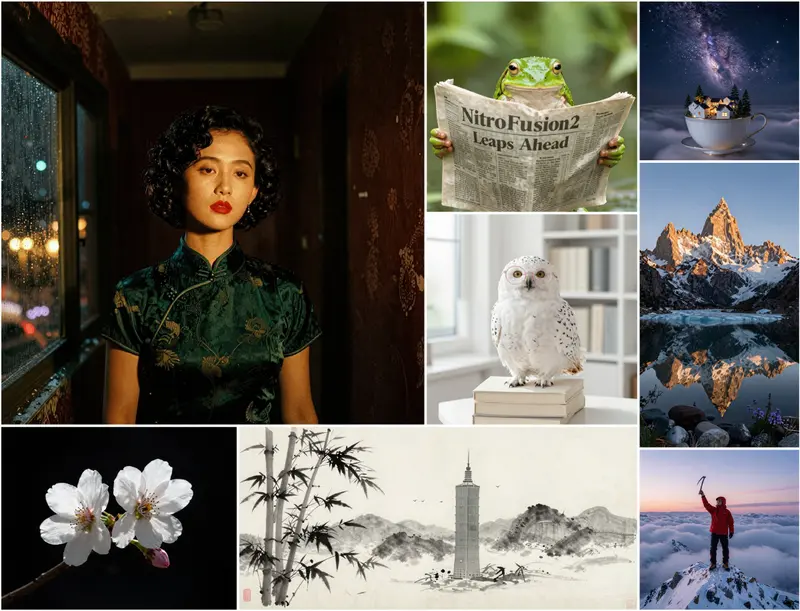
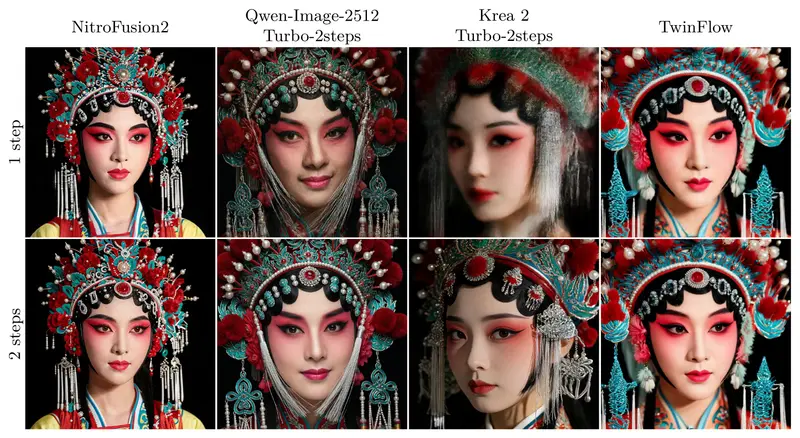
萨里大学与图灵精英实验室的研究团队近期提出了 NitroFusion2,这是一种专为多模态扩散 Transformer(DiT)设计的 1-2 步极速文本到图像生成模型。
- 项目主页:https://chendaryen.github.io/NitroFusion2.github.io/
- GitHub:https://github.com/ChenDarYen/NitroFusion2
- 模型:https://huggingface.co/ChenDY/NitroFusion2
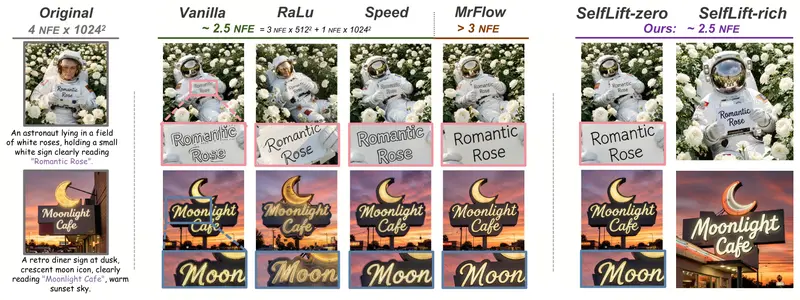
NitroFusion2 依托 Z‑Image‑Turbo 底座开发,主打仅1步或2步即可完成文生图,核心创新是把对抗损失引入 MMDiT 的文本流,搭配特征提示鉴别机制,解决少步数模型普遍存在的图内文字乱码、细节崩坏问题。模型为6B参数量,同一份权重同时支持一步、两步推理,输出1024分辨率图像。
工程资源
配套 ComfyUI 工作流,区分一步、两步版本:
- 1步:
workflows/nitrofusion2_1step.json - 2步:
workflows/nitrofusion2_2step.json
两步推荐搭配去蒸馏LoRA,第一步0.5权重加载,第二步单独跑模型,缓解伪影。
同时发布多档GGUF量化权重,体积从2.0GB(nf2-Q2_K_4XS)到7.2GB(nf2-Q8_0)。
核心创新与技术原理
NitroFusion2 突破了传统对抗蒸馏仅依赖图像像素特征进行评判的局限,引入了两项核心技术:
- 文本流对抗蒸馏 (TSAD, Text-Stream Adversarial Distillation):
在多模态 DiT 中,文本流在联合注意力交互后会吸收画面信息。TSAD 在冻结的预训练大模型文本流中间层接入轻量级评判头,利用这种“已融合画面信息的文本内部状态”作为评判依据。文本流与图像流评判信号相结合,能更高效地指导学生模型在极少步数下学习高质量表征。 - 特征提示鉴别 (ACD, Attribute-Conditioned Discrimination):
无需为不同维度训练多个独立的鉴别器。ACD 将参考图片自动拆解为六大维度(图内文字、物体主体、艺术风格、背景、动作、画面布局)。训练时,通过向冻结的鉴别主干输入特定维度的简短描述,即可动态切换评审的关注焦点,并启用对应维度的专属评判头,针对性地修正生成缺陷,大幅降低了训练成本。
性能表现与量化成果
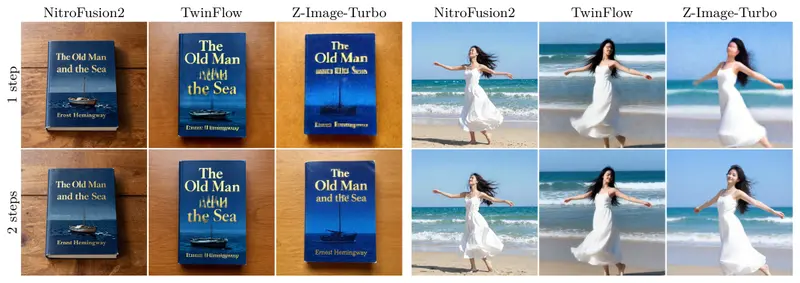
- 一步生成可用:仅需 1 步运算即可输出 1024 分辨率图像,且能清晰渲染中英文字符,保留毛发、枝叶、水面反光等精细细节,文字可读性大幅领先同类少步数竞品。
- 两步生成媲美基线:在 2 步模式下,NitroFusion2 的综合表现(如物体计数、属性匹配)可追平需要多步迭代的原版基线模型,且仅需单套 6B 权重,避免了部分竞品需两套模型导致的参数量翻倍问题。
- 高效训练体系:借助大模型自动构建了十万规模的中英双语多维度拆解标注数据集,并通过消融实验验证了 TSAD 与 ACD 机制的不可或缺性。
已知局限与边界
作为一项科研原型,NitroFusion2 仍存在以下边界:
- 复杂场景受限:在一步生成模式下,面对结构极度复杂的大场景仍容易出现瑕疵。
- 多样性下降:相比多步原版模型,极速生成会导致输出图片的多样性有所降低。
- 维度权衡效应:ACD 机制在强化某一特定维度(如文字)性能时,可能会导致其他维度(如物体或画风)出现小幅损失。
应用场景与行业意义
- 云端 AIGC 降本提速:极少的推理步数可大幅降低单张图片的 GPU 算力消耗,缩短用户等待时间,显著提升云端服务器的并发承载能力。
- 少步数扩散蒸馏新基线:首次证实多模态 DiT 的文本流可作为对抗蒸馏的有效监督信号,为后续图像乃至视频的极速生成研究提供了全新的技术思路与评测参考。
© 版权声明
文章版权归作者所有,未经允许请勿转载。