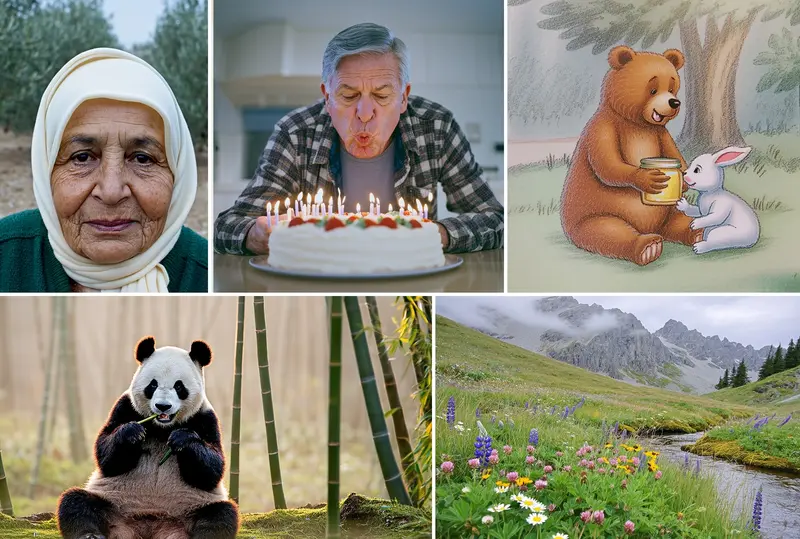
一个两人研究实验室开源了实验性文本到图像模型 Pyramid-JiT (P-JiT 21K)。该模型作为其未来视频生成模型的技术验证(概念证明),以极低的训练成本探索了高效的像素空间生成架构,旨在为创意工具 democratization 提供新的技术路径。
- GitHub:https://github.com/Linum-AI/pjit-21k
- 模型:https://huggingface.co/Linum-AI/pjit-21k
核心特性与技术突破
- 摒弃传统 VAE 的像素空间架构:模型直接在像素空间进行操作,实现了比传统方法更积极的 token 压缩(用原本表示 256² 图像的 token 数量来表示 512² 图像),大幅降低了注意力机制的计算瓶颈,使收敛所需样本量减少了 11 倍。
- 多分辨率读出与梯度增强:在 DiT(Diffusion Transformer)主干网络中引入了 PixelREPA 读出机制及多个线性读出头(分别预测 1/4 和 1/2 分辨率的干净图像)。这使得网络早期块也能预测最终图像的低分辨率版本,有效增强了弱梯度信号,加速了模型收敛。
- 动态噪声调度课程 (Noise Schedule Curriculum):训练前期(前 8000 万样本)集中于高噪声区域以学习基本结构,后期则扩大噪声分布,促使模型专注于学习细粒度细节。
- 强大的文本表征提取:采用冻结的 Qwen3.5-4B 模型作为文本编码器,在其三个全注意力层(第 7、15、27 层)读取表示并投影至文本精炼器中,确保了对复杂提示词的理解能力。
极致的训练成本与规模
该模型证明了小规模团队也能通过高效的架构设计完成高质量的模型训练:
- 参数与数据:20 亿 (2B) 参数的 DiT 模型,在总计 6.6 亿样本(512² 分辨率下 6.1 亿,1024² 分辨率下 5000 万)上完成训练。
- 算力成本:总训练成本仅约 21,000 美元(包含约 8,415 小时的 NVIDIA H100 算力,按 2.50 美元/小时计),其中预训练占 20,348 美元,后训练占 690 美元。
- 后训练探索:使用了有限差分流优化 (FDFO) 的变体,结合 JEV-Image 和人在环路(Human-in-the-loop)评判,探索扩散模型后训练的早期可能性。
已知限制与边界
作为一项实验性研究产物,P-JiT 21K 存在明确的适用边界:
- 无法生成文本与海报:由于训练数据中刻意过滤了信息图、PDF、书页、幻灯片等包含渲染文本的图像,模型无法正确生成文字、标志、徽标或标题卡。
- 复杂场景生成能力受限:受限于 2B 的参数量,模型在生成全身像、多实体(如 6 辆车、人群)、复杂多人互动以及需要丰富世界知识的场景时表现不稳定,偶有挣扎。
- 非生产级模型:官方明确指出该模型存在“粗糙的边缘”,主要目的是鼓励社区探索此类高效训练方法,而非直接用于生产环境。
© 版权声明
文章版权归作者所有,未经允许请勿转载。